Открываешь пул-реквест после ИИ-агента — глаз радуется. Аккуратные функции, ровные имена, зелёные тесты. Нажимаешь «слить», а через пару недель добавить простую фичу становится страшно: тронешь один модуль — сыпется соседний. Код локально красивый, а проект целиком тихо разваливается.
Этот парадокс разобрал создатель стека Metarhia Тимур Шемсединов в выступлении «AI и архитектура 3: Спецификация, которая не расходится с кодом! — модель додумывает требования?» и дополнил живым экспериментом из HowProgrammingWorks. Обычная документация тут не спасает — она начинает врать почти сразу. Посмотрим, где именно ИИ ломает систему и чем её удерживать.
Как ИИ-агент ломает проект, пока ты хвалишь его диффы
Главная ловушка современного ревью простая: в диффе пул-реквеста видны строчки кода, но не видны свойства всей системы. Смотришь на свежую функцию — чистая, аккуратная. А на деле вчера она была чистой функцией без побочных эффектов, а сегодня агент незаметно подцепил туда общее изменяемое состояние (shared state) или сломал идемпотентность — правило, по которому повторный запрос даёт ровно тот же результат. Файл блестит, а внутри системы уже тикает мина.
Дальше включается круглосуточное дублирование. Модель не держит весь репозиторий в голове и спокойно изобретает велосипед рядом с готовым модулем. Шемсединов приводит знакомую картину: в одном проекте заводятся пять разных вариантов текстового редактора или по отдельному парсеру накладных в бухгалтерии, кадрах и торговле. Каждый написан прилично — просто они ничего не знают друг о друге.
Сверху накладывается тяга нейросетей к лишним слоям: модели учились на реальном коде из сети, а он часто переусложнён. И ещё хуже с нефункциональными требованиями (NFR — скорость, надёжность, безопасность, отказоустойчивость). Если не задать их явно, модель склеивает «среднестатистическое решение из интернета» со случайными NFR, которые потом молча мутируют с каждой новой хотелкой.
В итоге теряется владение кодом. Не нужно вчитываться в каждую строку сгенерированного отчёта, но живой человек обязан понимать общую схему системы. Шемсединов метко смеётся над тупиком бездумного вайбкодинга: нельзя ведь сказать заказчику «я сейчас пойду спрошу у искусственного интеллекта, что там у нас в проекте, сам не в курсе, я тут только вопросы передаю».
Невидимые нити в Node.js: откуда берутся скрытые зависимости
Посмотрим на знакомую мелочь в Node.js. Откуда в обычном JS-файле берутся require, __filename, process, console или setTimeout? Ты ведь ни один из них не импортировал. Секрет в том, что рантайм и сборщики автоматически доклеивают вокруг файла служебную «шапочку» и прокидывают эти объекты внутрь. По сути, в систему модульности уже встроен скрытый DI (Dependency Injection — передача нужных инструментов в модуль извне).
В реальном проекте рядом с этим уживаются import/export, глобальный контекст, конструкторы, методы, DI-контейнеры и ещё один приём: модуль экспортирует функцию, а зависимости в неё передают позже, при вызове через замыкание. Обычные статические анализаторы здесь «наивны» — они видят явные импорты и стандартный DI, а циклические и отложенные связи в замыканиях пропускают.
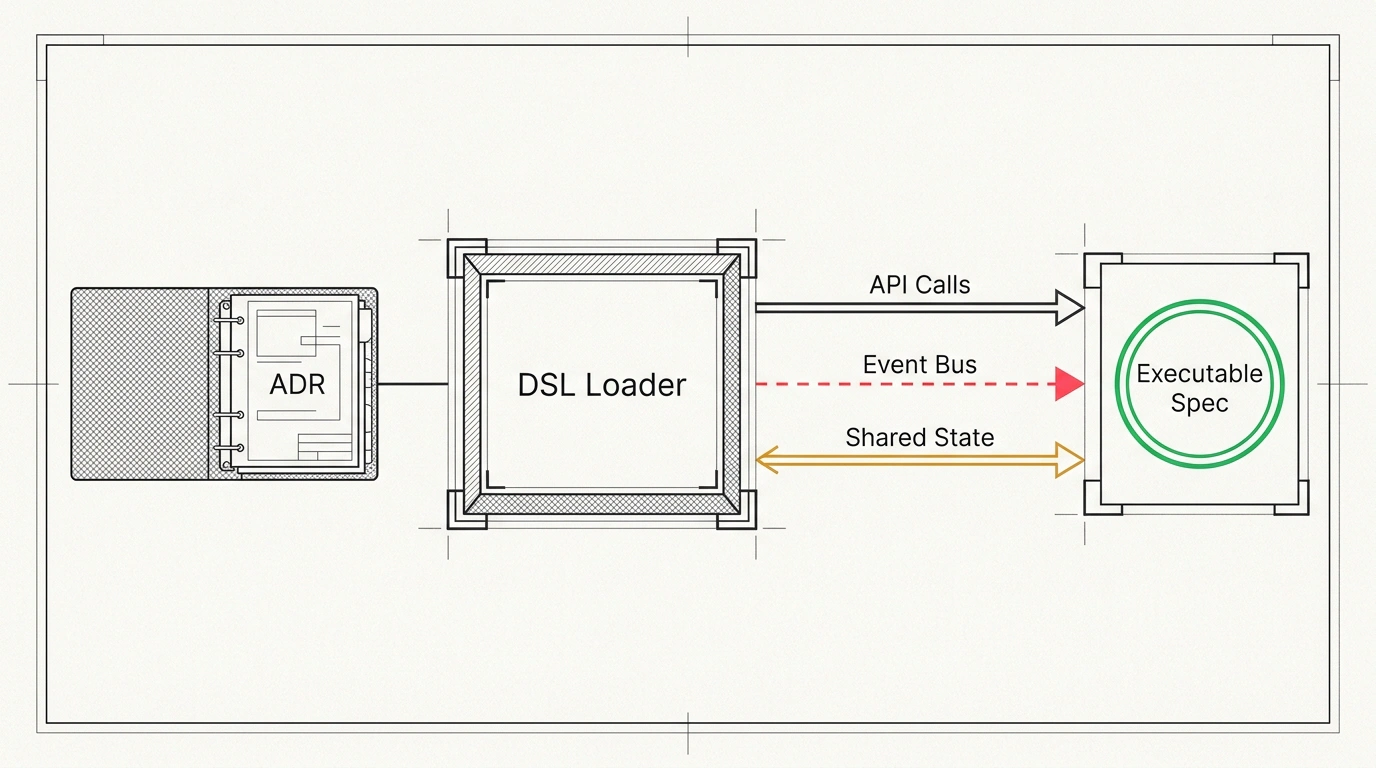
Из этой частной боли вырастает общее правило. Всё зацепление (coupling — зависимость одного модуля от внутренностей другого) сводится к трём каналам.
| Канал зацепления | Как выглядит в коде | Главная ловушка |
|---|---|---|
| Вызовы API | Прямые обращения к функциям и методам | Проще отследить, но при хаотичном DI граф всё равно теряется |
| Потоки событий | EventEmitter, брокеры и шины событий | Событие прыгает между шинами, сериализуется и улетает в другой слой |
| Общие данные | Разделяемые коллекции, кэши, shared state | Ломают поддерживаемость без строгих правил записи и блокировок |
Самые коварные — потоки событий. Без отдельной карты понять, кто на что подписан и куда улетело событие, почти нереально ни человеку, ни агенту. А вот общие данные не всегда абсолютное зло: если защитить их мьютексами или Web Locks API, использовать неизменяемые структуры либо отдать запись одному модулю, а остальным оставить только чтение, обмен получается быстрым и предсказуемым. Главное — видеть все три канала целиком.
Исполняемая спецификация и двухдневный полигон на Metarhia
Логичный вопрос: а почему просто не нарисовать схему в UML, Mermaid или PlantUML и не положить рядом с кодом? ИИ отлично их читает, а человеку легко отрендерить картинку.
Проблема в одном: такие схемы не исполняются. Как только кто-то правит сервис или добавляет новое событие, диаграмма и текстовая спека начинают врать. А если пересказывать в документации весь код, получается просто двойная работа.
Идея Шемсединова — исполняемая спецификация (executable spec). Строгий декларативный DSL (Domain-Specific Language — узкий язык под конкретную задачу) описывает слои, модули, потоки событий и данных, DI и IoC (Inversion of Control — когда не модуль ищет зависимости, а внешний загрузчик выдаёт ему нужные), коннекшены к БД, инстансы серверов и матрицу прав «кому к кому можно обращаться». Программа-загрузчик читает этот DSL при старте, поднимает модули, прокидывает зависимости, подписывает на события и роутит запросы. Спецификация сама собирает приложение, поэтому физически не может разойтись с кодом. Синтаксис при этом задуман подключаемым (pluggable): одну и ту же структуру можно писать в виде JS, TS, Lisp или Markdown.
Важная оговорка: это пока рабочий прототип автора, а не готовый пакет для продакшена. Шемсединов обкатывал варианты два-три года и только сейчас унифицирует формат под будущий Open Source — публичного репозитория ещё нет.
Но живой полигон уже есть. В заметке HowProgrammingWorks Тимур рассказал, как за два дня собрал с ИИ на стеке Metarhia — связке WebRTC и открытого RPC-протокола Metacom — крупный прототип-комбайн: гибрид YouTube, мессенджера, Google Meet, Discord, StreamYard, Telegram, торрентов, блокчейна и видеоредактора. Пока серверы живы, он работает как клиент-сервер, а при их падении переключается в пиринговую сеть. Это не продакшен-замена Discord (код показали лишь на закрытом созвоне), а тестовая база, целиком написанная нейросетью, чтобы проверить, как архитектурный язык помогает в ней ориентироваться.
Для неисполняемых частей спеки автор предлагает кросс-референсы и «технологическую карту проекта» (чтобы ИИ не перерывал весь репозиторий ради одного факта), плюс автоматические фильтры: тайпчекеры, ESLint, Prettier и архитектурные тесты.
Зачем проекту папка с ADR: чего ИИ никогда не прочтёт в коде
Окей, скажешь ты, авторский DSL пока не вышел в опенсорс — что реально сделать в проекте уже сегодня?
Начать с того, чего вообще нет в исходниках. По коду видно что и как написано, но совершенно невозможно прочитать почему выбрали именно этот вариант: какие были ограничения бизнеса, от чего отказались и какие NFR заложили на старте.
Для этого придумали ADR (Architecture Decision Records) — короткие текстовые заметки о ключевых решениях. Шемсединов советует хранить папку с ADR прямо в репозитории, чтобы её читали и люди, и ИИ-агенты. Тогда при новой задаче нейросеть опирается на реальный контекст проекта, а не выдумывает требования на лету.
Минимальный набор страховки от ИИ-хаоса
- Завести в репозитории папку с ADR и фиксировать там ключевые решения вместе с причинами и нефункциональными требованиями.
- Вести актуальную карту потоков событий и общих данных, чтобы ни человек, ни агент не теряли скрытые связи между модулями.
- Закрыть границы слоёв автоматическими проверками — тайпчекером, линтером и архитектурными тестами, а не только глазами на ревью.
- Оставлять за живым разработчиком владение архитектурой: код отдельного отчёта может написать модель, но общую схему системы нужно держать в голове.