Edición 26 de octubreDigest del día · 10 materiales
Qué hay en esta ediciónRevisamos 36 fuentes, reunimos 10 materiales
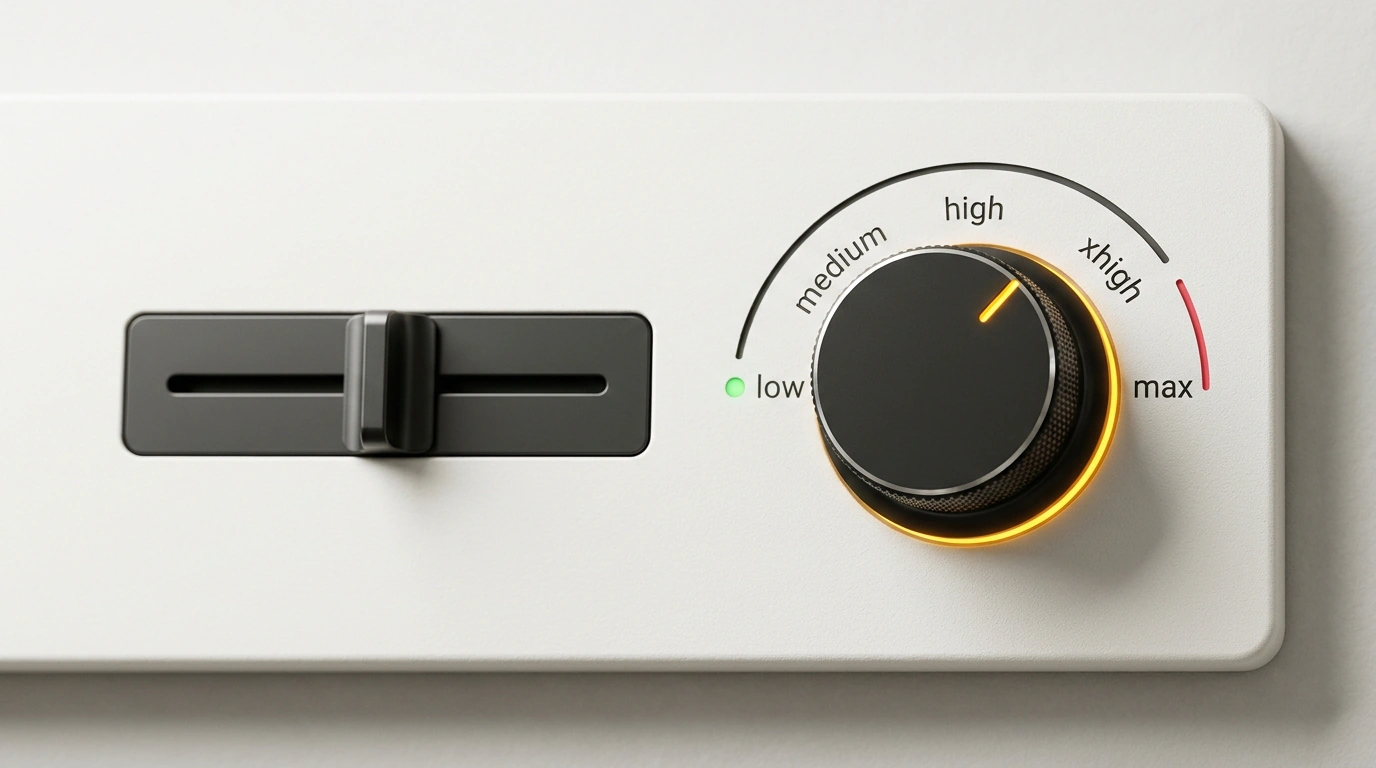
Selector escalonado de cinco posiciones para el esfuerzo computacional de una red neuronal con marcas low, medium, high, xhigh y max sobre un panel de grafito.
ArtículoIADesarrolloClaude CodeProductividad

Cinco niveles de esfuerzo en Claude Code: cómo Anthropic equilibra tokens y profundidad de razonamiento

La primera tentación de cualquier desarrollador al ver un nuevo regulador de razonamiento en IA es subirlo al máximo. En Claude Code, ese maximalismo produce un resultado inesperado: una tarea sencilla pasa de resolverse en minuto y medio a tardar más de una hora, quemando millones de tokens en comprobar lo evidente. Anthropic dividió el gasto computacional en cinco niveles: desde el rápido low hasta el autónomo y profundo max. Analizamos cómo funciona el parámetro effort, por qué el nivel alto suma un 52 % más de tareas resueltas en benchmarks y cómo una táctica en dos fases ahorra presupuesto sin perder fiabilidad en el código.

👍 0
Julian Goldie SEOClaude API Docs: Effort ParameterClaude Code Docs: Model Configuration
26 de octubre
Editor 3D interactivo con cuerpos geométricos paramétricos y una pasarela de red MCP abierta sobre fondo gris grafito oscuro.
ArtículoIADesarrolloGráficos 3DAgentes de IA

Spline 5.2 y el protocolo MCP: cómo conectar ChatGPT y Claude a un editor 3D interactivo

La mayoría de los generadores de gráficos tridimensionales producen mallas poligonales ineditables: cambiar la iluminación, repintar una pieza o vincular una animación interactiva en ese bloque monolítico es casi imposible. El lanzamiento de Spline 5.2 toma una ruta distinta: la aplicación de escritorio incorpora un servidor del protocolo MCP sobre el motor WebGPU. Ahora agentes externos como Claude Code y ChatGPT pueden manipular objetos paramétricos, ajustar materiales PBR y escribir código directo desde el chat, dejando al usuario el control manual total sobre la escena.

👍 0
Julian Goldie SEOSpline Documentation: 3D Engine & Agent FeaturesSpline MCP Server Endpoint
26 de octubre
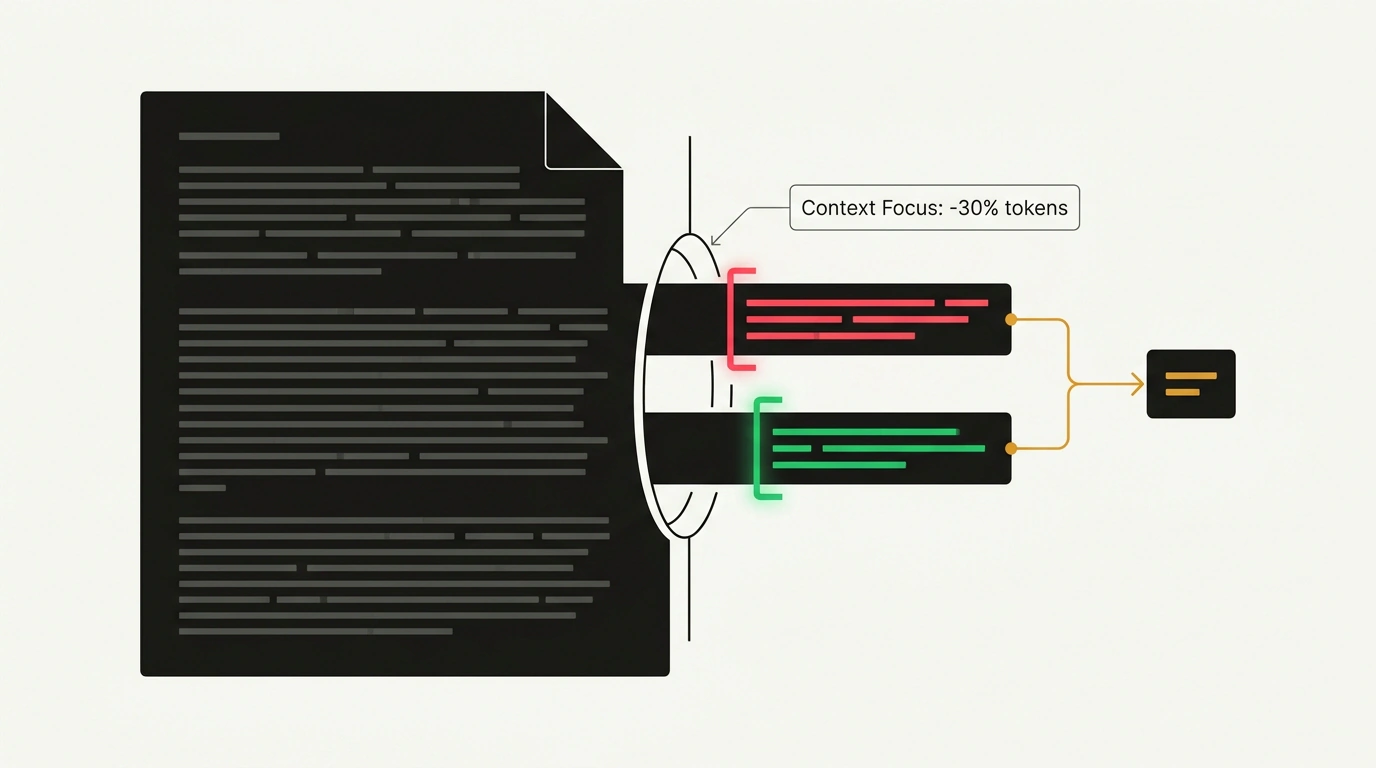
Esquema comparativo del recorte de ruido textual y la extracción precisa de fragmentos relevantes en un sistema de búsqueda RAG.
ArtículoIARAGLLMBúsqueda

Cohere Rerank 5: el mecanismo Context Focus reduce el gasto de tokens en un tercio en sistemas RAG

Un fallo habitual al diseñar sistemas RAG es meter en el contexto del LLM fragmentos completos sacados de la base de datos. Al final, el 80 % de los tokens se va en ruido irrelevante, la factura de la API sube y el modelo sufre el efecto «perdido en el medio». El nuevo Cohere Rerank 5 aporta una solución arquitectónica directa: el mecanismo Context Focus localiza los intervalos semánticos exactos dentro de los documentos y recorta el texto sobrante antes de enviarlo al generador. Esto reduce el consumo de tokens en más de un tercio, mientras las puntuaciones calibradas permiten fijar un umbral estricto de filtrado.

👍 0
Julian Goldie SEOCohere Blog: Introducing Rerank 5Cohere Documentation: Reranking & Context Focus
26 de octubre
Noticias · 26 de octubre1 noticia

DeepSeek libera en código abierto el motor de inferencia DeepInfer

El laboratorio DeepSeek publicó bajo licencia libre Apache 2.0 el código fuente del motor DeepInfer para el modelo V4.1 Flash de 552B parámetros. La decodificación especulativa DSpark acelera la generación en aceleradores NVIDIA y Ascend mediante validación paralela de tokens, reduciendo los costes de los centros de datos.

Visualización estereométrica de la extirpación de un vector de rechazo en el espacio multidimensional de pesos de una red neuronal.
ArtículoIASeguridadOpen SourceLLM

El modelo Abliterated Large-V2: cómo la ablación dirigida de vectores de rechazo abre GLM 5.3 para ciberseguridad

¿Para qué necesitan los especialistas en seguridad redes neuronales «desbloqueadas» y qué riesgos implica retirar las restricciones? La respuesta es sencilla: los filtros estándar de los modelos comerciales bloquean incluso auditorías legítimas de vulnerabilidades en código. El lanzamiento de Abliterated Large-V2, basado en los pesos de GLM 5.3, resuelve el problema mediante la ablación dirigida del vector de rechazo sin mermar la capacidad de razonamiento. En el benchmark ExploitBench la precisión se duplicó, y su ventana de contexto de un millón de tokens permite analizar un repositorio entero exigiendo a cambio aislamiento estricto en un sandbox cerrado.

👍 0
Julian Goldie SEOZ.ai Benchmarks: GLM Evaluation SuitePlayCISO: Refusal Vector Ablation Analysis
26 de octubre
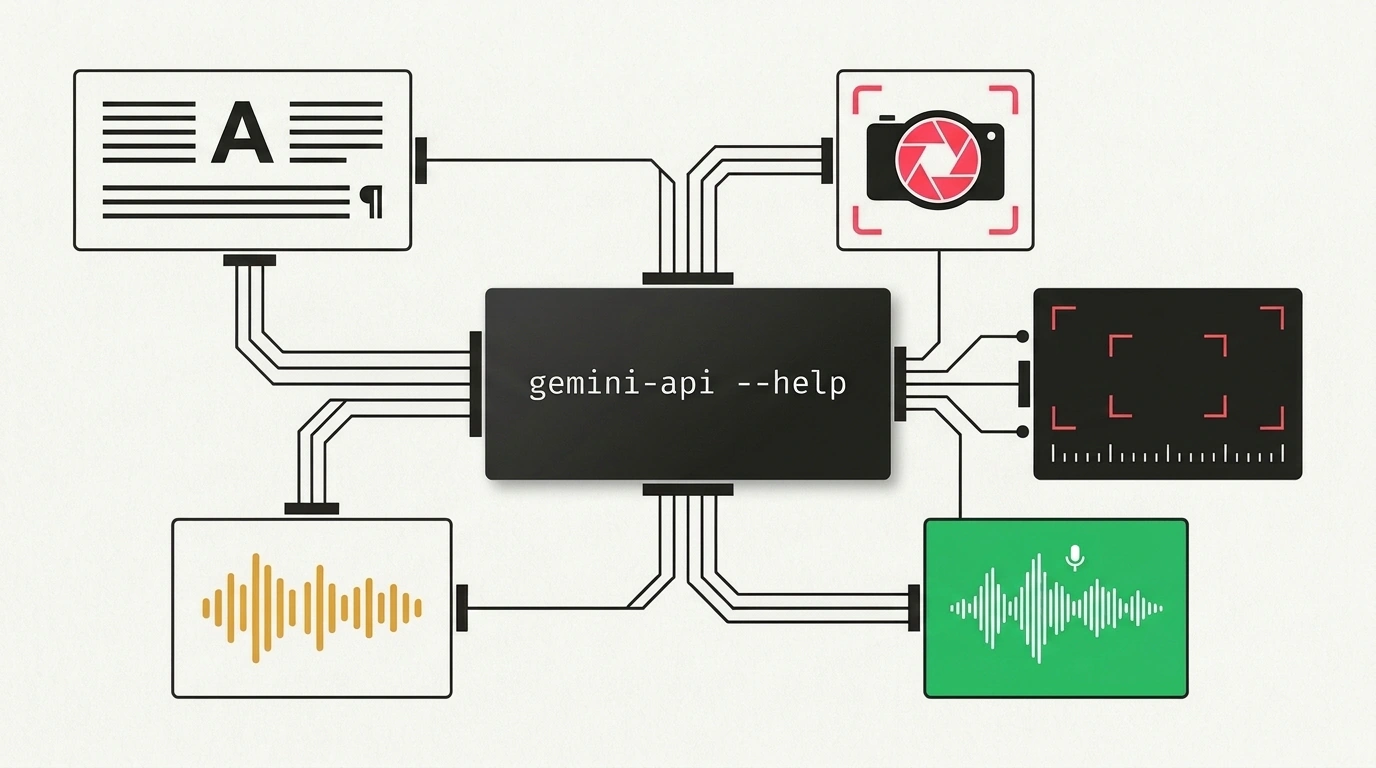
Cinco módulos multimodales de generación y procesamiento de contenido conectados por un bus único de terminal.
ArtículoIADesarrolloAutomatizaciónCLI

Gemini API CLI: la terminal multimodal experimental de Google para scripts y agentes

Automatizar tareas de IA multimodal en la terminal ya no exige montar envoltorios complejos en Python ni descifrar cadenas Base64. Google publicó el binario experimental Gemini API CLI sin dependencias externas, dando acceso a cinco operaciones clave directo desde Bash:

  • Generación de texto y estructuras JSON con validación por esquema;
  • Renderizado de imágenes con Imagen 3 y generación de vídeos cortos;
  • Síntesis de voz a MP3 y transcripción de audio con marcas de tiempo. La utilidad está optimizada para agentes autónomos: el flag --usage muestra el árbol de comandos en formato KDL y el modo --dry-run valida parámetros sin consumir cuota de tokens.
👍 0
Julian Goldie SEOGitHub: google-gemini/gemini-api-cliGoogle AI Studio: Gemini API Quickstart
26 de octubre
Asistente personal holográfico para el conductor en la pantalla multimedia de un automóvil bajo la luz urbana nocturna.
ArtículoIAInteligencia artificialAutomóvilesProductividad

Gemini Personal Intelligence en Android Auto: cómo Google lleva el contexto del usuario al volante

En lugar de memorizar comandos rígidos como una dirección exacta con número de portal, el asistente de voz del coche por fin aprende a entender el contexto humano. Google lanzó Personal Intelligence en Android Auto y en sistemas Google built-in, conectando Gmail, Calendar, Maps y Google Fotos. Ahora puedes pedirle que trace la ruta hacia el autolavado de una foto en tu galería o consultar la puerta de embarque desde tu billete electrónico. La función opera bajo estricto opt-in y solo se activa con el móvil conectado, quedando de momento fuera de Europa por las restricciones regulatorias del GDPR.

👍 0
Julian Goldie SEOGoogle Blog: Gemini Personal Intelligence in Android Auto9to5Google: Gemini Personal Intelligence Rollout
26 de octubre
Dos enfoques radicalmente distintos para procesar el habla: un pipeline modular de búfer de audio y una red neuronal nativa de sonido de extremo a extremo.
Resumen temático2 seccionesIAAgentes de IAAsistentes de vozOpen Source

IA de voz sin pausas: el streaming de Hermes Apollo y el modelo nativo de audio Dessa de Block

Los desarrolladores de IA de voz han llegado a una bifurcación fundamental en su lucha contra las pausas artificiales del diálogo. Por un lado está el agente abierto Hermes Apollo de Nous Research, que perfecciona el pipeline de texto tradicional con streaming de frases desde 20 caracteres y detección local de interrupciones. Por el otro, el modelo de audio de extremo a extremo Dessa, de la empresa Block de Jack Dorsey, que elimina el texto y se entrena directo sobre sonido real. Analizamos ambos enfoques, la latencia de 200 milisegundos y el futuro de la inferencia local en chips Apple Silicon.

👍 0
Julian Goldie SEO - Hermes ApolloNous Research: Hermes Agent OverviewBlock: Dessa Speech Model Overview
26 de octubre
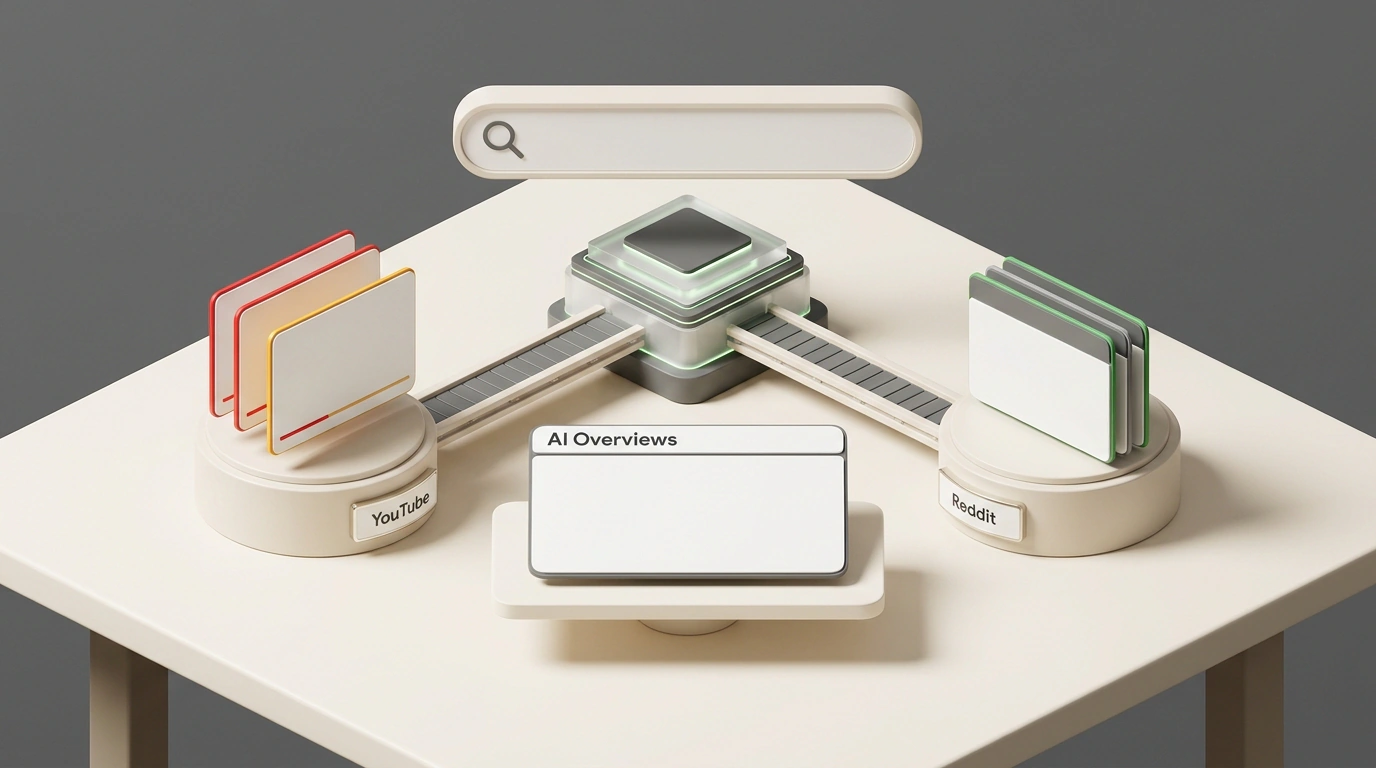
Diorama isométrico de la capa agéntica de búsqueda con bifurcación de flujos informativos hacia contenido en vídeo y debates en foros sobre fondo grafito.
A fondoBúsqueda IASEOAnalíticaMarketing

Anatomía de la búsqueda con IA: adónde van los clics de Google y cómo citan el contenido las redes neuronales

La búsqueda está siendo absorbida de forma irreversible por la capa agéntica: Sundar Pichai anunció la era de la ventana conversacional única, y un estudio sobre 380 000 respuestas destapó una fractura profunda en internet. Google AI Overviews cita a YouTube el doble de veces que a Reddit, y Microsoft Copilot muestra una preferencia diez veces mayor por el vídeo. En cambio, ChatGPT y Perplexity mencionan las discusiones de texto de Reddit 2,5 veces más que cualquier vídeo. Analizamos por qué los bloqueos en robots.txt solo crean una falsa sensación de protección y cómo construir consenso semántico para que ambos ecosistemas citen tu marca.

👍 0
Ross Simmonds - Foundation MarketingAleyda Solis - SEOFOMOSearch Engine Journal: Sundar Pichai on Agentic LayerSearch Engine Roundtable: Google on robots.txt for AI Crawlers
26 de octubre
Trabajador autónomo en la nube con programación de tareas y barreras de protección en una consola virtual.
ArtículoIAAgentes de IAAutomatizaciónNegocios

Grok Bot de xAI: arquitectura de agentes de IA en la nube con programación horaria y archivos de tareas

Intentar controlar agentes autónomos desde una ventana de chat web suele acabar en fracaso: la pestaña se suspende, la conexión se corta y el bot se cuelga o alucina. La plataforma Grok Bot de xAI resuelve esto trasladando los agentes a máquinas virtuales permanentes en la nube con navegador headless y terminal. En lugar de diálogos difusos, el trabajo se define mediante archivos estructurados de tareas (Job Files) con horario estricto y pasarela obligatoria de aprobación humana. Analizamos la arquitectura de estos trabajadores digitales y la protección contra bucles infinitos de gasto en API.

👍 0
Julian Goldie SEOxAI Documentation: Grok Bot Architecture
26 de octubre