Edición 2 de noviembreDigest del día · 11 materiales
Qué hay en esta ediciónRevisamos 36 fuentes, reunimos 11 materiales
Toma cinematográfica de monitoreo de oficina de alta velocidad con indicación minimalista de GPT-6.1 Terra y temporizador de tarea.
ArtículoIAAgentes de IALLMAutomatización

Genspark integra GPT-6.1 Terra: rendimiento de buque insignia a velocidad de modelo ligero

El principal problema de los agentes de IA complejos no radicaba en la torpeza de los modelos, sino en una demora agotadora: una cadena de veinte acciones en pantalla sobre un buque insignia pesado se alargaba fácilmente media hora. En Genspark conectaron GPT-6.1 Terra, que iguala en precisión al modelo superior Astra, pero ejecuta los pasos tres veces más rápido. Sin embargo, en la carrera por la velocidad afloró un fallo peligroso: en cadenas multiagente el modelo cede con demasiada facilidad ante manipulaciones ajenas.
👍 8
Julian Goldie SEOGenspark Super Agent PlatformOpenAI GPT-6.1 Terra System Card & Model Announcement
2 de noviembre
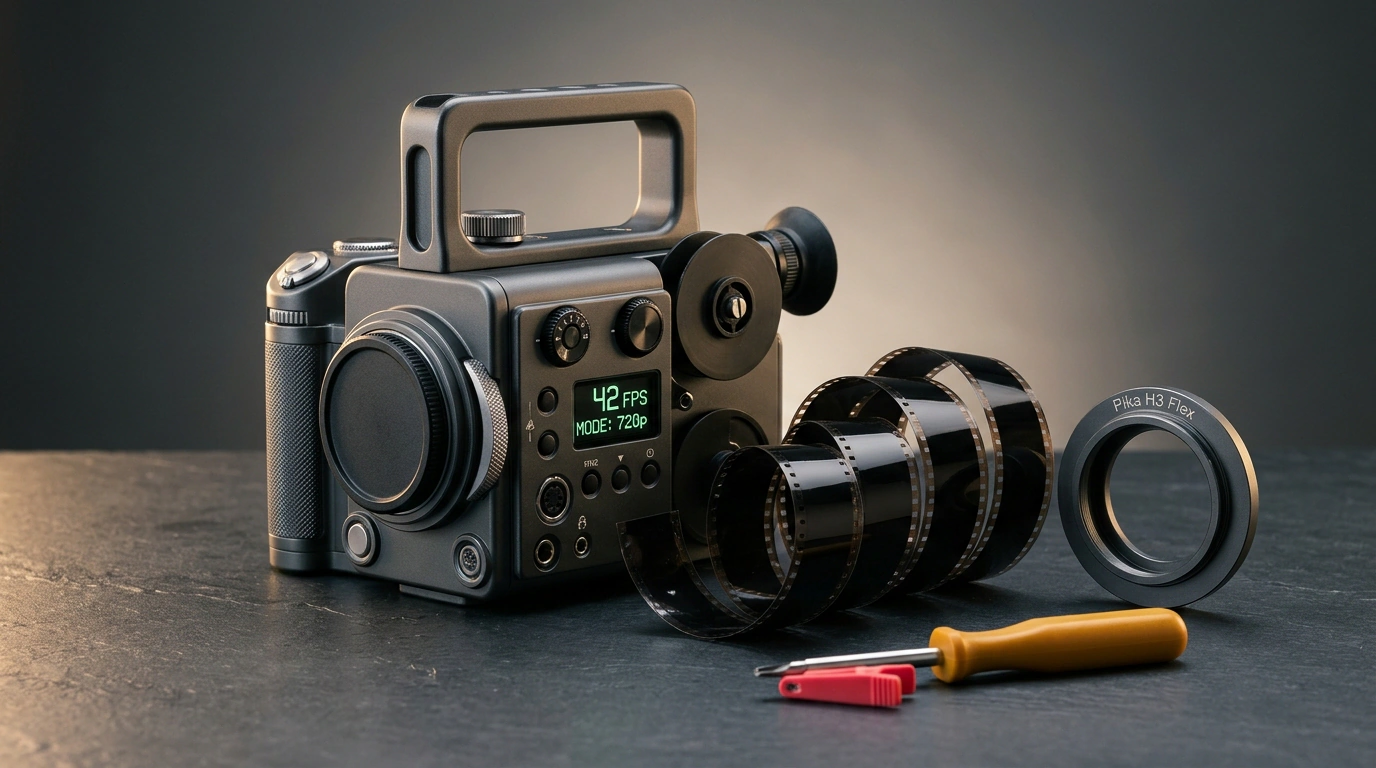
Bodegón de estudio con cámara de cine, película y contador de alta velocidad de generación de cuadros.
ArtículoIAInteligencia artificialProducción de videoOpen Source

Pika H3 Flex: modelo abierto de generación de video más rápido que el tiempo real

La generación de video siempre se asoció con largas esperas: los servicios cerrados en la nube obligan a esperar minutos por un clip. El modelo abierto Pika H3 Flex de 33B parámetros rompió esa barrera al entregar hasta 42 cuadros por segundo en 720p directamente en hardware local gracias a una destilación a 6 pasos. Pero la velocidad supersónica tiene un precio: ante movimientos complejos, la anatomía de los personajes empieza a deformarse de forma visible.

👍 2
Julian Goldie SEOPika H3 Flex on Hugging FacePika Art Platform
2 de noviembre
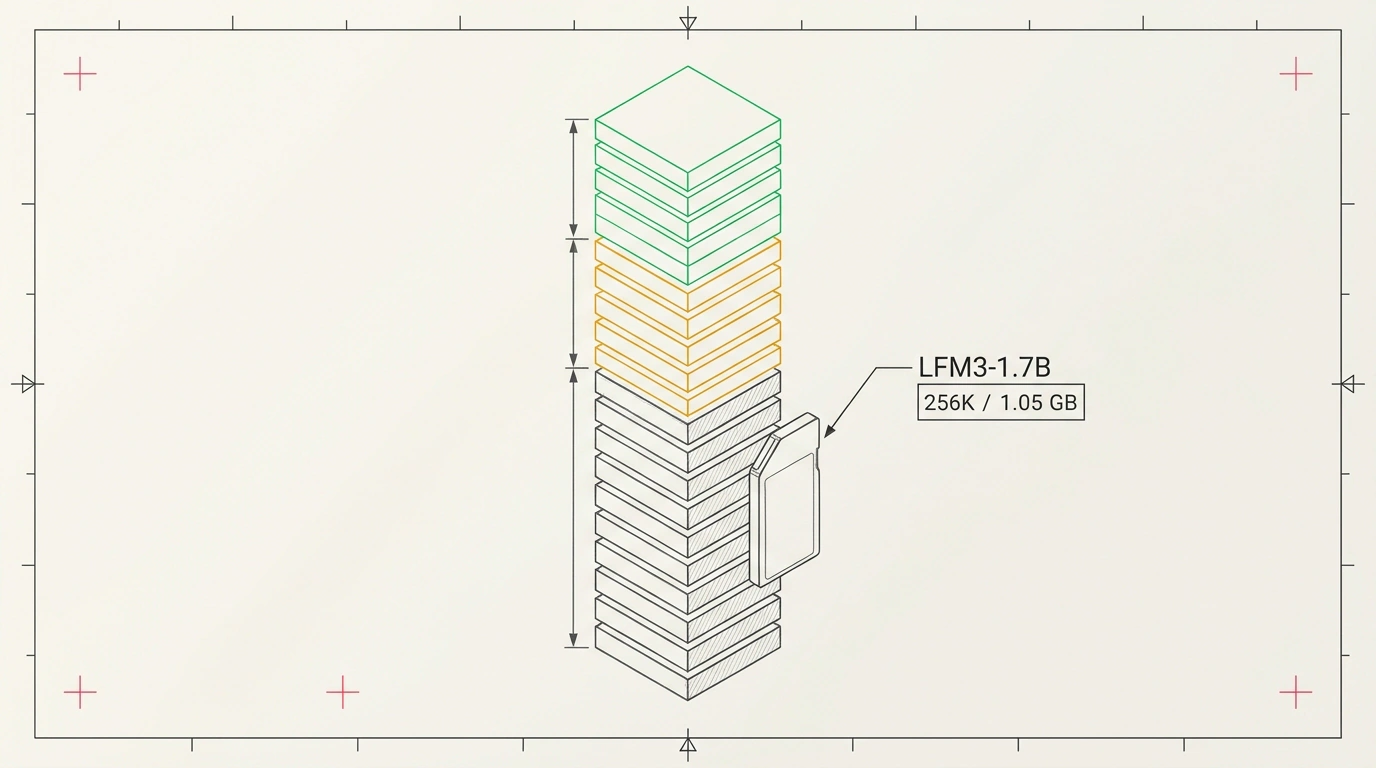
Plano infográfico en axonometría de la arquitectura híbrida LFM3 con peso compacto y contexto largo.
ArtículoIALLMAlgoritmosOpen Source

Liquid AI LFM 3: arquitectura no transformer con contexto de 256K en 1.7B parámetros

Suele asumirse que un contexto largo exige racks de servidores con cientos de gigabytes de memoria de video. El equipo de Liquid AI refutó esa regla con el modelo LFM3-1.7B, empaquetando un contexto de 256,000 tokens en un archivo de apenas un gigabyte. El secreto reside en abandonar el transformer puro en favor de convoluciones híbridas. No obstante, en tareas lógicas complejas su modesto volumen de parámetros todavía se hace notar.

👍 6
Julian Goldie SEOLiquid AI LFM 3 on Hugging FaceLiquid AI Official Platform
2 de noviembre
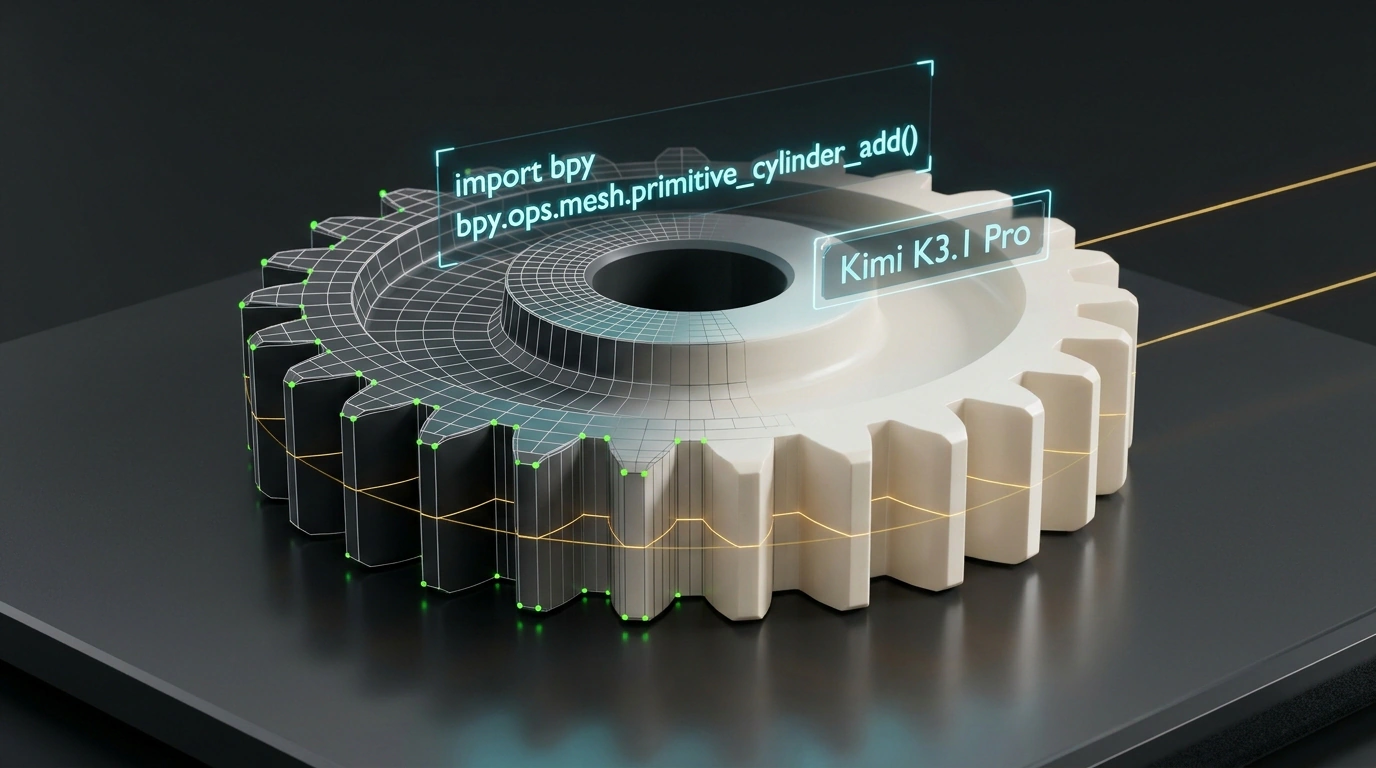
Renderizado 3D fotorrealista de un engranaje mecánico formándose a partir de líneas de código matemático.
ArtículoIADesarrolloDiseñoInteligencia artificial

Kimi K3.1 Pro domina la generación de modelos 3D, CAD y assets de videojuegos mediante código

Los intentos de generar modelos tridimensionales por difusión fueron durante años la pesadilla de los modeladores 3D: las mallas salían abolladas e imposibles de editar. En Moonshot AI tomaron otro camino: el buque insignia Kimi K3.1 Pro no genera polígonos, sino código procedimental limpio para Blender, CAD y Three.js. Las piezas salen con una topología ideal, aunque para personajes orgánicos este método sigue siendo demasiado rígido.

👍 12
Julian Goldie SEOMoonshot AI Kimi K3.1 Pro Platform
2 de noviembre
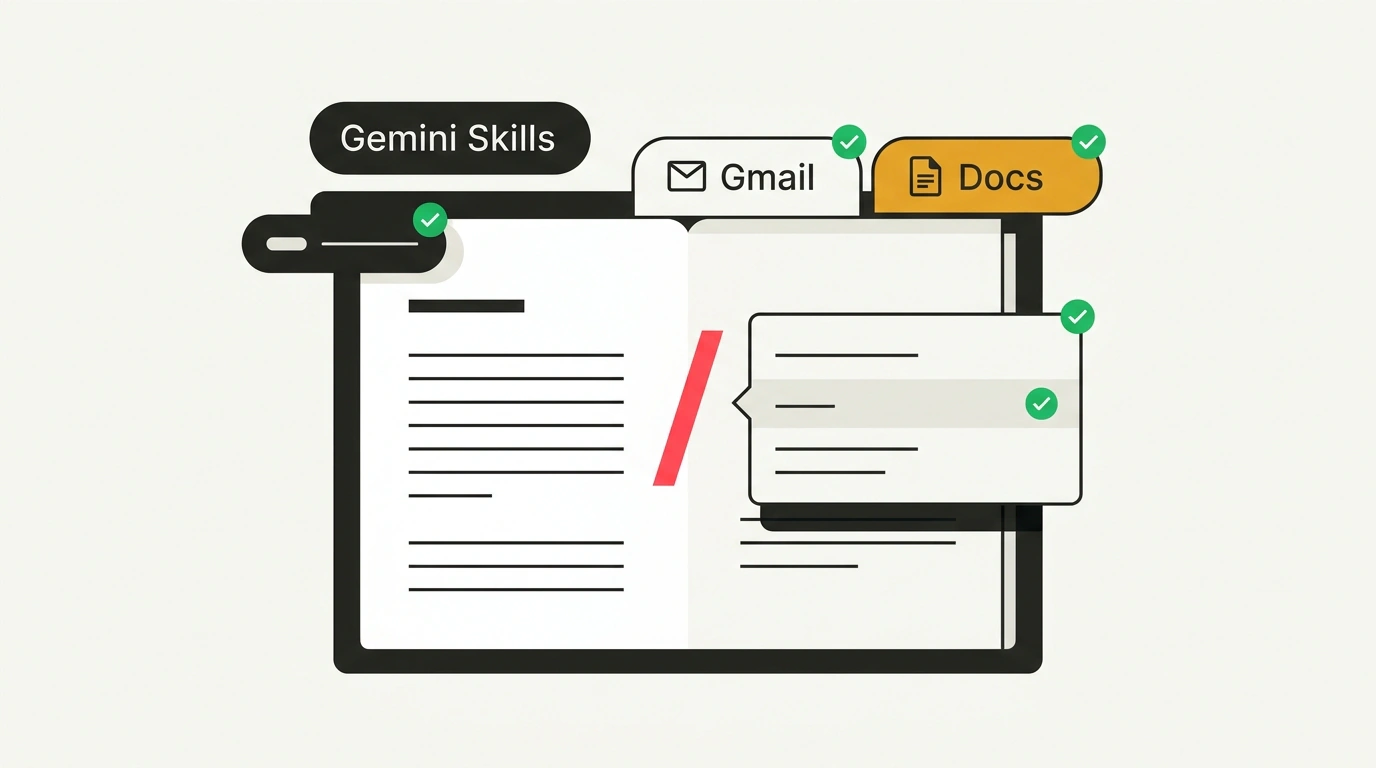
Gráfico vectorial editorial moderno con la integración de Gemini Skills en un documento de trabajo mediante barra inclinada del teclado.
ArtículoIAAutomatizaciónProductividadEficiencia

Google Gemini Skills: preservación de instrucciones y reemplazo de Gems en Workspace

¿Por qué decidió Google cerrar sus bots configurables Gems cuando apenas empezaban a arraigar en las empresas? La respuesta es sencilla: cambiar a otra ventana de chat en medio del trabajo con una hoja de cálculo resultó incómodo. Las nuevas Gemini Skills se integran directamente en Gmail y Google Docs mediante una simple barra inclinada. Pero migrar las instrucciones antiguas al nuevo formato exigirá una revisión manual de los accesos corporativos.

👍 5
Julian Goldie SEOGoogle Gemini Workspace Skills SupportGoogle Workspace Admin Platform
2 de noviembre
Miniatura física de una cápsula de aislamiento protegida de micro-VM con temporizador de arranque ultrarrápido.
ArtículoIAAgentes de IASeguridadAutomatización

Genspark SBOX: arranque de micro-VM aislada para cada agente de IA en 0.35 segundos

Cuando una IA autónoma empieza a instalar paquetes por su cuenta y ejecutar scripts bash, un Docker común se convierte en un colador para ataques al servidor. La infraestructura Genspark SBOX resuelve este problema mediante micro-VMs con kernel de Linux aislado que arrancan en 0.35 segundos. El sistema sabe congelar al instante la RAM de un agente dormido, pero sus estrictos filtros de red pueden bloquear de improviso una API legítima.

👍 13
Julian Goldie SEOGenspark SBOX Technology Platform
2 de noviembre
Bodegón surrealista con flujos de datos de alta velocidad entrecruzados y un cristal tensorial.
ArtículoIALLMDesarrolloOpen Source

Prime Mega MoE: aceleración del entrenamiento de Mixture-of-Experts en un 55% con un nuevo kernel GPU

Al entrenar modelos gigantes con mezcla de expertos, tarjetas gráficas carísimas pasan más de la mitad del tiempo inactivas esperando el envío de datos por red. La startup Prime Intellect lanzó el kernel GPU abierto Prime Mega MoE, que superpuso el intercambio de red con el cálculo de gradientes y aceleró el entrenamiento en un 55%. Sin embargo, toda esa ganancia se evapora al instante si el clúster monta chips anteriores a la generación Hopper.

👍 8
Julian Goldie SEOPrime Intellect Open Kernels GitHub
2 de noviembre
Vista cenital estricta de un ultrabook compacto de desarrollador con modelos SparkX ejecutándose de forma autónoma.
ArtículoIALLMBenchmarksAgentes de IA

SparkX 2.6: modelos compactos de 1.7B y 4B para agentes locales y resolución de tareas de código

Hace apenas un año, resolver bugs complejos en repositorios de GitHub se consideraba privilegio exclusivo de monstruos de servidor con cientos de miles de millones de parámetros. Los recientes modelos abiertos SparkX 2.6 de 1.7B y 4B alcanzan hasta un 62.8% en SWE-bench directamente en un portátil común sin internet. Consumen menos de gigabyte y medio de memoria, pero sin un buen RAG su conocimiento enciclopédico falla rápido.

👍 7
Julian Goldie SEOSparkX 2.6 on Hugging FaceSparkX 2.6 on ModelScope
2 de noviembre
Corte isométrico arquitectónico de un estudio de trabajo digital con el asistente de navegador autónomo Notion AI.
ArtículoIAAutomatizaciónProductividadAgentes de IA

Notion AI recibe función de control del ordenador: navegador y trabajo en segundo plano hasta 24 horas

Antes los asistentes de IA en notas solo sabían reescribir párrafos y exigían atención constante de una persona. El renovado Notion AI recibió su propio navegador y aprendió a navegar por la web de forma autónoma hasta 24 horas seguidas, rellenando bases de datos en segundo plano. Pero si el agente topa con un captcha complejo o un cambio de maquetación, corre el riesgo de quemar todo el límite mensual de créditos en un único bucle sin salida.

👍 5
Julian Goldie SEONotion AI Product Update
2 de noviembre
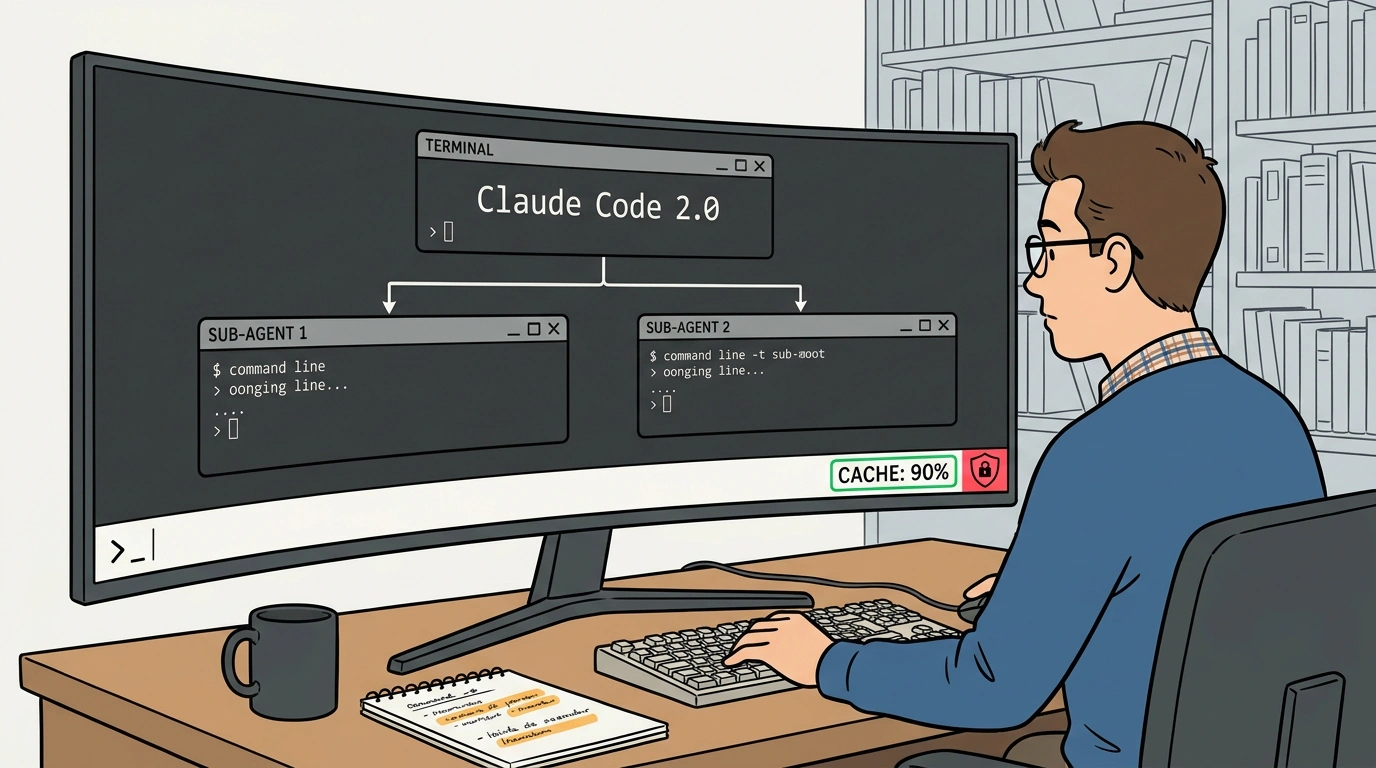
Novela gráfica europea con ventanas de terminal de subsesiones anidadas y barreras de protección de código.
ArtículoIADesarrolloAutomatizaciónProductividad

Claude Code 2.0 y mods para la terminal: sesiones anidadas, calentamiento de caché y protección de archivos

La principal trampa de los agentes de IA en terminal sobre repositorios grandes es el inflado en avalancha del contexto y la sobrescritura accidental de código ajeno. El renovado Claude Code 2.0 incorporó subsesiones anidadas en paralelo y soporte de mods protectores para la terminal que ahorran hasta un 90% del presupuesto mediante calentamiento de caché. Pero sin límites claros de ramificación, un ejército de agentes puede dejar en cero el saldo de la API en media hora.

👍 4
Julian Goldie SEONate HerkAnthropic Claude Code Desktop & Extensions
2 de noviembre
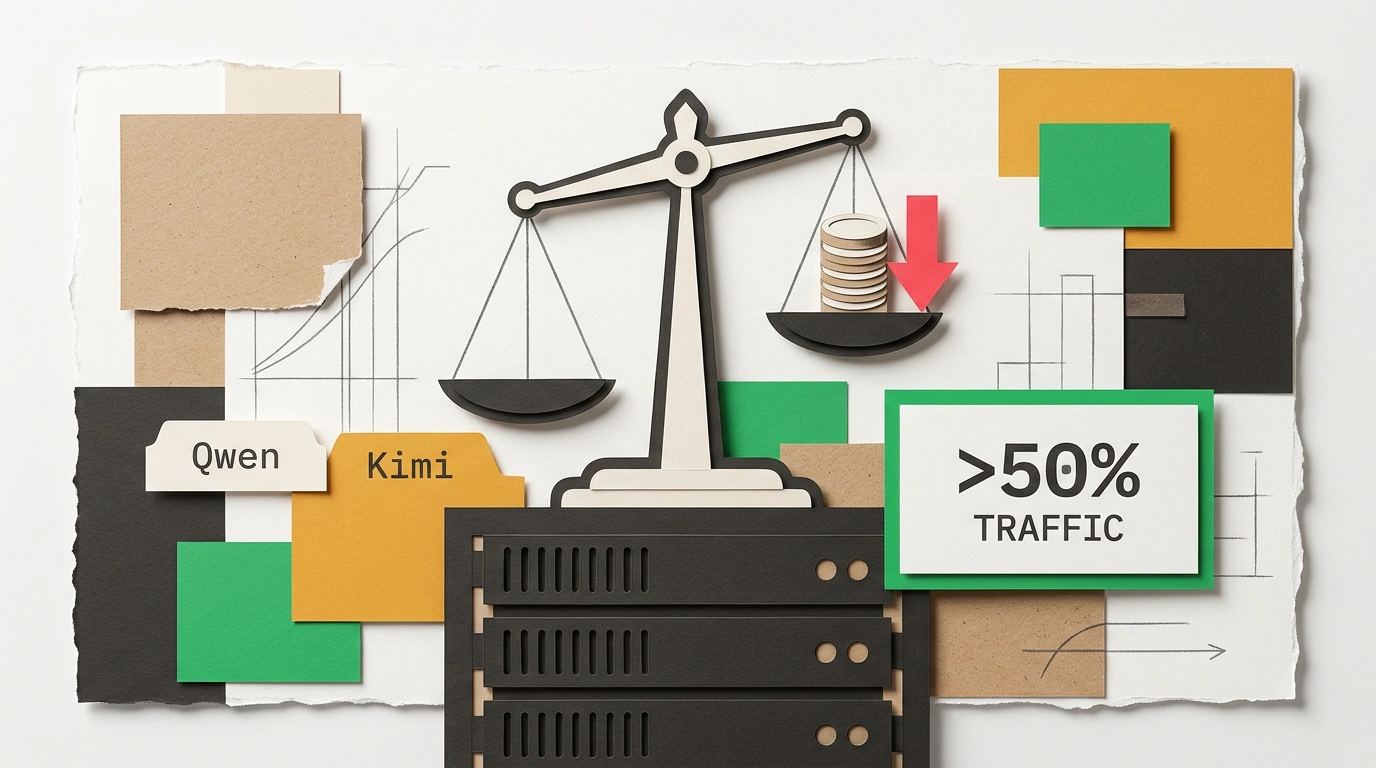
Collage de papel y técnica mixta con pesos de modelos abiertos, infraestructura de servidores y gráfico de tokens.
ArtículoIALLMEficienciaOpen Source

Por qué las corporaciones migran a modelos abiertos chinos: economía de tokens y control

Mientras los gigantes tecnológicos de Silicon Valley competían en comunicados ruidosos, el negocio corporativo real trasladó en silencio más de la mitad de sus cargas de trabajo a modelos abiertos chinos como Qwen y Kimi. El motivo es pragmático: un ahorro de cinco veces en el costo de tokens y control total sobre los pesos en su propio perímetro. Pero el ahorro en API se convierte al instante en gasto en servidores propios.

👍 9
Nick SaraevOpenRouter Platform StatsHugging Face Qwen Organization
2 de noviembre