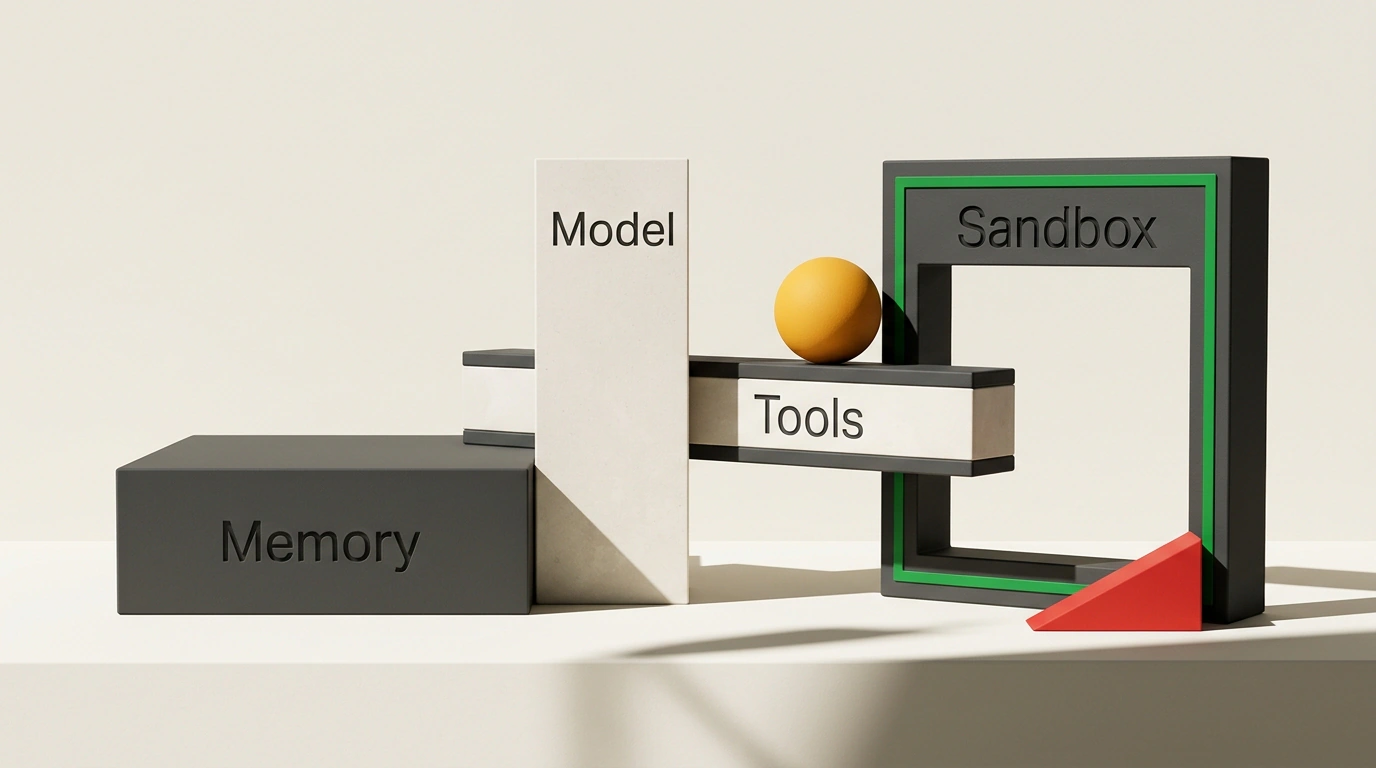
Pones el modelo insignia más nuevo en tu agente de código, esperas un milagro y a la hora vuelve a romper pruebas y a saltarse el linter. Al principio es fácil pasar por alto algo básico: el modelo sabe escribir código, pero por sí solo es ciego y no tiene manos. No abre archivos, no compila ni frena el borrado de una carpeta. Todo eso lo gestiona el entorno (harness) que rodea a la red neuronal. En la arquitectura de Google Cloud lo dividen en cuatro pilares.
Un cerebro en un frasco: por qué un agente supera a un asistente
Aquí el modelo funciona como el «cerebro», mientras el entorno le da ojos, manos, libreta y red de seguridad. Un asistente te entrega un bloque de código y luego tú copias los cambios, corres las pruebas y lees los logs. Un agente trabaja en ciclo: lee archivos, edita código, ejecuta pruebas, ve el error y lo corrige.
Si el entorno es débil, hasta un modelo brillante actúa a ciegas y terminas en el modo «prompt and pray»: lanzas una petición y rezas para que no se rompa nada.
Memoria, AGENTS.md y herramientas con ruta fija
Cuando un agente no conoce el proyecto, adivina. En el esquema de Google la memoria tiene tres capas: la sesión guarda el diálogo actual, state lleva el borrador con los intentos y la memoria a largo plazo conserva hábitos entre conversaciones.
Para no repetir las mismas reglas en cada chat, en la raíz del proyecto se coloca AGENTS.md, un archivo Markdown abierto que ya usan más de 60,000 repositorios y leen Codex, Jules, Gemini CLI, Cursor, Copilot, Aider, Windsurf y Devin.
# AGENTS.md

<!-- Comandos de compilación y pruebas -->
## Setup
- Install: `pnpm install`
- Test: `pnpm test`

<!-- Estilo y prohibiciones estrictas -->
## Boundaries
- TypeScript strict, single quotes, no semicolons
- Never commit `.env` or credential files
- Run `pnpm test` before opening a PR
Con este archivo en la raíz, cualquier agente compatible conoce de entrada los comandos, el estilo y los límites sin copiar la lista en cada conversación.
Luego hacen falta manos y una ruta clara. Para tareas concretas se escriben funciones en Python y los servicios externos se conectan vía MCP (Model Context Protocol). Para evitar que el agente entre en bucle, los pasos se definen en el proyecto abierto Google ADK (Python, TypeScript 2.0 GA, Go, Java, Kotlin): incluye SequentialAgent, ParallelAgent, LoopAgent y Graph Workflows con controles en paralelo, pausas para aprobación humana, tiempos límite y tope de reintentos.
Sandbox, defensa contra inyecciones y freno de emergencia
Un agente con acceso a terminal tarde o temprano ejecutará algo indebido, por eso el código corre dentro de un sandbox (contenedor o máquina virtual). Contra la inyección de prompts (prompt injection), cuando un texto dentro de un comentario o ticket intenta tomar el control, protege una regla simple: el texto externo se trata siempre como datos y nunca como órdenes. Conviene revisar también la privacidad: dónde se guardan los registros y la memoria, y quién puede verlos.
Los comandos peligrosos se bloquean con confirmación humana y con el hook before_tool_callback en ADK:
from typing import Any, Dict, Optional
from google.adk.agents import LlmAgent
from google.adk.tools.base_tool import BaseTool
from google.adk.tools.tool_context import ToolContext

# Patrones peligrosos para la herramienta de terminal
BLOCKED = ("rm -rf", "DROP TABLE", "DROP DATABASE", "git push")

def shell_guardrail(
    tool: BaseTool,
    args: Dict[str, Any],
    tool_context: ToolContext,
) -> Optional[Dict[str, Any]]:
    if tool.name == "run_shell":
        cmd = str(args.get("command", ""))
        if any(p in cmd for p in BLOCKED):
            name = tool_context.agent_name
            return {"error": f"Blocked in {name}: {cmd}"}
    # Solo None permite ejecutar la herramienta
    return None

agent = LlmAgent(
    name="coding_agent",
    model="gemini-2.5-flash",
    tools=[run_shell_tool],
    before_tool_callback=shell_guardrail,
)
Si el modelo intenta lanzar rm -rf, borrar una tabla o hacer git push, el hook devuelve un error y la herramienta no se ejecuta. En Python ADK hay dos detalles clave: solo None autoriza la ejecución (un diccionario vacío {} cancela la llamada), y las respuestas de texto se filtran con before_model_callback.
Evaluaciones en tres capas y por dónde empezar
Esta capa es la que más suele omitirse, confundiendo una respuesta con buena pinta con código que funciona. Las evaluaciones (evals) comprueban el resultado en tres niveles: pruebas y linters (un claro aprobado o fallo), LLM-as-a-judge (un segundo modelo evalúa estilo y claridad) y revisión humana en PR pequeños que se amplían conforme crece la confianza.
Los modelos cambian cada par de meses, pero el entorno permanece y potencia cada nueva versión. Empieza hoy con un paso concreto:
Cuatro pasos rápidos para empezar
- Agrega
AGENTS.mden la raíz con comandos, estilo y prohibiciones. - Conecta un servidor MCP a un servicio externo.
- Activa confirmación manual o el hook
before_tool_callbackpara comandos peligrosos. - Define al menos una prueba automática que el agente deba pasar siempre.