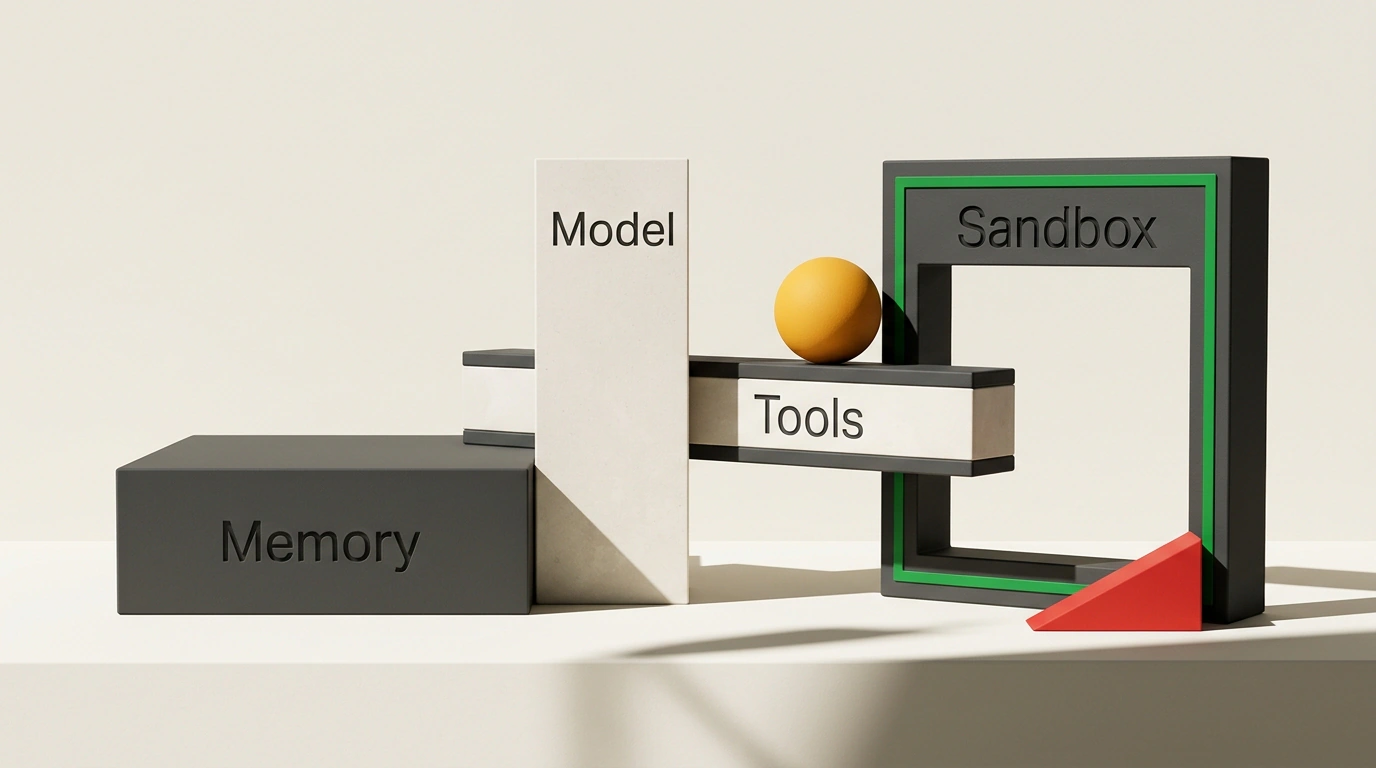
Ставишь в кодинг-агента свежий флагман, ждёшь чуда, а через час он снова ломает тесты и забывает линтер. На старте легко упустить простую деталь: модель умеет писать код, но сама она слепа и безрука. Она не откроет файл, не запустит сборку и не остановит удаление папки. Всё это берёт на себя обвязка (harness) — среда вокруг нейросети. В инженерной схеме Google Cloud её делят на четыре элемента.
Мозг в банке: чем агент сильнее ассистента
Модель здесь работает как «мозг», а обвязка даёт глаза, руки, блокнот и страховку. Ассистент выдаёт кусок кода, и дальше ты сам копируешь правки, гоняешь тесты и читаешь логи. Агент крутится в цикле: читает файлы, правит код, запускает тесты, видит ошибку и чинит её.
Если обвязка слабая, даже умная модель действует вслепую — получается режим «prompt and pray»: кинул запрос и молишься, чтобы не развалилось.
Память, AGENTS.md и руки с маршрутом
Когда агент не знает проект, он угадывает. В схеме Google память делят на три слоя: сессия держит диалог, state — черновик с попытками, а долгосрочная память хранит привычки между чатами.
Чтобы не повторять правила вручную, в корень кладут AGENTS.md — открытый Markdown-файл, который используют свыше 60 000 репозиториев и читают Codex, Jules, Gemini CLI, Cursor, Copilot, Aider, Windsurf и Devin.
# AGENTS.md

<!-- Команды сборки и тестов -->
## Setup
- Install: `pnpm install`
- Test: `pnpm test`

<!-- Стиль и жёсткие запреты -->
## Boundaries
- TypeScript strict, single quotes, no semicolons
- Never commit `.env` or credential files
- Run `pnpm test` before opening a PR
С этим файлом в корне совместимый агент сразу знает команды, стиль и запреты — без копирования чек-листа в каждый чат.
Дальше нужны руки и маршрут. Под узкие задачи пишут Python-функции, а сервисы подключают через MCP (Model Context Protocol). Чтобы агент не зациклился, шаги задают в открытом Google ADK (Python, TypeScript 2.0 GA, Go, Java, Kotlin): там есть SequentialAgent, ParallelAgent, LoopAgent и Graph Workflows с параллельными проверками, паузой на человека, таймаутами и лимитом повторов.
Песочница, защита от инъекций и стоп-кран
Агент с терминалом рано или поздно запустит лишнее, поэтому код гоняют в песочнице (контейнер или VM). От инъекции промптов (prompt injection), когда текст в комментарии или тикете перехватывает управление, спасает правило: внешний текст остаётся данными без права отдавать команды. Проверь и приватность: где лежат логи и память и кто их видит.
Опасные команды закрывают подтверждением человека и хуком before_tool_callback в ADK:
from typing import Any, Dict, Optional
from google.adk.agents import LlmAgent
from google.adk.tools.base_tool import BaseTool
from google.adk.tools.tool_context import ToolContext

# Опасные шаблоны для shell-инструмента
BLOCKED = ("rm -rf", "DROP TABLE", "DROP DATABASE", "git push")

def shell_guardrail(
    tool: BaseTool,
    args: Dict[str, Any],
    tool_context: ToolContext,
) -> Optional[Dict[str, Any]]:
    if tool.name == "run_shell":
        cmd = str(args.get("command", ""))
        if any(p in cmd for p in BLOCKED):
            name = tool_context.agent_name
            return {"error": f"Blocked in {name}: {cmd}"}
    # Только None разрешает запустить инструмент
    return None

agent = LlmAgent(
    name="coding_agent",
    model="gemini-2.5-flash",
    tools=[run_shell_tool],
    before_tool_callback=shell_guardrail,
)
Если модель потянется к rm -rf, сбросу таблицы или git push, хук вернёт ошибку, и инструмент не запустится. У Python ADK две ловушки: запуск разрешает строго None (пустой {} отменит вызов), а текстовые ответы фильтрует before_model_callback.
Эвалы в три слоя и с чего начать
Этот слой пропускают чаще всего, путая вид готовой работы с рабочим кодом. Эвалы (evals) проверяют итог в три этапа: тесты и линтеры (чёткий pass/fail), LLM-as-a-judge (вторая модель оценивает стиль и ясность) и ревью человеком в малых PR, которые укрупняют с ростом доверия.
Модели меняются каждые пару месяцев, а обвязка остаётся и усиливает каждую новую. Начни с одного шага:
Четыре быстрых шага для старта
- Добавь в корень
AGENTS.mdс командами, стилем и запретами. - Подключи один MCP-сервер к внешнему сервису.
- Включи подтверждение или хук
before_tool_callbackна опасные команды. - Пропиши хотя бы один автотест, который агент обязан пройти.