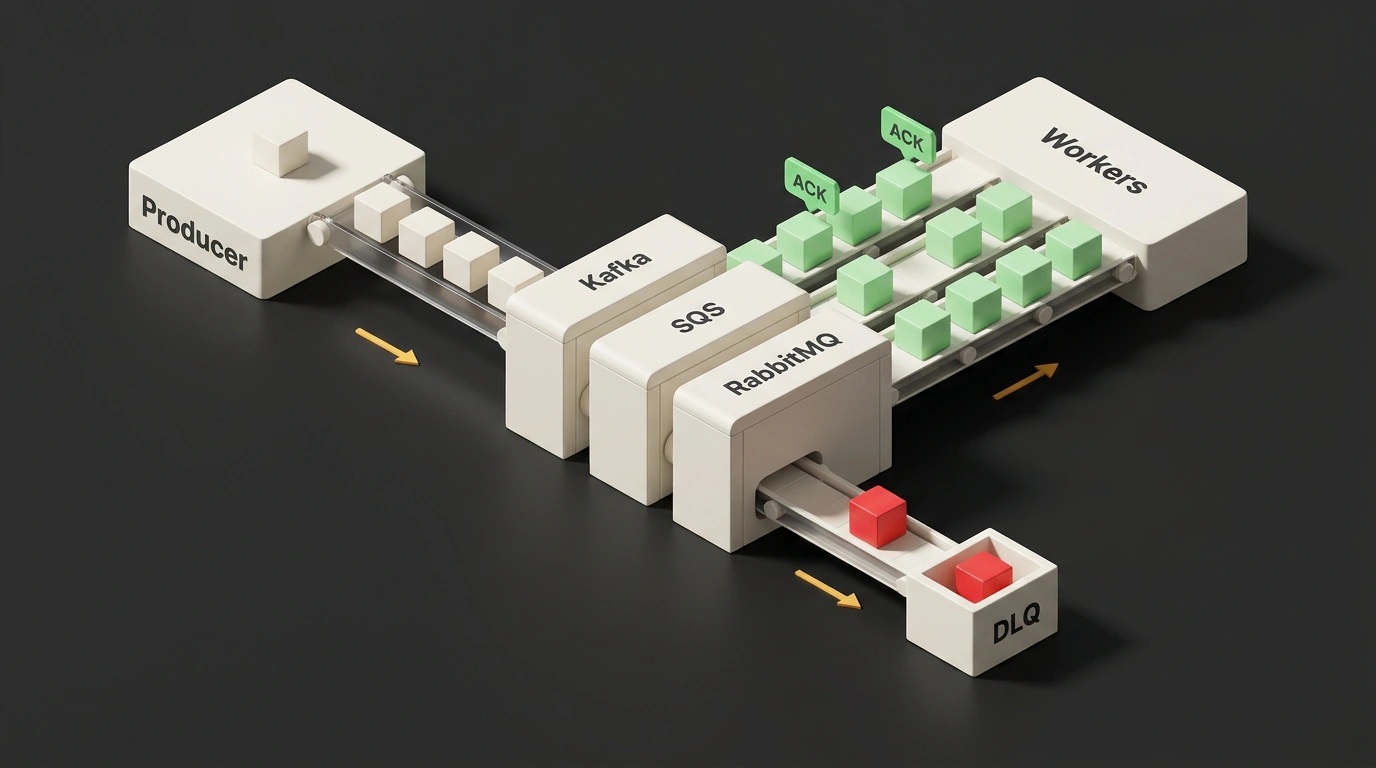
Возьмём типичный сервис для обмена фотографиями в духе Instagram. Пользователь выбирает снимок в телефоне, жмёт «Опубликовать», и бэкенду нужно проделать с этим файлом три обязательных шага. Сначала нарезать превью под разные экраны интерфейса, затем прогнать картинку через модель модерации, чтобы отловить запрещённый контент, а в конце разослать уведомления подписчикам и обновить их ленты.
Самый прямой путь — выполнить все три шага по очереди прямо внутри одного веб-сервера, пока мобильное приложение висит в ожидании ответа. На ноутбуке разработчика это работает бодро. В реальном продакшене схема начинает трещать сразу по четырём швам.
Первый удар приходится по времени ответа. Пользователь смотрит на крутящийся спиннер, пока сервер пережимает картинку, ждёт вердикта от нейросети и обновляет ленты. Можно распараллелить ресайз и модерацию внутри одного процесса, но при росте трафика сервер всё равно быстро упрётся в потолок, и очередь из ожидающих HTTP-запросов растянется на десятки секунд.
Вторая проблема бьёт по бюджету на железо. Для нарезки картинок нужен приличный объём оперативной памяти, а для модерации контента требуется производительная видеокарта. Если держать обе задачи на одном сервере, приходится арендовать дорогие машины сразу и с кучей RAM, и с GPU. В итоге видеокарта простаивает во время ресайза, а лишняя оперативка пылится, пока крутится нейросеть.
Третья беда — хрупкость всей цепочки. Стоит сервису модерации моргнуть или упасть по таймауту, как валится вся загрузка целиком. Пользователь жмёт «Повторить», и сервер послушно тратит процессор и время на то, чтобы заново нарезать превью, которые уже были готовы в прошлый раз.
Четвёртый сценарий добивает систему в самый радостный день. Приложение попадает в подборку App Store, выстреливает рекламная кампания или случается громкое событие, и поток загрузок подскакивает в разы. Сервер проектировали под спокойные нефункциональные требования (NFR, то есть заранее заданные лимиты по нагрузке и времени ответа), так что внезапный всплеск просто кладёт загрузку. Держать впрок лишние реплики серверов на случай редкого пика слишком дорого: большую часть месяца они просто сжигают деньги вхолостую.
Как очередь развязывает загрузку и обработку
Чтобы снять все четыре проблемы разом, тяжёлые шаги разносят по отдельным специализированным сервисам, а между ними ставят очередь сообщений. Картина сразу меняется.
Пользователь отправляет фото на веб-сервер. Сервер сохраняет файл в хранилище, кладёт короткое сообщение с метаданными в очередь и тут же отвечает приложению: «Готово, файл загружен». Человек уходит листать ленту дальше, а в фоне независимые воркеры (сервисы ресайза, модерации и уведомлений) забирают задачи из очереди и обрабатывают их параллельно.
По сути, очередь сообщений работает как обычный буфер между двумя ролями. Продюсер (producer) создаёт и складывает сообщения в буфер: допустим, пять пользователей одновременно загрузили по три фотографии, и веб-сервер отправил в очередь 15 сообщений. Консьюмер (consumer) забирает эти сообщения и делает полезную работу. В нашем фотосервисе консьюмерами выступают пулы воркеров для ресайза, модерации и рассылки, причём каждого вида воркеров можно запустить сколько угодно копий.
Главная польза такого буфера в развязке. Продюсер ничего не знает про консьюмеров, а консьюмеры не зависят от продюсера. Веб-сервер отвечает мгновенно, потому что ему больше не нужно ждать видеокарту. Воркеры для ресайза едут на машинах с большим объёмом RAM, а воркеры модерации крутятся на серверах с GPU. Если один из воркеров упадёт на середине работы, задача не пропадёт: её подхватит соседний экземпляр. А когда нагрянет всплеск трафика, система не начнёт сыпать пятисотыми ошибками — просто очередь временно подрастёт, пока автоскейлер поднимает дополнительные воркеры.
Звучит как волшебная таблетка? Вот тут и начинаются технические детали, из-за которых на продакшене регулярно пропадают данные или списываются лишние деньги.
Что происходит под капотом: подтверждения и защита от дублей
Если заглянуть внутрь любого брокера, вся его надёжность держится на трёх базовых механизмах: подтверждениях обработки, защите от параллельных дублей и гарантиях доставки.
Начнём с подтверждений — их называют ACK (от acknowledgement). Представь, что воркер вытянул из очереди задачу на обработку фотографии и на полпути рухнул из-за нехватки памяти. Если бы брокер удалял сообщение сразу в момент выдачи, фотография пропала бы бесследно. Поэтому очередь держит сообщение у себя и ждёт от воркера явного сигнала ACK: мол, работу закончил, можешь стирать. Нет сигнала — брокер считает задачу невыполненной и отдаёт её другому воркеру.
Техническая схема механизма подтверждения ACK и таймаутов удержания сообщений брокером для SQS и RabbitMQ
Точно так же брокер может отправлять ACK обратно продюсеру, подтверждая, что сообщение надёжно принято. Задержка на запись чуть вырастает, зато продюсер уверен, что данные не сгорели в сети по дороге до сервера.
Тут возникает естественный вопрос: если сообщение остаётся в очереди до прихода ACK, как не выдать его одновременно воркеру А и воркеру Б? Никому не хочется тратить видеокарты на двойную работу или ловить странные побочные эффекты. Три самых популярных брокера решают эту задачу совершенно по-разному.
В Amazon SQS работает механизм Visibility Timeout — окно невидимости. Как только воркер забирает сообщение, SQS прячет его от остальных потребителей на заданное время. Окно настраивается в пределах от 0 секунд до 12 часов, а по умолчанию составляет 30 секунд (это верно для обеих разновидностей очередей: Standard и FIFO). Успел воркер закончить работу и вызвать DeleteMessage — сообщение удаляется навсегда. Если задача затянулась, воркер может попросить отсрочку через метод ChangeMessageVisibility. Не успел и не продлил — по истечении таймера сообщение снова появляется в очереди, и его хватает другой воркер.
В RabbitMQ выданные сообщения помечаются статусом unacknowledged (unack) и временно блокируются для остальных потребителей. Здесь таймер ожидания consumer_timeout гораздо длиннее: по умолчанию 30 минут (1 800 000 миллисекунд). Если воркер за полчаса не прислал ACK, брокер жёстко закрывает его канал с ошибкой PRECONDITION_FAILED и возвращает сообщение в очередь с флагом redelivered: true. Правда, если воркер не просто завис, а разорвал TCP-соединение (например, упал процесс), RabbitMQ не станет ждать полчаса — он вернёт задачу в очередь мгновенно. Подкрутить этот лимит для долгих задач можно глобально в rabbitmq.conf, через политику consumer-timeout или аргумент очереди x-consumer-timeout.
Apache Kafka идёт третьим путём. Топик заранее разрезан на независимые партиции. Внутри одной группы потребителей (consumer group) действует жёсткое правило: одну партицию в каждый момент времени читает строго один воркер. Два экземпляра из одной группы физически не могут конкурировать за одно и то же сообщение, потому что у каждого своя выделенная полоса.
Гарантии доставки, идемпотентность и ловушка таймаута
А теперь представь самую коварную ситуацию. Воркер честно сделал всю работу, сохранил результат, и буквально за миллисекунду до отправки ACK сервер потерял сеть или перезагрузился. Брокер подтверждения не получил. Что он сделает? Решит, что задача сорвалась, и отправит то же самое сообщение другому воркеру.
Для нарезки превью или модерации повторный запуск обычно безобиден: картинка пережмётся ещё раз, итоговый файл останется точно таким же. Такие операции называют идемпотентными — сколько раз их ни вызывай с одними и теми же входными данными, конечное состояние системы не меняется. Например, запрос «изменить имя пользователя на Aleksander» идемпотентен: хоть один раз его выполни, хоть десять, в базе всё равно будет записано «Aleksander».
Совсем другая история с деньгами и счётчиками. Если сообщение велит списать с карты клиента 130 шведских крон (130 SEK), повторная обработка снимет уже 260 SEK. Прибавление N к счётчику просмотров тоже неидемпотентно, ведь каждый дубль накрутит лишние цифры.
В реальной эксплуатации дубли появляются даже без падения серверов. Классическая ловушка в Amazon SQS выглядит так: команда оставляет дефолтный Visibility Timeout на 30 секунд и вешает на очередь воркеры с GPU-модерацией. Под нагрузкой видеокарта задумывается на 45 секунд. На тридцатой секунде SQS решает, что первый воркер умер, и спокойно выдаёт ту же фотографию второму воркеру. Оба честно жуют один и тот же снимок. Лечится это просто: таймаут невидимости считают не «на глаз» и не по среднему времени, а от 99-го перцентиля (p99) длительности обработки, оставляя проверку идемпотентности как страховку.
Симулятор SQS: visibility timeout, время воркера и дорога в DLQ
Попробуй подвигать ползунки в симуляторе выше: как только время обработки на GPU переваливает за Visibility Timeout, второй воркер вступает в дело прямо поверх первого. А если поставить галочку битого сообщения, видно, как лимит попыток отсекает бесконечный цикл падений и отправляет проблемную задачу в отстойник DLQ.
Из-за таких сбоев в системах обмена сообщениями выделяют три модели гарантий доставки.
Первая модель — At-Least-Once (минимум один раз). Сообщение гарантированно доедет до обработчика, но при сбоях возможны повторы. Это поведение по умолчанию в SQS, RabbitMQ и Kafka. Оно отлично работает, когда задача идемпотентна или не меняет состояние критичных данных.
Вторая модель — At-Most-Once (не более одного раза). Воркер шлёт ACK сразу, едва получив сообщение, ещё до начала реальной работы. Дублей не бывает в принципе, но если процесс упадёт на полпути, данные пропадут навсегда. Так обычно гоняют метрики и телеметрию, где потеря пары точек из миллиона никому не мешает.
Третья модель — Exactly-Once (ровно один раз). Мечта каждого разработчика, которая в распределённых сетях упирается в классическую задачу двух генералов (Two Generals' problem): два узла, общающиеся по ненадёжной сети, математически не могут быть на сто процентов уверены, что последнее подтверждение дошло до другой стороны. Поэтому на практике честный Exactly-Once почти всегда собирают как связку At-Least-Once и идемпотентного обработчика — через уникальные ключи дедупликации, уникальные индексы и транзакции в базе данных.
Когда очередь спасает систему, а когда только мешает
После знакомства с буферами и воркерами часто возникает соблазн воткнуть очередь в каждый второй сервис. Делать этого не стоит: у инструмента есть четыре чётких показания и два жёстких противопоказания.
Очередь работает на пользу, когда задача асинхронная и пользователю не нужен мгновенный ответ — скажем, отправка письма, сборка тяжёлого отчёта, нарезка видео или обработка загруженного фото. Она же выручает при рваном трафике, когда нагрузка приходит волнами и нужно проглотить пик, не отбрасывая запросы: буфер просто размазывает всплеск ровным слоем по воркерам. Третий сигнал — необходимость развязать сервисы с разным железом или темпом релизов, как в нашем примере с лёгким веб-сервером, RAM для ресайза и GPU для модерации. И четвёртый случай — повышенные требования к надёжности: если смежный сервис временно лёг на техобслуживание или упал, очередь придержит задачи у себя, пока получатель не вернётся в строй.
А вот в двух ситуациях очередь принесёт больше головной боли, чем пользы.
Первое ограничение — синхронные запросы с жёстким лимитом задержки, например быстрее 500 миллисекунд. Дополнительный сетевой прыжок до брокера, запись на диск, ожидание свободного воркера и возврат результата почти гарантированно сломают этот NFR. Очереди придуманы для работы, которую можно сделать позже, пусть даже это «позже» означает пару секунд.
Второе ограничение — отложенная обратная связь об ошибках. В синхронном API проблема видна мгновенно: сервер вернул ошибку, клиент узнал об этом сразу. С очередью всё устроено куда хитрее.
Главная эксплуатационная ловушка асинхронной архитектуры: очередь не убирает поломку, а просто откладывает её на потом и делает тише. Консьюмер уже час лежит мёртвым грузом, но веб-сервер продолжает исправно складывать задачи в буфер и отдавать пользователям зелёные 200 OK. На входных графиках тишь да благодать, пока через час в очереди не вырастет такой бэклог, что его разбор займёт больше времени, чем длился сам простой.
Отсюда вытекает правило мониторинга, к которому на практике часто приходят только после первого крупного ночного инцидента: алертить нужно не только на длину очереди, но в первую очередь на возраст самого старого необработанного сообщения. Если обычно задача живёт в очереди пару секунд, а самое старое письмо пролежало там уже пять минут, значит, потребители встали — даже если общее число сообщений на графике кажется скромным.
Партиционирование и ловушка горячих ключей
Одна линейная очередь рано или поздно упирается в потолок пропускной способности. Чтобы масштабироваться горизонтально, входящий поток рубят на несколько независимых подочередей — партиций. Разные воркеры разбирают разные партиции параллельно, а пул таких воркеров объединяют в группу потребителей (consumer group).
Здесь действует жёсткая арифметика: внутри одной группы активных воркеров не может быть больше, чем партиций. Если у тебя 8 партиций и 2 воркера, каждый заберёт по 4 партиции. Понадобилось ускориться — поднимаешь до 8 воркеров, и каждый обрабатывает по одной. А вот 9-й воркер в этой же группе просто будет сидеть без дела, потому что свободных партиций для него не осталось.
Чтобы брокер понимал, в какую партицию положить очередное сообщение, ему передают ключ партиционирования. Выбрать этот ключ так же ответственно, как выбрать ключ шардирования в базе данных. Тут сталкиваются два требования. С одной стороны, сообщения с одинаковым ключом всегда попадают в одну и ту же партицию, где строго сохраняется порядок. Для неидемпотентных операций вроде банковских проводок это критично: списание и пополнение по одному счёту обязаны идти в правильной последовательности.
С другой стороны, ключ обязан размазывать трафик по партициям без перекосов. Допустим, ты делаешь агрегатор поездок и решаешь партиционировать события по полю city. В первый же день партиция мегаполиса раскалится докрасна (это и есть горячая партиция, или hot partition), а воркеры, закреплённые за мелкими городами, будут скучать без работы. Замени ключ на user_id или ride_id, и нагрузка распределится ровно. Правда, строгий порядок сохранится уже на уровне отдельного пользователя или поездки, а не всего города целиком.
Партиции Kafka: баланс воркеров и горячие ключи
В симуляторе хорошо видны оба ограничения сразу: при 8 партициях и 9 воркерах последний экземпляр остаётся без дела, сколько бы контейнеров ты ни докидывал. А если переключить ключ с city на ride_id, красная перегретая полоса исчезает и нагрузка выравнивается. Подбор ключа — всегда поиск баланса между строгим порядком и ровным распределением.
Back pressure и отравленные сообщения с DLQ
Следующая пара продакшен-проблем бьёт по живучести брокера: переполнение буфера и битые сообщения, которые вешают воркеры в бесконечный цикл.
Что случится, если продюсеры стабильно штампуют сообщения быстрее, чем воркеры успевают их переваривать? Очередь начнёт пухнуть, пока не съест всю оперативную память или место на диске. От переполнения защищаются тремя мерами в связке. Первая — автоскейлинг: при росте очереди оркестратор автоматически поднимает дополнительные копии воркеров (а где нужно, заранее держит запас партиций). Вторая — back pressure (обратное давление): когда буфер подходит к критической отметке, система перестаёт бездумно принимать всё подряд, отклоняет новые запросы или возвращает продюсеру ошибку с просьбой повторить попытку позже. Так давление передаётся вверх по цепочке вместо тихого падения брокера. Третья мера — те самые алерты на глубину очереди и возраст самого старого сообщения, чтобы успеть вмешаться до того, как кончится диск.
Другая частая авария — отравленное сообщение (poisoned message). Иногда в очередь прилетает задача, которая валит абсолютно любого воркера: битый JSON, невалидный статус заказа, неожиданный формат файла или просто сочетание полей, на котором спотыкается баг в коде обработчика. Без защиты начинается бесконечный день сурка. Воркер забирает задачу, падает, брокер возвращает её в очередь, следующий воркер забирает ту же задачу и снова падает. Ресурсы сгорают впустую, а следом встаёт вся остальная очередь.
Концептуальная диаграмма фильтрации отравленного сообщения с повторными попытками retry и изоляцией в очереди Dead Letter Queue
Лекарство стандартное и проверенное — задать максимальное число попыток (max retry count). Не получилось обработать задачу три или пять раз подряд — брокер снимает её с основного конвейера и перекладывает в Dead Letter Queue (DLQ), отдельную очередь или партицию для «мёртвых писем». Дальше с ней спокойно разбирается инженер, администратор или ИИ-помощник: ищет баг, чинит код или отбрасывает мусор. Обязательное условие — повесить алерты на попадание сообщений в DLQ. Иначе отстойник превратится в чёрную дыру, куда месяцами утекают реальные заказы клиентов, а команда узнаёт об этом из гневных тикетов в поддержке.
Отказоустойчивость брокера, репликация и replay истории
До сих пор мы рассуждали об очереди так, будто сам брокер бессмертен. На деле он легко становится единой точкой отказа (SPOF, single point of failure): упала очередь — встал обмен между сервисами.
Современные брокеры вроде Apache Kafka решают это записью сообщений на диск с настраиваемым окном хранения (log.retention.hours, log.retention.ms или log.retention.bytes — скажем, на день, на неделю или вообще бессрочно) и репликацией между несколькими серверами-брокерами. Упал один узел — данные тут же подхватываются с реплики, примерно как в базах данных.
У дискового хранения есть отличный побочный плюс — replay, то есть повторное проигрывание истории. Допустим, вчера выкатили воркер с багом, и он полдня криво считал аналитику или портил индексы. Выкатываешь исправленную версию, останавливаешь группу потребителей и сбрасываешь её смещение (offset) назад во времени с помощью утилиты kafka-consumer-groups.sh --reset-offsets (например, с флагами --to-earliest, --to-datetime или --shift-by). Воркер заново перечитывает все события за нужный период в пределах окна хранения и чинит данные.
Правда, у Kafka есть тонкий нюанс с хранением самих смещений: они лежат во внутреннем топике __consumer_offsets, и если consumer group долго не проявляет активности (дольше лимита offsets.retention.minutes), брокер стирает её старую позицию. При следующем запуске группа стартует по правилу auto.offset.reset — с самого начала или с самого конца топика, что легко может стать сюрпризом, если не знать об этом заранее.
Kafka, Amazon SQS и RabbitMQ: как выбрать инструмент под задачу
Все три популярных решения давно обкатаны в бою, но устроены по-разному и закрывают разные сценарии. Чтобы не гадать, сведём ключевые отличия в одну таблицу.
| Критерий | Apache Kafka | Amazon SQS (Standard / FIFO) | RabbitMQ |
|---|---|---|---|
| Модель хранения | Распределённый журнал на диске с окном retention; сообщения не удаляются сразу после чтения | Управляемый облачный сервис AWS; сообщение удаляется после вызова DeleteMessage | Классический брокер на Erlang; гибкая маршрутизация через exchanges и bindings |
| Защита от дублей | Жёсткое правило: 1 партиция = 1 консьюмер в группе | Visibility Timeout (0 с – 12 ч, дефолт 30 с), продление через ChangeMessageVisibility | Статус unack (consumer_timeout дефолт 30 мин; при обрыве TCP — мгновенный requeue) |
| Порядок и гарантии | Строгий порядок внутри партиции; At-Least-Once по умолчанию | Standard: максимум скорости, порядок без строгих гарантий, At-Least-Once; FIFO: строгий порядок и Exactly-Once, но ниже скорость | Гибкая маршрутизация, At-Least-Once по умолчанию |
| Replay истории | Да (сброс offset в пределах окна хранения) | Нет (после подтверждения сообщение исчезает) | Нет (для классических очередей) |
| Главная сильная сторона | Высокая пропускная способность, потоковая обработка событий, аудит и replay | Мгновенный старт в AWS без администрирования кластера | Сложные правила маршрутизации сообщений между сервисами |
Если перевести эту таблицу на язык повседневных инженерных решений, выбор складывается быстро.
Apache Kafka берут туда, где нужен большой поток событий, высокая пропускная способность, надёжное хранение истории на диске и возможность отмотать время назад через replay. Если одно и то же событие читают сразу несколько независимых команд (биллинг, аналитика, антифрод) и каждая хочет идти по логу в своём темпе, распределённый журнал Kafka подходит лучше всего. Плата за эти возможности — необходимость грамотно планировать партиции и обслуживать кластер (или платить за управляемый вариант).
Amazon SQS даёт самый быстрый и безболезненный старт, если твоя инфраструктура уже живёт в AWS. Никаких серверов, кластеров и ночных обновлений брокера: создал очередь за минуту и погнал трафик. Для большинства фоновых задач вроде обработки картинок и рассылки писем хватает версии Standard, которая выжимает максимум пропускной способности при доставке At-Least-Once. Если же нужен строгий порядок сообщений и защита от дублей на уровне брокера (Exactly-Once), переключаются на FIFO, заранее мирясь с более скромным потолком скорости.
RabbitMQ выбирают реже, чем двух первых гигантов, но в своей нише он до сих пор незаменим. Когда нужно хитро развести сообщения по разным сервисам через обменники (exchanges) и привязки (bindings) по ключам маршрутизации, заголовкам или шаблонам, традиционный брокер на Erlang справляется с этим удобнее и проще, чем попытки городить сложную логику поверх партиций Kafka. Главное — не забывать про дефолтный получасовой consumer_timeout на долгих задачах и сразу заложить DLQ для битых сообщений.