Tomemos un servicio típico para compartir fotos al estilo de Instagram. El usuario elige una imagen en su teléfono, pulsa «Publicar» y el backend debe ejecutar tres pasos obligatorios sobre ese archivo. Primero, recortar miniaturas para distintas pantallas de la interfaz; después, pasar la imagen por un modelo de moderación para detectar contenido prohibido; y por último, enviar notificaciones a los seguidores y actualizar sus feeds.
El camino más directo es ejecutar los tres pasos en secuencia dentro de un mismo servidor web, mientras la aplicación móvil espera la respuesta. En el portátil del desarrollador funciona rápido. En producción, este diseño se agrieta por cuatro frentes a la vez.
El primer golpe cae sobre el tiempo de respuesta. El usuario se queda mirando un spinner mientras el servidor recomprime la foto, espera el veredicto de la red neuronal y actualiza los feeds. Podrías paralelizar el recorte y la moderación dentro del mismo proceso, pero al subir el tráfico el servidor chocará contra su techo rápidamente y la cola de peticiones HTTP en espera se estirará decenas de segundos.
El segundo problema golpea el presupuesto de hardware. Recortar imágenes exige bastante memoria RAM, mientras que moderar contenido requiere una tarjeta gráfica potente. Si mantienes ambas tareas en el mismo servidor, te ves obligado a alquilar máquinas caras con mucha RAM y GPU a la vez. Como resultado, la GPU pasa el tiempo ociosa durante el recorte y la memoria extra se desperdicia mientras corre la red neuronal.
El tercer problema es la fragilidad de toda la cadena. Basta con que el servicio de moderación parpadee o caiga por timeout para que se venga abajo toda la subida. El usuario pulsa «Reintentar» y el servidor gasta CPU y tiempo en volver a generar miniaturas que ya estaban listas en el intento anterior.
El cuarto escenario remata al sistema en su mejor día. La aplicación entra en los destacados del App Store, despega una campaña publicitaria o ocurre un evento masivo y el flujo de subidas se multiplica. El servidor se diseñó para requisitos no funcionales tranquilos (NFR, los límites predefinidos de carga y latencia), así que un pico repentino tumba las cargas. Mantener réplicas extra encendidas por si acaso llega un pico puntual resulta carísimo: pasan casi todo el mes quemando dinero sin hacer nada.
Cómo una cola desacopla la subida del procesamiento
Para resolver los cuatro problemas de golpe, los pasos pesados se reparten entre servicios especializados y entre ellos se coloca una cola de mensajes. El panorama cambia al instante.
El usuario envía la foto al servidor web. El servidor guarda el archivo en el almacenamiento, deposita un mensaje corto con metadatos en la cola y responde de inmediato a la app: «Listo, archivo subido». La persona sigue navegando por su feed mientras, en segundo plano, workers independientes (los servicios de recorte, moderación y notificaciones) toman las tareas de la cola y las procesan en paralelo.
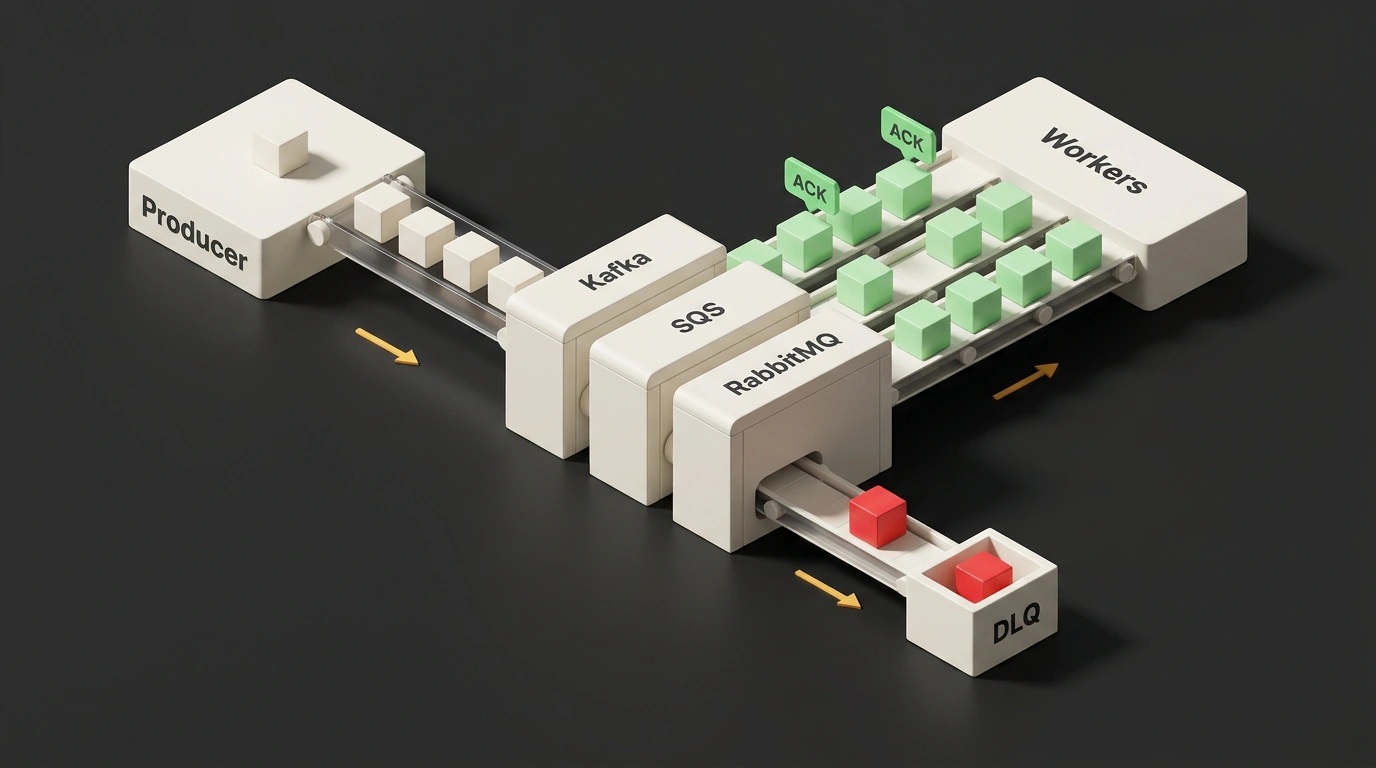
En esencia, una cola de mensajes actúa como un búfer entre dos roles. El productor (producer) crea y coloca mensajes en el búfer: por ejemplo, cinco usuarios suben tres fotos cada uno al mismo tiempo y el servidor web envía 15 mensajes a la cola. El consumidor (consumer) recoge esos mensajes y hace el trabajo útil. En nuestro servicio de fotos, los consumidores son pools de workers para recorte, moderación y envíos, y puedes levantar tantas copias de cada tipo como necesites.
La mayor ventaja de este búfer es el desacoplamiento. El productor no sabe nada sobre los consumidores, y los consumidores no dependen del productor. El servidor web responde al instante porque ya no espera a la GPU. Los workers de recorte corren en máquinas con mucha RAM y los de moderación en servidores con GPU. Si un worker cae a mitad de tarea, el trabajo no se pierde: lo toma otro ejemplar vecino. Y cuando llega un pico de tráfico, el sistema no empieza a escupir errores 500: la cola simplemente crece de forma temporal mientras el autoescalado levanta más workers.
¿Suena como una solución mágica? Justo aquí empiezan los detalles técnicos por los que en producción se pierden datos o se gasta dinero de más.
Qué ocurre bajo el capó: confirmaciones y protección contra duplicados
Si miras dentro de cualquier bróker, toda su fiabilidad descansa en tres mecanismos básicos: confirmaciones de procesamiento, protección contra duplicados paralelos y garantías de entrega.
Empecemos por las confirmaciones, llamadas ACK (de acknowledgement). Imagina que un worker toma de la cola una tarea para procesar una foto y se cae a mitad de camino por falta de memoria. Si el bróker borrara el mensaje en cuanto lo entrega, la fotografía desaparecería sin dejar rastro. Por eso la cola retiene el mensaje y espera del worker una señal explícita ACK: trabajo terminado, ya puedes borrarlo. Si no llega la señal, el bróker asume que la tarea falló y se la entrega a otro worker.
Esquema técnico del mecanismo de confirmación ACK y de los timeouts de retención de mensajes en SQS y RabbitMQ
Del mismo modo, el bróker puede devolver un ACK al productor para confirmar que recibió y aseguró el mensaje. La latencia de escritura sube un poco, pero el productor tiene certeza de que los datos no se perdieron en la red camino al servidor.
Aquí surge una pregunta natural: si el mensaje permanece en la cola hasta recibir el ACK, ¿cómo evitar entregárselo al mismo tiempo al worker A y al worker B? Nadie quiere gastar GPU haciendo el doble de trabajo ni sufrir efectos secundarios extraños. Los tres brókeres más populares resuelven esto de formas muy distintas.
En Amazon SQS opera el mecanismo de Visibility Timeout (ventana de invisibilidad). En cuanto un worker toma un mensaje, SQS lo oculta del resto de consumidores durante un tiempo configurado. La ventana va de 0 segundos a 12 horas, y por defecto dura 30 segundos (tanto en colas Standard como FIFO). Si el worker termina a tiempo y llama a DeleteMessage, el mensaje se borra para siempre. Si la tarea se alarga, el worker puede pedir una prórroga con ChangeMessageVisibility. Si no termina ni renueva, al vencer el temporizador el mensaje reaparece en la cola y lo toma otro worker.
En RabbitMQ, los mensajes entregados se marcan como unacknowledged (unack) y quedan bloqueados temporalmente para otros consumidores. Aquí el temporizador de espera consumer_timeout es mucho más largo: 30 minutos por defecto (1,800,000 milisegundos). Si el worker no envía ACK en media hora, el bróker cierra su canal a la fuerza con el error PRECONDITION_FAILED y devuelve el mensaje a la cola con la marca redelivered: true. Eso sí, si el worker no se quedó colgado sino que rompió la conexión TCP (por ejemplo, murió el proceso), RabbitMQ no espera media hora: reencola la tarea al instante. Puedes ajustar este límite para tareas largas de forma global en rabbitmq.conf, mediante una política consumer-timeout o con el argumento de cola x-consumer-timeout.
Apache Kafka sigue un tercer camino. El topic viene dividido de antemano en particiones independientes. Dentro de un mismo grupo de consumidores (consumer group) rige una regla estricta: cada partición es leída por un único worker a la vez. Dos instancias del mismo grupo no pueden competir físicamente por el mismo mensaje porque cada una tiene su carril asignado.
Garantías de entrega, idempotencia y la trampa del timeout
Ahora imagina el escenario más traicionero. El worker hizo bien todo su trabajo, guardó el resultado y, apenas un milisegundo antes de enviar el ACK, el servidor perdió la red o se reinició. El bróker no recibió la confirmación. ¿Qué hace? Decide que la tarea fracasó y entrega exactamente el mismo mensaje a otro worker.
Para recortar miniaturas o moderar contenido, una segunda ejecución suele ser inofensiva: la imagen se recomprime otra vez y el archivo final queda idéntico. A estas operaciones se les llama idempotentes: no importa cuántas veces las ejecutes con los mismos datos de entrada, el estado final del sistema no cambia. Por ejemplo, la orden «cambiar el nombre del usuario a Aleksander» es idempotente: la ejecutes una vez o diez, en la base de datos quedará guardado «Aleksander».
Otra historia muy distinta ocurre con el dinero y los contadores. Si un mensaje ordena cobrar 130 coronas suecas (130 SEK) de la tarjeta del cliente, procesarlo dos veces cobrará 260 SEK. Sumar N a un contador de vistas tampoco es idempotente, porque cada duplicado inflará las cifras.
En producción real, los duplicados aparecen incluso sin que caigan servidores. La trampa clásica en Amazon SQS ocurre así: el equipo deja el Visibility Timeout por defecto en 30 segundos y conecta a la cola workers de moderación con GPU. Bajo carga, la tarjeta gráfica tarda 45 segundos. Al segundo treinta, SQS da por muerto al primer worker y entrega sin dudar la misma foto al segundo worker. Ambos procesan honestamente la misma imagen. La solución es sencilla: el tiempo de invisibilidad no se calcula «a ojo» ni con el promedio, sino a partir del percentil 99 (p99) de duración, manteniendo además la comprobación de idempotencia como red de seguridad.
Simulador SQS: visibility timeout, tiempo del worker y ruta a la DLQ
Mueve los controles del simulador arriba: en cuanto el tiempo en GPU supera el Visibility Timeout, el segundo worker entra en escena encima del primero. Y si activas la casilla de mensaje corrupto, verás cómo el límite de intentos corta el bucle infinito de caídas y manda la tarea problemática al depósito DLQ.
A raíz de estos fallos, en los sistemas de mensajería se distinguen tres modelos de garantía de entrega.
El primero es At-Least-Once (al menos una vez). El mensaje llegará con seguridad al procesador, pero ante fallos puede haber repeticiones. Es el comportamiento predeterminado en SQS, RabbitMQ y Kafka. Funciona de maravilla cuando la tarea es idempotente o no altera datos críticos.
El segundo modelo es At-Most-Once (como máximo una vez). El worker envía el ACK en cuanto recibe el mensaje, antes de empezar el trabajo real. Nunca habrá duplicados, pero si el proceso cae a mitad de camino, los datos se pierden para siempre. Así suelen enviarse métricas y telemetría, donde perder un par de puntos entre millones no afecta a nadie.
El tercero es Exactly-Once (exactamente una vez). El sueño de todo desarrollador, que en redes distribuidas choca con el clásico problema de los dos generales (Two Generals' problem): dos nodos que se comunican por una red no fiable no pueden estar matemáticamente seguros al cien por ciento de que la última confirmación llegó al otro lado. Por eso, en la práctica un Exactly-Once real casi siempre se construye combinando At-Least-Once con un procesador idempotente mediante claves de deduplicación, índices únicos y transacciones en base de datos.
Cuándo una cola salva el sistema y cuándo solo estorba
Tras conocer los búferes y workers, suele nacer la tentación de meter una cola en cada segundo servicio. No conviene hacerlo: esta herramienta tiene cuatro indicaciones claras y dos contraindicaciones estrictas.
La cola aporta valor cuando la tarea es asíncrona y el usuario no necesita respuesta inmediata: enviar un correo, generar un reporte pesado, transcodificar video o procesar una foto subida. También brilla ante tráfico irregular, cuando la carga llega en oleadas y debes absorber el pico sin rechazar peticiones: el búfer reparte la cresta de forma uniforme entre los workers. La tercera señal es la necesidad de desacoplar servicios con distinto hardware o ritmo de despliegues, como en nuestro ejemplo del servidor web ligero, RAM para recorte y GPU para moderación. El cuarto caso es una exigencia alta de disponibilidad: si un servicio vecino entra en mantenimiento o se cae, la cola retiene las tareas hasta que vuelva a estar en línea.
En cambio, hay dos situaciones donde una cola dará más dolores de cabeza que beneficios.
La primera limitación son las peticiones síncronas con un límite estricto de latencia, por ejemplo por debajo de 500 milisegundos. El salto de red adicional hacia el bróker, la escritura en disco, la espera de un worker libre y el retorno del resultado romperán ese NFR casi con seguridad. Las colas existen para trabajos que pueden hacerse después, aunque ese «después» signifique un par de segundos.
La segunda limitación es la retroalimentación diferida sobre errores. En una API síncrona el fallo se ve al instante: el servidor devolvió error y el cliente se enteró en el acto. Con una cola el comportamiento es mucho más engañoso.
La gran trampa operativa de la arquitectura asíncrona: la cola no elimina la avería, solo la pospone y la vuelve silenciosa. El consumidor lleva una hora caído como peso muerto, pero el servidor web sigue apilando tareas en el búfer y devolviendo felices 200 OK a los usuarios. En las gráficas de entrada todo parece tranquilo, hasta que una hora después crece tal acumulación en la cola que vaciarla lleva más tiempo que la propia caída.
De ahí nace una regla de monitoreo que muchos equipos aprenden recién tras su primer gran incidente nocturno: no basta con alertar por la longitud de la cola; hay que alertar ante todo por la edad del mensaje sin procesar más antiguo. Si normalmente una tarea vive un par de segundos en la cola y el mensaje más viejo lleva allí cinco minutos, los consumidores se detuvieron, aunque el número total de mensajes en la gráfica parezca modesto.
Particionamiento y la trampa de las claves calientes
Tarde o temprano, una sola cola lineal choca con su techo de rendimiento. Para escalar horizontalmente, el flujo entrante se divide en varias subcolas independientes llamadas particiones. Distintos workers procesan distintas particiones en paralelo, y ese conjunto de workers se agrupa en un grupo de consumidores (consumer group).
Aquí manda una aritmética inflexible: dentro de un mismo grupo no puede haber más workers activos que particiones. Si tienes 8 particiones y 2 workers, cada uno tomará 4 particiones. ¿Necesitas más velocidad? Subes a 8 workers y cada uno procesa una. Pero un noveno worker en ese mismo grupo simplemente se quedará de brazos cruzados porque no quedan particiones libres para él.
Para que el bróker sepa en qué partición guardar cada mensaje nuevo, se le pasa una clave de particionamiento. Elegir esta clave exige el mismo cuidado que elegir una clave de sharding en base de datos. Aquí chocan dos requisitos. Por un lado, los mensajes con la misma clave siempre aterrizan en la misma partición, donde se respeta el orden estricto. Para operaciones no idempotentes como movimientos bancarios esto es vital: cargos y abonos de una misma cuenta deben ejecutarse en la secuencia exacta.
Por otro lado, la clave debe repartir el tráfico entre particiones sin desequilibrios. Imagina que construyes un agregador de viajes y decides particionar eventos por el campo city. El primer día, la partición de la gran metrópoli arderá al rojo vivo (lo que se conoce como partición caliente o hot partition), mientras los workers asignados a ciudades pequeñas estarán aburridos sin trabajo. Cambia la clave a user_id o ride_id y la carga se repartirá parejo. Eso sí, el orden estricto se conservará a nivel de usuario o viaje individual, no de toda la ciudad.
Particiones de Kafka: balance de workers y claves calientes
En el simulador saltan a la vista ambos límites: con 8 particiones y 9 workers, el último ejemplar queda ocioso sin importar cuántos contenedores agregues. Y si cambias la clave de city a ride_id, la barra roja recalentada desaparece y la carga se nivela. Elegir la clave siempre consiste en equilibrar orden estricto frente a reparto uniforme.
Back pressure y mensajes envenenados con DLQ
El siguiente par de problemas en producción ataca la supervivencia del bróker: desbordamiento del búfer y mensajes corruptos que atrapan a los workers en un bucle infinito.
¿Qué ocurre si los productores generan mensajes de forma constante más rápido de lo que los workers logran digerirlos? La cola se inflará hasta agotar toda la memoria RAM o el espacio en disco. Contra el desbordamiento se usan tres medidas combinadas. Primero, autoescalado: al crecer la cola, el orquestador levanta réplicas extra de workers (manteniendo margen previo de particiones donde haga falta). Segundo, back pressure (contrapresión): cuando el búfer roza el umbral crítico, el sistema deja de aceptar todo a ciegas, rechaza nuevas peticiones o devuelve un error al productor pidiéndole reintentar más tarde. Así la presión sube por la cadena en vez de tumbar el bróker en silencio. Tercero, las alertas sobre profundidad de la cola y edad del mensaje más antiguo para actuar antes de llenar el disco.
Otra avería frecuente es el mensaje envenenado (poisoned message). A veces llega a la cola una tarea que tumba a absolutamente cualquier worker: un JSON roto, un estado de pedido inválido, un formato de archivo inesperado o una combinación de campos que dispara un bug en el procesador. Sin protección, empieza un día de la marmota interminable. El worker toma la tarea, cae, el bróker la devuelve a la cola, el siguiente worker toma la misma tarea y vuelve a caer. Se queman recursos en vano y detrás se atasca el resto de la cola.
Diagrama conceptual del filtrado de un mensaje envenenado con reintentos retry y aislamiento en una cola Dead Letter Queue
El remedio estándar y probado es fijar un número máximo de intentos (max retry count). Si la tarea falla tres o cinco veces seguidas, el bróker la saca de la línea principal y la mueve a una Dead Letter Queue (DLQ), una cola o partición aparte para mensajes fallidos. Allí la revisa con calma un ingeniero, administrador o asistente de IA: busca el bug, corrige el código o descarta basura. Condición obligatoria: pon alertas cada vez que entre un mensaje en la DLQ. De lo contrario, ese depósito se vuelve un agujero negro donde desaparecen pedidos reales durante meses hasta que el equipo se entera por quejas furiosas en soporte.
Alta disponibilidad del bróker, replicación y replay del historial
Hasta ahora hablamos de la cola como si el bróker mismo fuera inmortal. En la práctica se convierte fácil en un punto único de fallo (SPOF, single point of failure): si cae la cola, se detiene la comunicación entre servicios.
Brókeres modernos como Apache Kafka resuelven esto escribiendo los mensajes en disco con una ventana de retención configurable (log.retention.hours, log.retention.ms o log.retention.bytes, por ejemplo un día, una semana o indefinidamente) y replicándolos entre varios servidores. Si cae un nodo, los datos siguen disponibles al instante desde una réplica, de forma parecida a las bases de datos.
El almacenamiento en disco trae un beneficio extra excelente: el replay, es decir, volver a reproducir el historial. Supón que ayer desplegaron un worker con un bug y estuvo medio día calculando mal las métricas o dañando índices. Despliegas la versión corregida, detienes el grupo de consumidores y retrocedes su desplazamiento (offset) en el tiempo con la utilidad kafka-consumer-groups.sh --reset-offsets (por ejemplo con --to-earliest, --to-datetime o --shift-by). El worker vuelve a leer todos los eventos del periodo deseado dentro de la ventana de retención y repara los datos.
Eso sí, Kafka guarda un detalle sutil con los propios desplazamientos: viven en el topic interno __consumer_offsets y, si un consumer group permanece inactivo más allá del límite offsets.retention.minutes, el bróker borra su posición anterior. Al arrancar de nuevo, el grupo parte según auto.offset.reset, desde el inicio o desde el final del topic, lo que puede dar una sorpresa si no lo contemplas.
Kafka, Amazon SQS y RabbitMQ: cómo elegir la herramienta adecuada
Las tres soluciones más populares están más que probadas en batalla, pero tienen arquitecturas distintas y cubren escenarios diferentes. Para no adivinar, resumimos sus diferencias clave en una tabla.
| Criterio | Apache Kafka | Amazon SQS (Standard / FIFO) | RabbitMQ |
|---|---|---|---|
| Modelo de almacenamiento | Registro distribuido en disco con ventana de retención; los mensajes no se borran al leerse | Servicio gestionado en la nube de AWS; el mensaje se borra al llamar DeleteMessage | Bróker clásico en Erlang; enrutamiento flexible mediante exchanges y bindings |
| Protección contra duplicados | Regla estricta: 1 partición = 1 consumidor por grupo | Visibility Timeout (0 s – 12 h, por defecto 30 s), extensión con ChangeMessageVisibility | Estado unack (consumer_timeout por defecto 30 min; si cae TCP, reencolado inmediato) |
| Orden y garantías | Orden estricto dentro de la partición; At-Least-Once por defecto | Standard: máxima velocidad, sin orden estricto, At-Least-Once; FIFO: orden estricto y Exactly-Once, menor velocidad | Enrutamiento flexible, At-Least-Once por defecto |
| Replay del historial | Sí (reiniciando el offset dentro de la ventana) | No (tras confirmar, el mensaje desaparece) | No (en colas clásicas) |
| Mayor fortaleza | Alto rendimiento, procesamiento de flujos de eventos, auditoría y replay | Arranque inmediato en AWS sin administrar clústeres | Reglas complejas de enrutamiento de mensajes entre servicios |
Si traducimos esta tabla a decisiones de ingeniería del día a día, la elección se aclara rápido.
Apache Kafka se elige cuando necesitas un gran volumen de eventos, alto rendimiento, almacenamiento fiable en disco y la posibilidad de rebobinar el tiempo con replay. Si un mismo evento lo leen varios equipos independientes (facturación, analítica, antifraude) y cada uno quiere avanzar por el registro a su propio ritmo, el registro distribuido de Kafka encaja mejor que nada. El precio de estas capacidades es planificar bien las particiones y mantener el clúster (o pagar una opción gestionada).
Amazon SQS ofrece el arranque más rápido y sin fricciones si tu infraestructura ya vive en AWS. Nada de servidores, clústeres ni actualizaciones nocturnas del bróker: creas la cola en un minuto y envías tráfico. Para la mayoría de tareas en segundo plano como procesar imágenes o enviar correos basta la versión Standard, que exprime el máximo rendimiento con entrega At-Least-Once. Si necesitas orden estricto y protección contra duplicados a nivel de bróker (Exactly-Once), pasas a FIFO asumiendo de entrada un techo de velocidad más modesto.
RabbitMQ se elige menos que los dos gigantes anteriores, pero en su nicho sigue siendo insustituible. Cuando necesitas enrutar mensajes con precisión hacia distintos servicios mediante intercambiadores (exchanges) y enlaces (bindings) por claves, cabeceras o patrones, este bróker tradicional en Erlang resuelve el problema con mucha más comodidad que intentar armar lógica compleja sobre particiones de Kafka. Solo recuerda vigilar el consumer_timeout de media hora en tareas largas y configurar una DLQ desde el inicio para mensajes corruptos.