Сколько минут у тебя уходит в два часа ночи, когда срабатывает алерт от незнакомого микросервиса, просто на то, чтобы выяснить, чья это система и кого из коллег будить? На дашборде растут ошибки по сервису checkout-api, который ты видишь впервые, но сами контейнеры выглядят здоровыми — значит, сбоит одна из его зависимостей. Вместо диагностики ты открываешь репозиторий, вики и чаты, превращаясь из инженера в ночного археолога.
Меня в статье инженера по надёжности Билла Дункана «Backstage #1: Who Owns This? Why SREs Want a Service Catalog», на которую обратили внимание в канале DevOps&SRE Library, зацепило одно очень точное наблюдение: ответы на простые вопросы об устройстве сервиса всегда кому-то известны, но в момент аварии этот человек либо спит, либо в отпуске, либо уволился восемь месяцев назад. Давай разберёмся, почему разрозненные вики-страницы, списки в Slack и файлы CODEOWNERS не спасают при сбоях и как сервисный каталог Backstage возвращает контроль над инфраструктурой.
Цена потерянного ownership: почему поиск владельцев сжигает время SLA
Когда в компании работают десятки микросервисов, вокруг документации складывается обманчивое чувство порядка. Кажется, что всё записано: в репозитории есть README.md, настроен CODEOWNERS, с прошлой реорганизации осталась таблица, а остальное ищется в мессенджере.
На деле при ночном инциденте с checkout-api эти опоры рассыпаются за двадцать минут. Я сопоставил популярные ожидания команд с тем, что происходит в реальности во время сбоя:
- README и вики-страницы. Ожидается, что документация в корне проекта покажет актуальную схему. На практике
README.mdобновляли два года назад для давно снесённой архитектуры, а в конфиге прописаны три хостнейма других сервисов, из которых знакомым кажется только один. Любая вики или таблица точна лишь в день создания. - CODEOWNERS и история Git. Принято считать, что владелец репозитория отвечает и за работающий сервис. В реальности из одного репозитория часто собирают несколько сервисов, а один сервис может склеиваться из разных репозиториев.
CODEOWNERSиgit blameпоказывают, кто ревьюит пулл-реквесты или трогал код полгода назад, но не говорят, кто эксплуатирует сервис в продакшене. - Поиск в Slack и привязка к людям. Кажется, что поиск по имени
checkout-apiв чатах даст ответ за минуту. На деле находится весенний тред с упоминанием команды, которую уже разделили на две новые группы. Ты будишь дежурного по угаданной ротации, а он вежливо отвечает, что сервис не их, и кивает на Сэма — который сейчас в отпуске.
За этой археологией стоят пять вопросов дежурного: кто владеет сервисом, чей это репозиторий, от чего узел зависит и что зависит от него, кто профильный эксперт (SME — Subject-Matter Expert) и кто сейчас на дежурстве. Если записывать ответственность на конкретного человека или полагаться на одного незаменимого эксперта, получается единая точка отказа из живого сотрудника. Потери идут и днём: новички неделями собирают ту же карту в голове, а бесхозные «зомби-сервисы» годами жгут облачный бюджет, потому что никто не уверен, безопасно ли их выключить.
Структура манифеста catalog-info.yaml: описание компонентов рядом с кодом
Чтобы данные о сервисе не устаревали, они должны жить рядом с кодом. На этом принципе построен Backstage Software Catalog — ядро открытого портала разработчиков, созданного в Spotify и переданного в фонд CNCF.
Каждый сервис описывает себя в файле по спецификации catalog-info.yaml прямо в корне своего Git-репозитория. Любая смена владельца или зависимостей проходит через обычные пулл-реквесты и код-ревью самой команды разработки.
Посмотрим, как описывается наш сервис оформления заказов checkout-api. Чтобы дежурный в одном окне увидел команду-владельца, связанные узлы, статус подов и текущего дежурного, в корень репозитория кладётся манифест из 15 строк:
apiVersion: backstage.io/v1alpha1
kind: Component
metadata:
  name: checkout-api
  description: Cart checkout and payment handoff
  annotations:
    pagerduty.com/service-id: PXXXXXX
    backstage.io/kubernetes-id: checkout-api
spec:
  type: service
  lifecycle: production
  owner: group:payments
  system: storefront
  dependsOn:
    - component:inventory-api
    - resource:orders-db
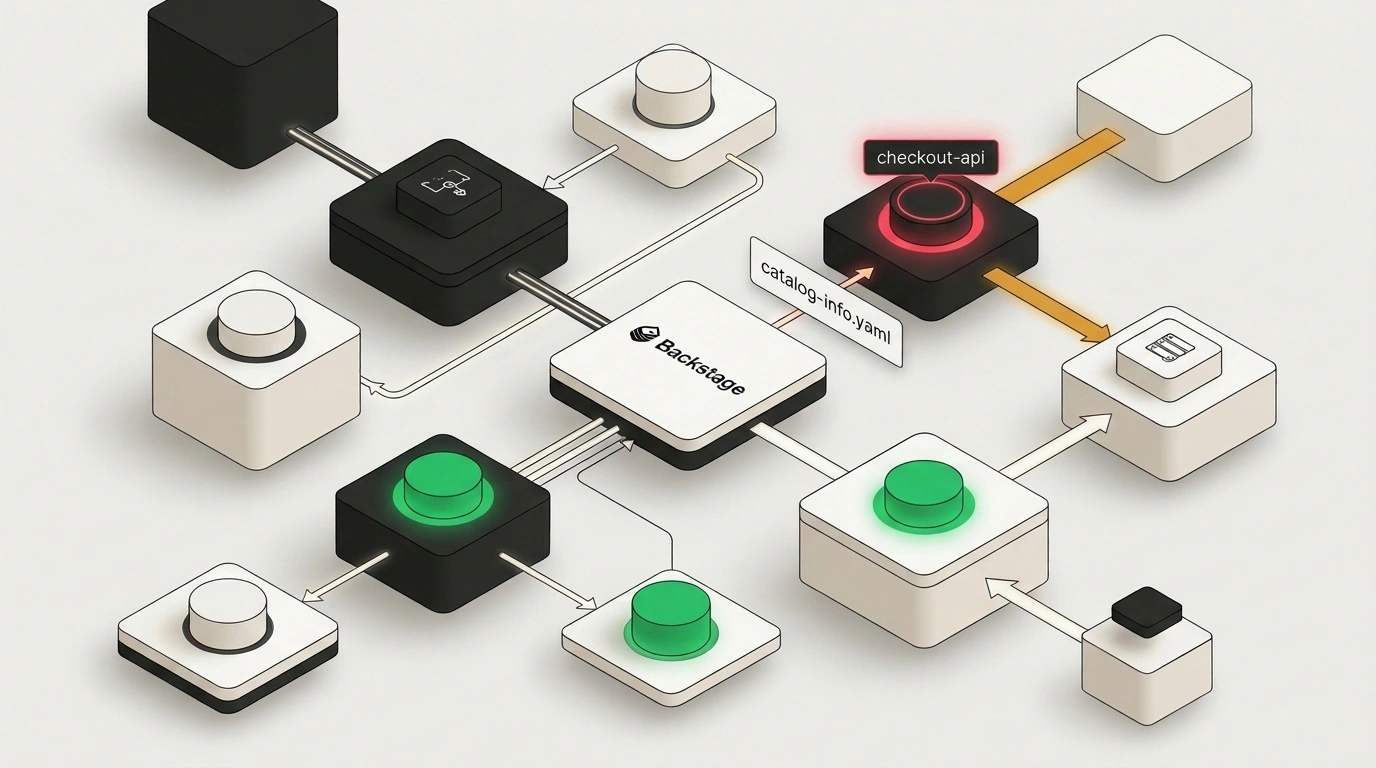
После регистрации файла в каталоге секция spec привязывает компонент checkout-api (type: service, lifecycle: production) к системе storefront, а поле owner: group:payments закрепляет владение за командой, а не за отдельным человеком. На странице группы payments собраны состав участников, канал в Slack и графики смен — даже без прямого указания эксперта (SME) карточка сразу выводит на нужных инженеров.
Блок metadata.annotations связывает описание с живой эксплуатацией. Ключ pagerduty.com/service-id: PXXXXXX подтягивает ротацию дежурств, а backstage.io/kubernetes-id: checkout-api указывает плагину оркестратора, какие поды показывать на странице. В итоге здоровье контейнеров, история пайплайнов, ссылки на дашборды и имя текущего дежурного оказываются на одном экране без переключения между пятью вкладками браузера.
Разворот графа зависимостей и расчёт радиуса поражения
Следующая задача — оценка радиуса поражения сбоя (blast radius). Она нужна и ночью на инциденте («проблема в checkout-api или упало то, к чему он обращается?»), и днём перед работами («если я обновлю базу orders-db или осушу пул нод, что сломается вокруг?»).
По коду checkout-api видно только первую половину — от кого зависит сам сервис. Но почти никто не может без опроса по чатам быстро ответить на вторую половину: кто снаружи зависит от этого узла? В репозитории базы данных нет списка всех микросервисов, которые ходят к ней по сети.
Массив dependsOn в манифесте Backstage решает эту задачу автоматически. Когда каждый сервис перечисляет свои прямые зависимости (component:inventory-api, resource:orders-db и контракты providesApis), каталог собирает направленные связи со всех репозиториев и разворачивает граф в обе стороны. Открыв карточку orders-db, ты сразу видишь стрелку к checkout-api. Ночью это мгновенно переводит поиск от здорового checkout-api к сбоящему inventory-api, а днём перед обновлением БД показывает список всех зависимых команд.
Интеграция с дежурствами и защита каталога от устаревания
Тут у тебя наверняка возникнет вопрос: поднять Backstage и один раз разложить по репозиториям файлы catalog-info.yaml несложно, но как заставить продуктовых разработчиков обновлять этот YAML через полгода? Не превратится ли каталог в очередную заброшенную вики?
По-моему, Билл Дункан очень трезво называет это главным подвохом внедрения: сильнее всего каталог нужен инженерам SRE, но сами SRE не могут поддерживать его точность — данными владеют продуктовые команды. Каталог, запущенный силами SRE без участия разработки, устареет по тому же графику, что и старая таблица.
Чтобы манифесты оставались живыми, их проверку встраивают в рабочий конвейер:
- Автодискавери и проверка в CI. В
app-config.yamlвключается автоматический сбор файлов из GitHub или GitLab, а в CI добавляется линтер, проверяющий при каждом пулл-реквесте схемуcatalog-info.yamlи существование команды из поляowner. - Польза для разработчиков и ИИ-агентов. Когда карточка сервиса объединяет статус подов, деплои и графики, авторы кода открывают её каждый день (а как настроить аудит событий внутри кластера, я разбирал в статье об инженерии детекции в Kubernetes). При этом единый граф позволяет находить ответы за секунды не только дежурному человеку, но и ИИ-агентам, помогающим диагностировать сбои.
Создай шаблон catalog-info.yaml на 15 строк для ключевых сервисов: закрепи owner за группой (group:...), перечисли зависимости в dependsOn и подключи аннотации дежурств и подов. Этого хватит, чтобы закрыть четыре из пяти вопросов ночного дежурства.
Сервисный каталог не делает ответы об архитектуре умнее — он делает их находимыми за секунды без необходимости будить единственного человека, который помнит историю проекта. А если прямо сейчас выбрать один критичный сервис в твоём продакшене и мысленно отключить рабочий мессенджер — сколько минут уйдёт у дежурного, чтобы по одному лишь репозиторию найти актуальный график дежурств и понять, какие системы рухнут при отказе этого узла?