На синтетическом тесте в 26 миллионов строк таблица в PostgreSQL со случайным первичным ключом UUIDv4 принимает новые записи почти с той же скоростью, что и последовательный счётчик. Меня в свежем исследовании основателя PostgresAI Николая Самохвалова, на которое я наткнулся в выпуске Postgres Weekly, сразу зацепил этот стартовый отрезок — он наглядно объясняет, почему на тестовом стенде случайные идентификаторы кажутся совершенно бесплатными.
Подвох вскрывается, когда проект перерастает объём оперативной памяти. Как только индекс перестаёт помещаться в буферный кэш сервера, база внезапно теряет треть скорости записи, а накопитель задыхается под лавиной мелких операций. Давай разберёмся, какова реальная цена случайных ключей за пределами RAM и как упорядоченный по времени формат UUIDv7 возвращает базе предсказуемую скорость.
Физика хранения B-tree: почему случайные ключи бьют по страницам индекса
Возьмём понятную рабочую картину: таблица заказов orders с первичным ключом UUIDv4 разрослась на диске до 50 ГБ, тогда как под буферный пул (Shared Buffers) на сервере выделено 16 ГБ.
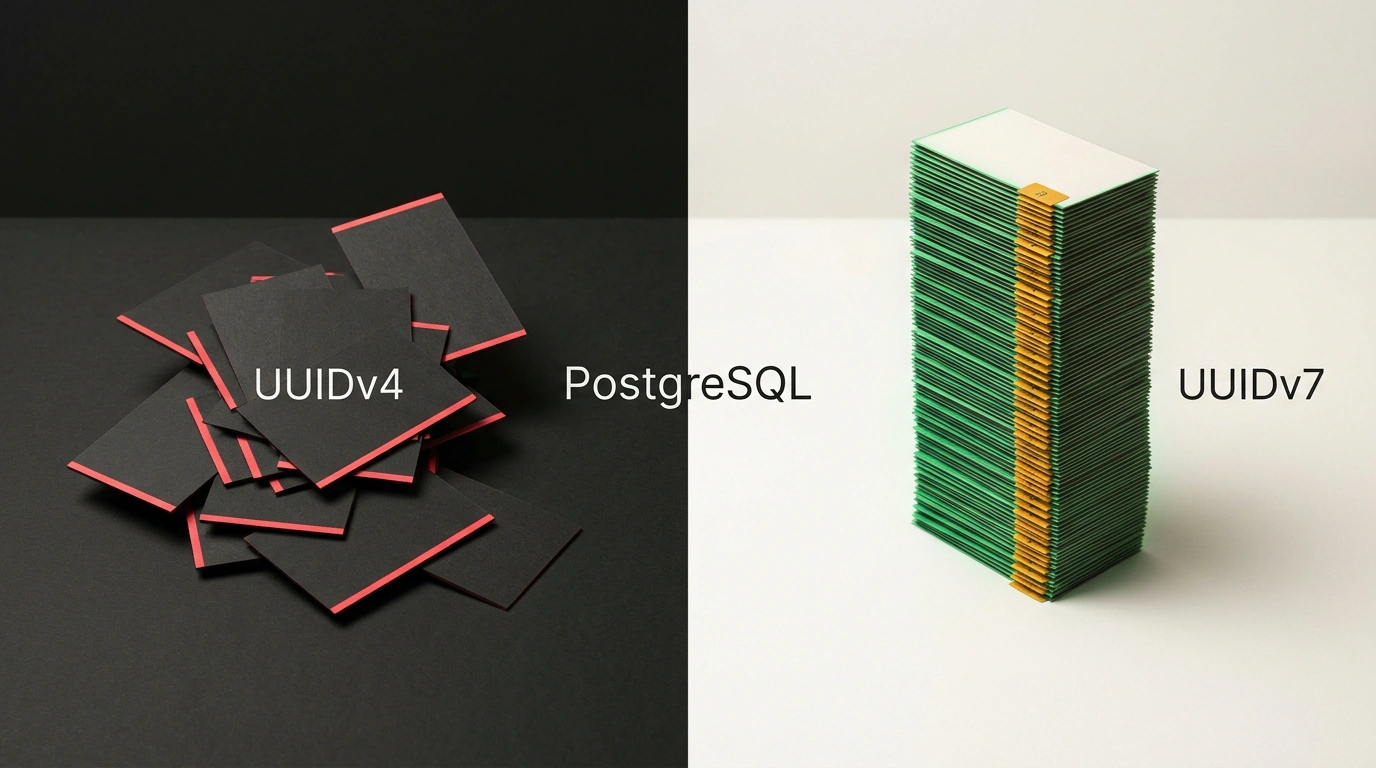
Представь эту систему как бумажный архив со стеллажами папок. Каждая папка — это листовая страница индекса B-tree размером 8 КБ, где карточки заказов лежат строго по возрастанию номера. Перед архивариусом стоит рабочий стол — наша память Shared Buffers. На столе помещается лишь треть папок со склада, а за остальными приходится бегать к дальним полкам, то есть обращаться к SSD.
Когда заказы приходят с последовательными номерами, архивариус держит на столе одну крайнюю правую папку для свежих записей и докладывает карточки в конец. Заполнилась папка — открыл рядом новую, а старую убрал на стеллаж и забыл о ней.
Теперь заменим счётчик на классический идентификатор UUIDv4 из функции gen_random_uuid(). Из 128 бит его длины 122 бита — чистая случайность. У таких ключей нет понятия «раньше» или «позже»: один заказ получает номер на букву f, следующий — на 0, третий — на 8.
Для архивариуса это оборачивается кошмаром. Каждая новая карточка по правилам сортировки B-tree должна лечь не в конец списка, а в случайную папку посреди склада. Поскольку на столе помещается малая часть индекса, нужной папки почти никогда нет под рукой. На каждую вставку процессу PostgreSQL приходится сбрасывать со стола старую изменённую («грязную») страницу на диск, читать со стеллажа нужный блок и втискивать строку в середину. А когда старая папка переполняется, происходит расщепление страницы (B-tree page split): база выделяет новый блок, делит записи пополам и переписывает обе страницы вместе с указателями в родительском узле.
Бенчмарк PostgresAI: обвал записи на треть и раздувание журнала WAL
Эту физику Николай Самохвалов проверил на дистанции до 100 миллионов строк, сравнив случайный UUIDv4, упорядоченный UUIDv7 и целочисленные последовательности при дефиците оперативной памяти.
Пока таблица и индекс целиком умещались в Shared Buffers, графики шли вровень: в оперативной памяти обращение к крайней правой или случайной странице занимает одинаковые наносекунды. Но как только индекс перерос буферный кэш, пропускная способность вставок UUIDv4 рухнула до 62–69% от скорости упорядоченного ключа — запись замедлилась примерно на треть. В нашей таблице orders это означает просадку потока инсертов до 65% от нормы только из-за случайного чтения страниц индекса с SSD.
Второй удар пришёлся по журналу предзаписи (Write-Ahead Logging, или WAL), куда база синхронно пишет каждое изменение перед подтверждением транзакции (о связи этого журнала с надёжностью и очисткой страниц я рассказывал в разборе архитектуры PostgreSQL, работы журнала WAL и механизмов MVCC). Когда я открыл замеры WAL в бенчмарке Самохвалова, цифры оказались ещё красноречивее: вставки UUIDv4 сгенерировали в 1,5–1,9 раза больше трафика логов на строку по сравнению с UUIDv7.
Почти двукратный перерасход логов вызывают два механизма:
- Частые расщепления страниц: при каждом
page splitСУБД логирует вWALфизическое перемещение половины старой страницы в новый блок. - Полностраничные образы (
Full Page Writes): для защиты от сбоя питания после контрольной точки (checkpoint) PostgreSQL при первом изменении любой страницы сохраняет вWALеё полную копию. ПосколькуUUIDv4хаотично меняет тысячи страниц по всему дереву, в журнал летят гигабайты полных образов.
Анатомия UUIDv7: как префикс времени мирит уникальность с порядком
Долгое время инженеры выбирали из двух крайностей. Целочисленные ключи serial, bigserial или IDENTITY занимают 4–8 байт и укладывают записи в правый край B-tree, но выдают конкурентам объёмы заказов и неудобны в распределённых системах, где ID нужен до похода в базу. А UUIDv4 позволяет генерировать ключи автономно на любом узле, но наказывает деградацией диска при росте таблицы.
Стандарт RFC 9562 решил это противоречие в формате UUIDv7, разделив ключ на две зоны:
- Старшие 48 бит занимает
Unix-таймстемп в миллисекундах, задающий направление роста для новых записей. - Младшие биты (после маркеров версии и варианта) содержат субмиллисекундный счётчик и криптографическую случайность против коллизий.
Поскольку сравнение ключей в B-tree идёт слева направо, префикс времени выстраивает новые идентификаторы в хронологическую очередь. Заказ, оформленный секундой позже, гарантированно получает ключ больше предыдущего, а случайный хвост разводит покупки, пришедшие в одну миллисекунду.
Для архивариуса это спасение: все свежие записи таблицы orders снова ложатся строго в правый край дерева. В буферном пуле постоянно живут несколько крайних «горячих» страниц индекса, объём WAL снижается на 30–45%, а реплики перестают отставать от мастера.
Переход на uuidv7() в PostgreSQL 18 и подводные камни в продакшене
Начиная с PostgreSQL 18 функция uuidv7() встроена прямо в ядро СУБД без внешних расширений (о будущих улучшениях индексов B-tree я также писал в обзоре релиз-кандидата Postgres 19 и оптимизации сканирования UUID).
Переключим таблицу orders со случайного генератора gen_random_uuid() на упорядоченный uuidv7() и выберем последние заказы без отдельного индекса по дате:
-- Мгновенно переключаем генератор новых ключей в метаданных таблицы
ALTER TABLE orders ALTER COLUMN id SET DEFAULT uuidv7();

-- Забираем 50 самых свежих заказов обратным проходом по первичному ключу
SELECT id, created_at, total_amount
FROM orders
ORDER BY id DESC
LIMIT 50;
Команда ALTER TABLE выполняется за миллисекунды: она меняет только правило по умолчанию в системном каталоге, не перезаписывая накопленные гигабайты. Старые строки с UUIDv4 остаются на местах, а новые заказы сразу формируют упорядоченный участок на правом краю индекса, возвращая скорость вставки к норме. Запрос SELECT с ORDER BY id DESC LIMIT 50 даёт приятный бонус: за счёт префикса времени база мгновенно отдаёт последние записи обратным чтением крайних страниц первичного ключа без отдельного индекса по created_at.
При этом Николай Самохвалов выделяет два ограничения при переходе на UUIDv7:
- Генерация в СУБД против клиентов. Если создавать
UUIDv7не черезDEFAULT uuidv7()в базе, а на множестве серверов приложений, рассинхронизация часов между узлами (дрейф на ±60 секунд) нарушит монотонность ключей и частично вернёт расщепление страницB-tree. - Открытая метка времени в публичных ID. Префикс
UUIDv7легко декодируется в точную дату и миллисекунду создания записи, раскрывая время оформления заказа во внешних URL.
По-моему, лучшее правило здесь простое: доверь вызов uuidv7() самому серверу PostgreSQL с его едиными системными часами, а если время создания записи относится к чувствительным метрикам — не выставляй внутренний ключ в публичные адреса без маскировки.
В конечном счёте выбор первых шести байт в первичном ключе — это история не про рекорды в синтетических тестах, а про обычное инженерное спокойствие. Когда схема таблицы дружит с физикой диска и памяти, база перестаёт будить команду ночными алертами о переполненном хранилище и отстающих репликах, оставляя тебе свободное время и ясную голову для созидательных задач.