В классической компиляции заложено противоречие. Компилятор обязан превратить исходный код в быстрые машинные инструкции ещё на этапе сборки — когда программа ни разу не запускалась под живым трафиком и никто не знает, какая ветка if сработает миллион раз в секунду, а какая пригодится раз в месяц для редкой ошибки. В то же время рабочий сервер в продакшене каждую секунду знает свои узкие места, но уже не может переписать собственный машинный код на лету.
Разрешить этот парадокс помогает профильная оптимизация — Profile-Guided Optimization в Go (PGO, она же Feedback-Directed Optimization). Мы снимаем профиль нагрузки с работающего сервиса и передаём его компилятору при сборке следующего релиза. Как отмечают авторы канала «Библиотека Go-разработчика», такой цикл ускоряет программу без правки бизнес-логики, но при одном условии: компилятор должен учиться на реальном трафике, а не на искусственных тестах. Я разобрал документацию и механику сборки, чтобы показать, как выжать из Go-сервиса дополнительную скорость с помощью PGO и не навредить в пограничных сценариях.
Чему компилятор учится у рантайма: инлайнинг и работа с вызовами
Представь, что ты собираешь чемодан в поездку вслепую: не зная маршрута, приходится укладывать вещи равномерно, и на вокзале за зарядкой вечно нужно лезть на самое дно. Статический компилятор находится в таком же положении и опирается на осторожные догадки, чтобы не раздуть исполняемый файл.
Экспериментальная поддержка PGO появилась в Go 1.20, а с Go 1.21 она включена по умолчанию. Компилятор получил «глаза» в виде стандартного CPU-профиля pprof. По замерам команды Go (начиная с Go 1.22), сборка с профилем ускоряет репрезентативные программы на 2–14% за счёт трёх механизмов:
- Прицельное встраивание функций (инлайнинг). Вызов функции тратит такты процессора на сохранение контекста и прыжок в памяти. Компилятор умеет вставлять тело маленькой функции прямо в место вызова, но инлайнить всё подряд нельзя: бинарник распухнет, а быстрый кэш инструкций процессора (L1i) забьётся холодным кодом. По профилю CPU компилятор видит реальную нагрузку и агрессивно инлайнит именно горячие функции.
- Девиртуализация интерфейсов и оптимизация ветвлений. При вызове метода через интерфейс рантайм ищет адрес в таблице методов. Если профиль показывает, что за интерфейсом почти всегда стоит один конкретный тип, компилятор заменяет косвенный вызов прямым переходом с быстрой проверкой и выстраивает ветвления без сбросов конвейера процессора.
- Пересборка зависимостей и стандартной библиотеки. Профиль применяется ко всей программе целиком. Это похоже на то, как низкоуровневая архитектура аллокатора памяти в Go 1.27 ускоряет выделение мелких объектов без правки кода — только с PGO компилятор перекраивает библиотечные пакеты конкретно под паттерны твоего сервиса.
Посмотрим на сквозной пример: высоконагруженный API-микросервис в дневной пик принимает поток запросов и сериализует объёмные ответы в JSON. Без профиля методы парсинга и работы с буферами вызываются по цепочке через стандартные обёртки. Получив профиль дневного пика, компилятор видит, что основное время CPU уходит на внутренние функции сериализации JSON, и встраивает их прямо в горячий путь обработчика.
Сбор репрезентативного профиля pprof: ловушка синтетических тестов
Тут легко поддаться соблазну сэкономить время: зачем снимать метрики с боевых серверов, если можно за минуту прогнать локальный тест go test -bench и отдать профиль компилятору?
По-моему, это самый коварный капкан при знакомстве с PGO. Синтетический микробенчмарк гоняет по кругу изолированный кусок кода — например, тысячу раз сериализует одну мелкую структуру в пустой буфер в отрыве от сети и HTTP-заголовков. Если собрать наш API-микросервис по такому профилю, компилятор потратит бюджет инлайнинга на искусственный цикл, а реальные горячие пути сетевого стека и сложных JSON-ответов останутся без оптимизации.
Даже в продакшене одиночный замер бывает обманчивым: случайный под может простаивать, выполнять пятиминутную фоновую задачу или получать перекошенную выборку запросов. Поэтому документация Go рекомендует снимать CPU-профили через пакет net/http/pprof с нескольких инстансов и склеивать их.
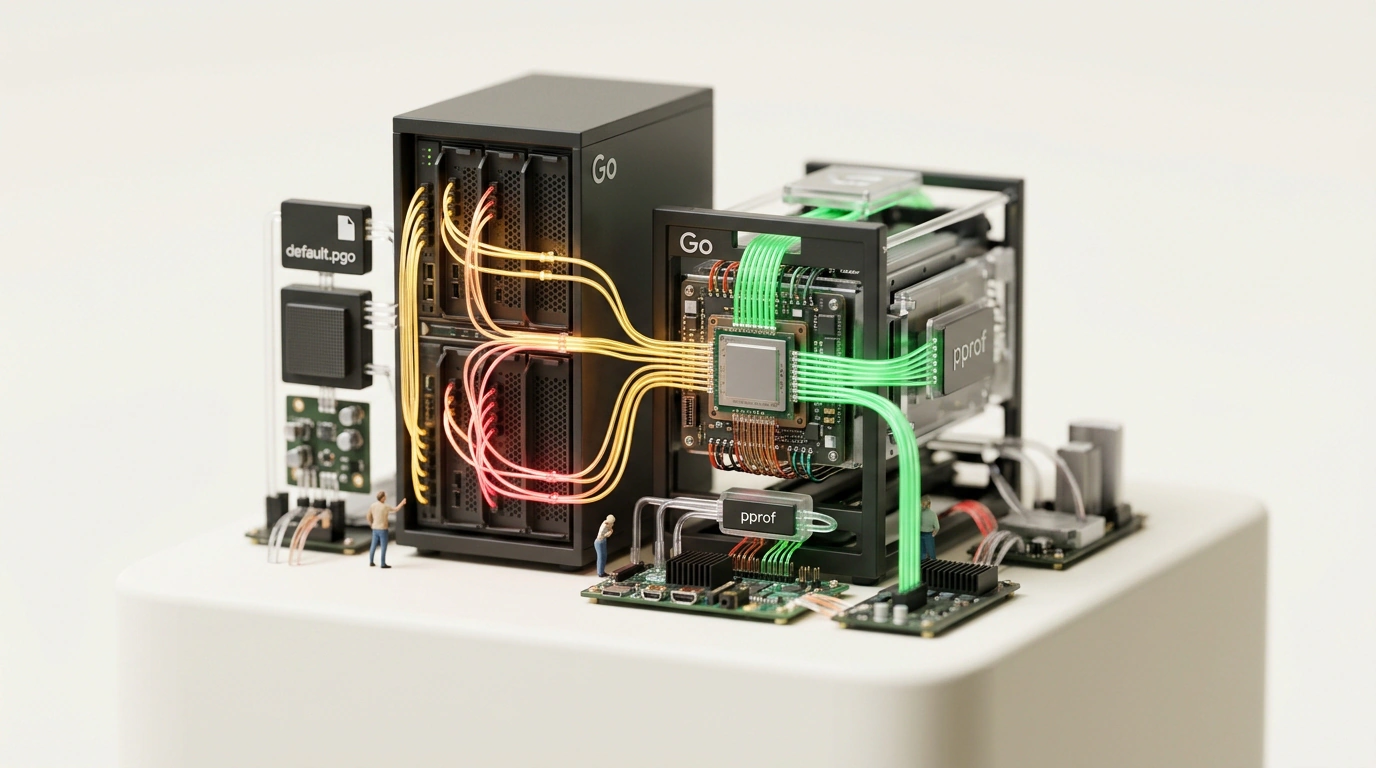
Соберём два 30-секундных профиля с узлов нашего API-микросервиса в дневной пик и объединим их утилитой pprof в файл default.pgo:
# Снимаем 30-секундные профили CPU с двух узлов на пике трафика
curl -o cpu-node1.pprof "http://10.0.1.15:6060/debug/pprof/profile?seconds=30"
curl -o cpu-node2.pprof "http://10.0.1.16:6060/debug/pprof/profile?seconds=30"

# Склеиваем сэмплы в единый профиль для компилятора
go tool pprof -proto cpu-node1.pprof cpu-node2.pprof > default.pgo
Параметр seconds=30 в обоих запросах должен совпадать. Команда go tool pprof -proto просто суммирует сэмплы из входных файлов без поправки на длительность замера (wall duration): если один профиль снимался 30 секунд, а второй — 5 минут, длинный замер перетянет вес оптимизации на себя. И помни про безопасность: маршруты /debug/pprof/* нельзя открывать наружу — порт 6060 должен быть доступен только внутри изолированной сети кластера.
Автоматический подхват default.pgo и проверка бинарника через go version -m
Рабочий процесс строится по замкнутому циклу AutoFDO: выпускаем первичный бинарник без PGO, собираем профиль в проде и используем его при сборке следующего релиза. Достаточно положить файл default.pgo в каталог пакета main и закоммитить в репозиторий для воспроизводимости сборок. Утилита go build по умолчанию работает в режиме -pgo=auto и подхватывает default.pgo автоматически.
Положим профиль в каталог микросервиса, соберём боевой и контрольный бинарники и проверим метаданные компиляции (механика проверена на релизе Go 1.27.3):
# Кладем профиль в каталог main-пакета и собираем оба варианта
mv default.pgo ./cmd/api-service/default.pgo
cd ./cmd/api-service
go build -o service .
go build -pgo=off -o service-no-pgo .

# Проверяем подключение профиля в скомпилированном бинарнике
go version -m service | grep pgo
Вывод последней команды покажет параметр -pgo=.../default.pgo, подтверждая, что компилятор нашёл и применил профиль. Если в репозитории несколько сервисов и ты передаёшь путь вручную через go build -pgo=/tmp/api.pprof ./cmd/api ./cmd/worker, учти, что явный флаг применит один профиль сразу ко всем пакетам main. При этом, как подчёркивают в «Библиотеке Go-разработчика», сама строчка -pgo в go version -m подтверждает лишь подключение файла при сборке, но не доказывает ускорения в проде.
Контрольная сборка -pgo=off, цена оптимизации и границы применимости
Чтобы доказать выигрыш на деле, мы и собрали контрольный бинарник service-no-pgo с флагом -pgo=off. Оба файла выкатывают под одинаковую нагрузку и сравнивают потребление CPU и время ответа. В нашем API-микросервисе такое сравнение показывает, что инлайнинг горячих методов сериализации JSON реально снижает задержку ответов на пике трафика.
Но за ускорение в 2–14% приходится платить компромиссами:
- Время первой сборки и размер бинарника. Профиль перестраивает граф зависимостей и стандартную библиотеку, поэтому первая компиляция с новым
default.pgoидёт дольше (дальнейшие сборки берут результат из кэша), а бинарник слегка прибавляет в весе из-за инлайнинга. - Устаревание профиля при рефакторинге (
source stability). Меня порадовало, что компилятор привязывает сэмплы к коду по смещениям строк от начала функции (line offsets), игнорируя имена файлов. Правки вне горячей функции и её перенос в другой файл того же пакета не ломают PGO. Но при переименовании методов, переносе в другой пакет или правке их тела привязка теряется — оптимизация плавно деградирует до обновления профиля. - Один бинарник для разных нагрузок. Если один файл работает и на чтение, и на запись с разными горячими путями, придётся либо собирать отдельные версии, либо профилировать главный режим, либо склеивать профили всего флота.
При этом Go PGO защищён от «качелей» скорости между релизами (iterative stability): консервативный подход компилятора не даёт ускоренной функции выпасть из числа горячих при следующей сборке, поэтому новый профиль можно снимать прямо с уже оптимизированного бинарника. А о том, как рантайм распределяет задачи по ядрам процессора, я рассказывал в разборе анатомии планировщика Go и модели GMP.
Главное с PGO — сохранять чувство меры и не превращать пересборку default.pgo в культ. Флаг компилятора не заменит индекс в базе и не вылечит блокировки на синхронных вызовах. Настрой спокойный сбор 30-секундных срезов pprof на пике нагрузки, положи default.pgo в пакет main, сверь сборку через go version -m и контрольный -pgo=off — и обновляй профиль, когда в коде меняются горячие пути.