Si sigues de cerca el mercado tecnológico, seguro que has visto lo rápido que estalló la burbuja del llamado «prompt engineering». Hace apenas año y medio, internet rebosaba de anuncios que vendían colecciones de «frases mágicas para ChatGPT», y marketers de toda la vida se cambiaban el titular del perfil a «consultor de IA» de la noche a la mañana prometiendo automatizar cualquier empresa en dos horas. El desenlace era predecible: los negocios se cansaron pronto de chatbots sin sentido que quedaban muy bien en la demo, pero en producción alucinaban sin remedio, confundían el stock del almacén y sacaban de quicio a los clientes.
Hoy las reglas del juego han cambiado por completo. La consultoría aplicada de IA ha dejado de ser una charla inspiracional para convertirse en una disciplina estricta de ingeniería y operaciones. Los clientes ya no quieren discursos entusiastas sobre cómo funcionan los transformers: quieren eliminar atascos concretos que les cuestan dinero y tiempo. Nick Saraev, fundador de la agencia LeftClick —cuyo equipo superó los $70,000 de ingresos mensuales recurrentes (MRR)—, estructuró su experiencia desplegando sistemas agénticos en un marco de trabajo de seis pasos.
He analizado a fondo esta metodología y la he contrastado con cómo funciona hoy la automatización práctica sobre modelos Claude. Vamos a desmontar este mecanismo pieza por pieza: cómo hacer una auditoría de cuellos de botella, por qué la factorización de objetivos importa más que escribir código y cómo diseñar pipelines que no se rompan al primer fallo.
Anatomía del rol de consultor de IA: por qué terminó la era de «vender prompts»
Seamos claros: la consultoría de gestión clásica al estilo de las Big Four suele provocar un rechazo sordo en la mayoría de los empresarios. Te envían una presentación PDF de noventa diapositivas, te cobran decenas de miles de dólares y te dejan solo con recomendaciones abstractas del tipo «optimiza tu embudo de captación de leads».
En la consultoría de IA de nueva generación, el enfoque es diametralmente opuesto. No actúas como un consejero teórico, sino como arquitecto e implementador directo de un sistema software-agéntico que funciona. Tu trabajo no consiste en enseñar a un empleado a escribir peticiones en una interfaz web, sino en construir entre bastidores un pipeline autónomo en el backend al que nadie tenga siquiera que asomarse.
De la experiencia de LeftClick me llamó la atención su modelo financiero, tremendamente sobrio. Aquí no hay cobros por horas en llamadas interminables donde el consultor alarga el chicle. La economía del proyecto se divide en dos fases claras:
- Tarifa fija por auditoría y diseño de arquitectura ($5,000–$15,000): Por ese importe haces una radiografía de los procesos del negocio, localizas la restricción raíz y construyes un prototipo funcional (MVP).
- Retainer mensual de servicio ($3,000–$10,000 por cada proceso automatizado): Incluye el mantenimiento de los pipelines, monitorización de errores, actualización de las instrucciones del sistema cuando salen nuevos modelos y ajuste continuo de las pruebas de evaluación.
Este modelo genera un negocio predecible y con márgenes altos. El cliente paga encantado $5,000 al mes por un sistema que sustituye el trabajo rutinario de tres operadores, no pide bajas médicas, no se quema los viernes por la tarde y procesa solicitudes en treinta segundos en lugar de cuatro horas. En nuestro análisis sobre la economía de la adopción de la IA y el rol del Forward Deployed Engineer ya vimos cómo el enfoque de ingeniería está desplazando a la consultoría teórica; aquí tenemos una confirmación directa en la práctica.
Auditoría con el marco RACE: cómo detectar pérdidas reales de tiempo y dinero
El error más habitual de quien empieza en automatización es lanzarse a por lo primero que parece fácil. Por ejemplo, montar un script que genere publicaciones para el canal de Telegram de la empresa. Suena genial, se configura en una tarde, pero el retorno financiero para el negocio es cero.
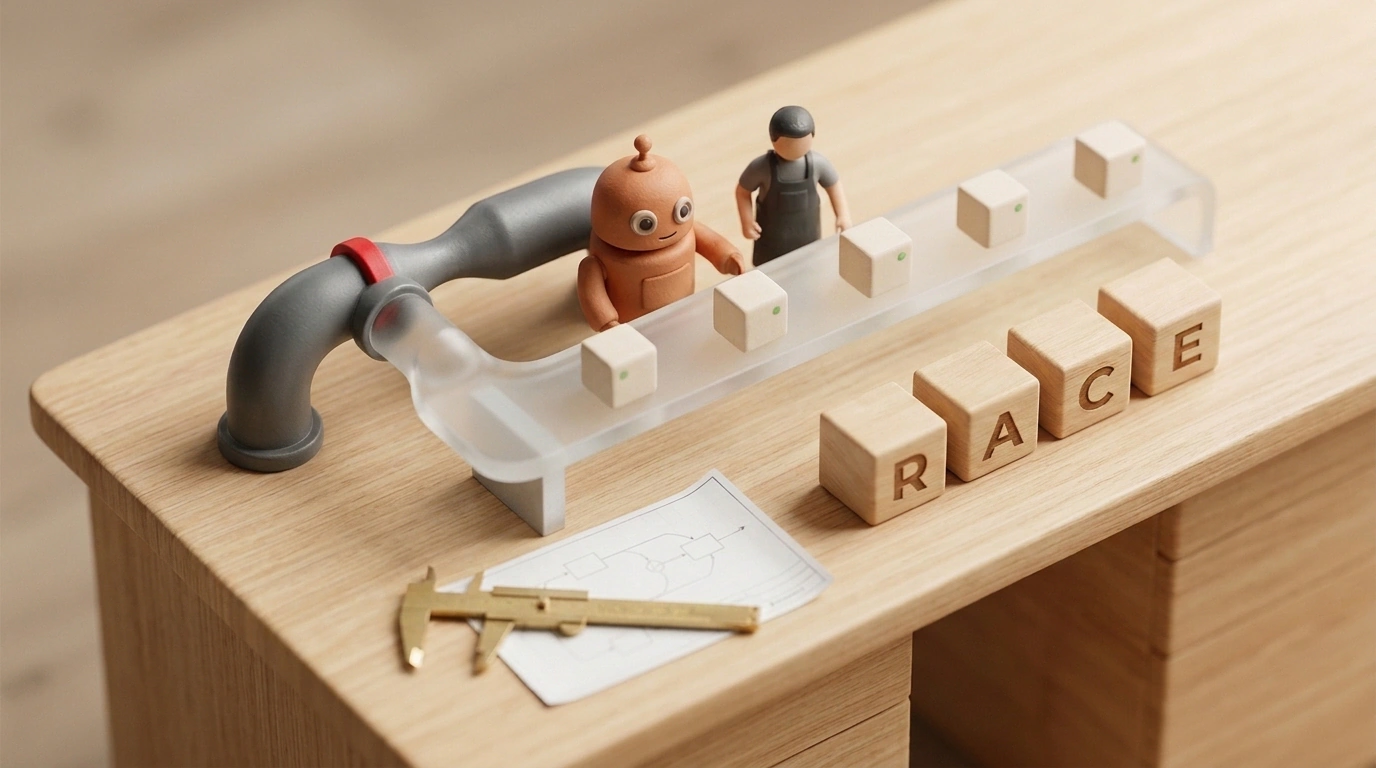
Según la teoría clásica de las restricciones de Eliyahu Goldratt, optimizar cualquier tramo de un sistema que no sea el punto más estrecho (bottleneck) es pura ilusión de productividad. Imagina una tubería por la que corre agua: si en el centro el tubo está aplastado hasta tener el grosor de un lápiz, ensanchar la boca de entrada solo hará que la tubería reviente por la presión, sin que salga ni una gota más al final.
Para encontrar ese tapón, Nick Saraev aplica el marco RACE. Veamos en qué consiste cada fase:
- R (Review — Revisión de procesos): Te sientas junto a los empleados clave o les pides que compartan pantalla. Tu objetivo es localizar tareas que devoran entre el 20% y el 60% de la jornada de especialistas cualificados. Anotas literalmente cuántas pestañas tienen abiertas en el navegador, qué datos copian a mano del correo al CRM, dónde rellenan informes idénticos y por qué aprobar un contrato tarda tres días.
- A (Automate — Aislamiento de puntos de automatización): Aquí descartas las tareas que exigen intuición creativa o negociaciones complejas y te quedas con las cadenas mecánicas repetitivas. El principio es simple: el proceso debe descomponerse en pasos elementales donde, en cada paso, el modelo ejecute exactamente una transformación de datos.
- C (Consolidate — Consolidación del conocimiento): Es los cimientos del futuro sistema. En la mayoría de empresas, los protocolos están dispersos por chats privados, acuerdos verbales y documentos sueltos. El consultor reúne toda esa masa desestructurada en archivos Markdown planos y legibles por máquina: respuestas modelo ideales, listas de precios, matrices de excepciones y reglas de escalado.
- E (Evaluate — Fijación de métricas): Se definen de antemano criterios estrictos de éxito. Nada de «ahora es más cómodo», sino cifras duras: reducir el tiempo de respuesta a un lead de 4 horas a 90 segundos, bajar la tasa de errores al rellenar datos fiscales al 0.5% o liberar 25 horas semanales del responsable de área.
La llamada de diagnóstico: las preguntas exactas que destapan los puntos de dolor
La primera conversación con el dueño o el director de operaciones no es una pasarela para lucir tus conocimientos técnicos. Olvídate de términos como «embeddings», «búsqueda vectorial» o «ventana de contexto»: a la empresa solo le asustan. Una llamada de diagnóstico (Discovery Call) se plantea como una consulta médica.
He seleccionado cuatro preguntas de calibración que permiten llegar al meollo del problema en cuarenta minutos:
- «Si mañana se multiplicara por cinco el volumen de solicitudes entrantes, ¿en qué punto exacto se ahogaría primero vuestro proceso?» Esta pregunta deja al descubierto al instante el eslabón más débil de la cadena de valor.
- «¿Cuál es el trabajo más aburrido y mecánico que vuestros mejores gestores tienen que hacer cada lunes?» La respuesta muestra dónde quema la empresa su talento más caro en tareas de nivel becario.
- «¿Dónde le cuesta más dinero a la empresa un despiste humano o una errata?» Aquí aparecen los escenarios con pérdidas financieras directas: fallos al calcular especificaciones, renovaciones de contratos olvidadas o datos bancarios mal introducidos en facturas.
- «¿Cuántas horas a la semana se van en copiar información entre sistemas —del correo al CRM, del CRM a 1C, del chat a Excel—?» Son candidatos inmediatos para montar pipelines en segundo plano.
El resultado de esta llamada no es un plan abstracto a un año vista, sino el acuerdo para ejecutar un único escenario piloto con retorno claro en los primeros 60 días.
Factorización de objetivos (Goal Factoring): convertir KPIs de negocio en un grafo de tareas para el agente
Una vez localizado el cuello de botella, llega la fase de ingeniería más crítica: la factorización de objetivos (Goal Factoring). Este método procede del análisis de sistemas aplicado y es lo que separa un sistema fiable de un apaño frágil.
Esquema estructural de factorización de objetivos: un grafo en árbol descompone una métrica de negocio en pasos atómicos desde el webhook hasta el CRM.
La clave está en no darle jamás a la red neuronal una tarea de alto nivel entera de golpe. Un prompt del estilo «Analiza el correo entrante, cualifica al cliente, consulta la base de datos y redacta una propuesta comercial» es una receta garantizada para el desastre. El modelo se liará con las prioridades, pasará detalles por alto y acabará alucinando.
En lugar de eso, el objetivo general se desglosa en un grafo en árbol. Supongamos que la empresa quiere «Aumentar en un 35% la conversión de solicitudes B2B entrantes». Mira cómo queda una descomposición bien hecha:
- Estrategia 1: Reducir a dos minutos el tiempo de primer contacto con el lead.
- Subtarea 1.1 (Parser): Capturar el webhook del formulario web, validar email y teléfono, y limpiar el texto de spam.
- Subtarea 1.2 (Enriquecimiento de datos): Consultar APIs externas (registros mercantiles, fuentes públicas) para extraer sector de actividad y tamaño aproximado de la empresa.
- Subtarea 1.3 (Cualificación con Claude): Contrastar el perfil de la empresa con la matriz de cliente ideal (ICP) y asignar una puntuación de 1 a 5.
- Estrategia 2: Generar un borrador personalizado de primera respuesta.
- Subtarea 2.1 (Búsqueda de contexto): Extraer de la base de conocimiento los dos casos de éxito más relevantes en ese nicho concreto.
- Subtarea 2.2 (Generación de respuesta): Redactar el borrador del correo siguiendo una estructura rígida e insertando los puntos de dolor específicos del cliente.
- Subtarea 2.3 (Integración): Crear una tarea en el CRM para el gestor asignado con un botón: «Revisar y enviar en un clic».
Cada nodo hoja de este árbol es una operación aislada que puede probarse de forma independiente. Si la fase de enriquecimiento falla porque un registro externo está caído, el sistema no se desploma entero: simplemente pasa la tarea adelante marcada para revisión manual.
Construcción de pipelines con Claude: de bots monolíticos a rutinas atómicas
Ahora veamos las tripas técnicas. En producción en 2027, los modelos de la familia Claude (en particular Claude 3.5 Sonnet y los modelos superiores de razonamiento) se han convertido en el estándar de facto. El motivo es sencillo: esta gama ofrece la mayor precisión siguiendo instrucciones de sistema complejas y trabaja sin fisuras en modo de salida estructurada (Structured Outputs / JSON Schema).
La arquitectura de un pipeline robusto no se apoya en un diálogo monolítico, sino en una cadena de rutinas atómicas (micro-prompts). Cada paso recibe un JSON limpio y devuelve un JSON estrictamente validado:
- Paso 1: Normalización y extracción de entidades. El modelo recibe texto en bruto (transcripción de llamada, cuerpo de correo o log de chat) y lo limpia de ruido, vacilaciones y muletillas. A la salida entrega un objeto compacto: nombres de contacto, presupuesto esperado, plazos del proyecto y stack tecnológico mencionado.
- Paso 2: Validación semántica contra la base de reglas. Los datos extraídos se cruzan con la base de conocimiento corporativa mediante el protocolo Model Context Protocol (MCP). ¿Está el servicio solicitado en la tarifa? ¿Chocan las condiciones del cliente con el contrato estándar de licencia? Si hay discrepancia, se activa una bandera de riesgo.
- Paso 3: Síntesis de la decisión con Structured Outputs. El modelo genera el artefacto final ciñéndose estrictamente a un esquema JSON. Cero improvisación libre: las claves del objeto están fuertemente tipadas, lo que elimina errores de sintaxis al pasarlo al backend.
- Paso 4: Entrega en la herramienta de destino. El objeto resultante se envía por webhook al CRM (amoCRM, HubSpot, Bitrix24), se publica en un canal privado de mensajería o dispara la generación de un PDF a partir de una plantilla.
El pipeline se despliega como un worker en segundo plano (background routine) que reacciona a eventos o se ejecuta por horario mediante cron. Los usuarios de la empresa ni siquiera saben qué modelo corre por debajo: solo ven que las fichas rutinarias del CRM se rellenan solas en cuestión de segundos.
Evals continuos y golden dataset: cómo sostener la calidad en producción
La gran trampa de cualquier proyecto de IA es la «euforia de la demo». Montas una cadena de prompts, la pruebas con cinco ejemplos en la interfaz y todo va como la seda. Entregas el proyecto, conectan el sistema a un flujo real de mil solicitudes diarias y, a la semana siguiente, todo cruje por las costuras: el modelo tropieza con redacciones atípicas, comete fallos absurdos y distorsiona datos.
En consultoría profesional, lanzar el pipeline es solo la mitad del camino. El grueso del trabajo consiste en montar pruebas de evaluación automáticas (evals). En nuestro repaso al estudio de Parlance Labs sobre el alcance de los evals automáticos analizamos al detalle dónde supera la evaluación automática al etiquetado manual y dónde conviene ir con pies de plomo. En el método de Saraev, el proceso sigue una disciplina militar:
- Creación del «golden dataset»: Al arrancar se recopila una colección de 50–100 casos reales de la empresa con respuestas humanas de referencia, además de ejemplos históricos de errores críticos cometidos por empleados.
- Pruebas de regresión antes de cada cambio: Basta con que toques una sola frase del prompt de sistema o cambies la versión del modelo para que todo el golden dataset vuelva a pasar por el pipeline. Plataformas de monitorización (Langfuse, Braintrust, Promptfoo) calculan automáticamente las métricas: porcentaje de JSON válido, cercanía semántica al estándar de referencia y tasa de alucinaciones.
- Sincronización semanal con el equipo (Weekly Sync): Una vez a la semana, el consultor mantiene una llamada breve de treinta minutos los viernes con las personas que trabajan con las salidas del pipeline. Se revisan los casos límite (edge cases): dónde falló el sistema, qué nuevo dato faltaba en la base de conocimiento y qué reglas hay que ajustar.
Este ciclo convierte la implantación de IA en un proceso de ingeniería controlable. El cliente ve la evolución de las métricas de calidad en un gráfico y entiende exactamente qué está pagando con su retainer mensual.
Tres trampas habituales de implantación y reglas de seguridad digital
Para cerrar, repasemos los tropiezos en los que caen con pasmosa insistencia quienes empiezan. He reunido los tres riesgos principales capaces de enterrar incluso un proyecto técnicamente impecable:
- Automatizar un proceso roto. Si las reglas de colaboración entre departamentos son confusas de origen, los equipos se pasan la pelota y la documentación es un caos, meter una red neuronal solo acelerará la producción de caos. Primero hay que desenredar y estandarizar el proceso a mano, y solo después automatizarlo.
- La ilusión del piloto automático total (sin Human-in-the-Loop). Todo proceso de negocio cumple la regla de Pareto: el 80% de las tareas son estándar y el modelo las resuelve sin problemas, pero el 20% restante son excepciones atípicas. Intentar sacar por completo al humano de los puntos críticos (finanzas, compromisos legales, clientes conflictivos) acaba en desastre. Incluye siempre una puerta de aprobación (Approval Gate) para que las decisiones dudosas pasen a revisión de un operador.
- Descuido con los datos privados. Conectar redes neuronales a bases corporativas exige una higiene digital estricta. Los datos personales de los clientes (documentos de identidad, números de tarjeta, teléfonos) deben enmascararse antes de enviarse al modelo. Además, solo deben utilizarse APIs corporativas con garantía de retención cero de datos (Zero Data Retention), evitando que la información acabe en los conjuntos de entrenamiento del proveedor.
La consultoría aplicada de IA en 2027 ha madurado definitivamente. Ya no hay sitio para la magia ni para conjuros chamánicos con prompts. Ganan quienes saben escuchar al negocio, detectar los cuellos de botella, descomponer objetivos complejos en pasos elementales y garantizar una calidad estable mediante pruebas de ingeniería rigurosas.