En el desarrollo corporativo con IA llevaba tiempo gestándose una crisis de ineficiencia operativa. Los arquitectos de sistemas se enfrentaban a diario al mismo dilema incómodo: si envías todas las peticiones entrantes a los modelos más potentes y pesados (como Claude 3.5 Sonnet o GPT-6), el presupuesto de tokens se evapora a ojos vistas y los usuarios se quejan de la lentitud en tareas simples. Si, por el contrario, pasas todo el pipeline a modelos ultraligeros y rápidos (como Gemini Flash), el sistema empieza a tropezar y alucinar cuando toca resolver matemáticas complejas, auditar seguridad o analizar arquitectura de código.
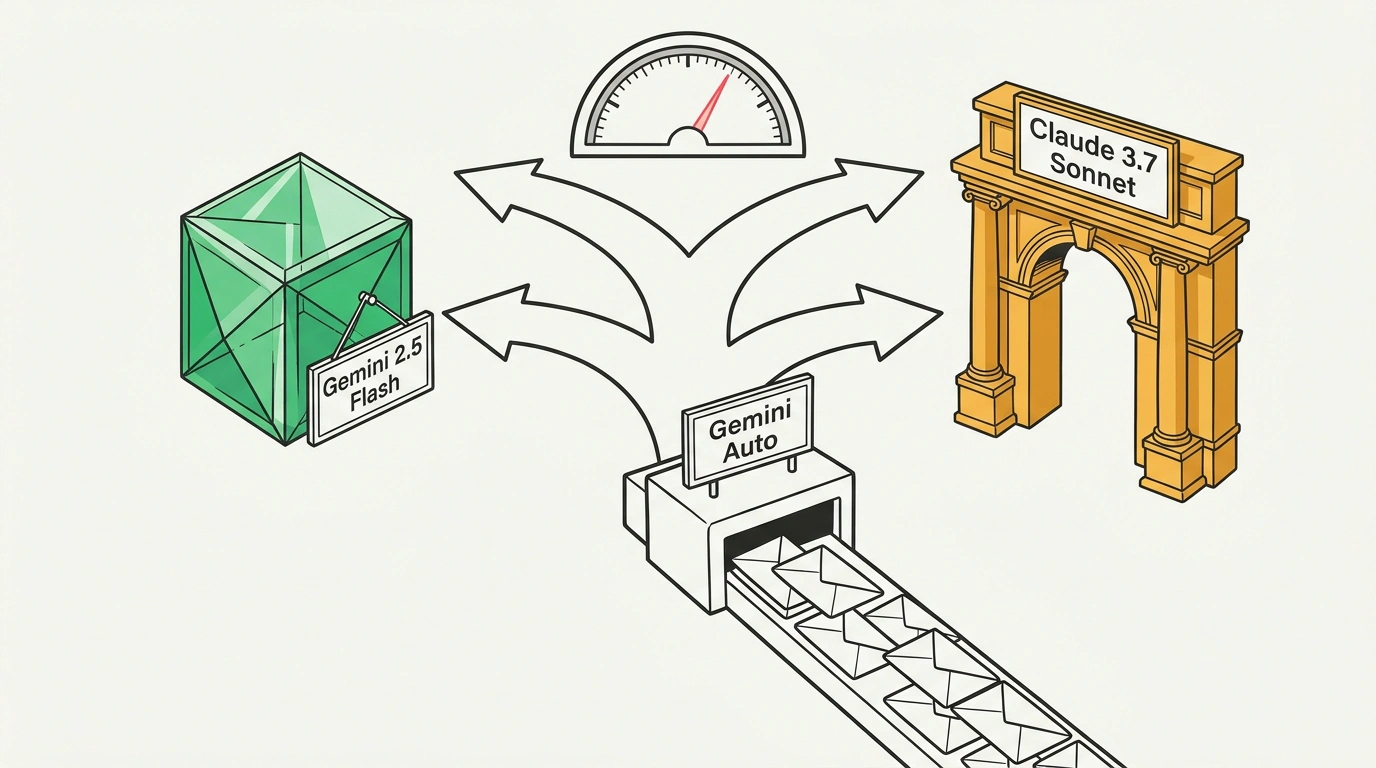
En la conferencia Gemini at Work, Google Cloud presentó una respuesta pragmática y esperada: la pasarela inteligente serverless API Gateway Model Routing con su modo corporativo Auto Mode. La gran noticia del anuncio es que Google renuncia a empujar en exclusiva sus propias redes: el enrutador reparte dinámicamente las peticiones no solo entre distintos niveles de Gemini, sino también hacia modelos insignia competidores como Anthropic Claude, disponibles dentro de Vertex AI Model Garden.
He revisado la arquitectura de la pasarela, he analizado la especificación del manifiesto OpenAPI y he probado el reparto automático de tráfico sobre casos reales. Veamos cómo funciona este conmutador inteligente y cómo configurar el balanceo dinámico de modelos en tu infraestructura.
Cómo funciona el clasificador de complejidad en servidor
En lugar de obligar a los desarrolladores a escribir reglas manuales enrevesadas o entrenar clasificadores locales, Auto Mode traslada la lógica de enrutamiento directamente al proxy serverless gestionado de Google Cloud.
Cada petición entrante es evaluada en fracciones de milisegundo por un modelo árbitro ligero y especializado según varios criterios:
- Evaluación de complejidad semántica: Las tareas sencillas (análisis de sentimiento, extracción de entidades, traducción o formateo de tablas) salen disparadas al instante hacia el veloz Gemini 4 Flash.
- Longitud del contexto y multimodalidad: Las peticiones que arrastran vídeos largos, cientos de páginas en PDF o volcados enormes de logs por encima de 128,000 tokens se dirigen al buque insignia de contexto largo Gemini 4 Carbon, con su ventana de hasta 2 millones de tokens.
- Refactorización compleja y análisis arquitectónico: Si en la consulta aparecen dependencias entre múltiples archivos, exigencia de razonamiento profundo o diseño lógico complejo, la pasarela desvía la sesión sin fricciones hacia Anthropic Claude 3.5 Sonnet.
Para la aplicación cliente, la pasarela se comporta como un endpoint unificado estándar, totalmente compatible con la especificación OpenAI Chat Completions. No hace falta tocar el código fuente de las apps: basta con definir un manifiesto declarativo.
Especificación declarativa de rutas y código de invocación
Las reglas de balanceo se describen mediante el estándar OpenAPI 3.x con la extensión corporativa x-google-api-management:
openapi: 3.0.0
info:
  title: Enterprise AI Model Router
  version: 1.0.0
paths:
  /v1/chat/completions:
    post:
      summary: Unified Auto Routing Endpoint
      x-google-backend:
        address: https://vertexai-router.googleapis.com/v1/auto
      x-google-api-management:
        routing_strategy:
          default_model: "gemini-4-flash"
          rules:
            - match:
                intent: "code_refactor_or_complex_reasoning"
                min_complexity_score: 0.75
              target_model: "anthropic.claude-3-5-sonnet"
            - match:
                context_length_tokens_gt: 128000
              target_model: "gemini-4-carbon"
Y desde la aplicación cliente en Python, llamar a la pasarela unificada resulta limpio y directo:
import os
from openai import OpenAI

# Conexión a la pasarela de Google Cloud Vertex AI mediante interfaz compatible con OpenAI
client = OpenAI(
    base_url="https://gateway.endpoints.my-enterprise-project.cloud.goog/v1",
    api_key=os.environ["VERTEX_ROUTER_API_KEY"]
)

# Petición indicando el modelo "auto": la pasarela elige entre Flash, Carbon y Claude
response = client.chat.completions.create(
    model="auto",
    messages=[
        {"role": "system", "content": "Eres un asistente corporativo de ingeniería."},
        {"role": "user", "content": "Analiza este pull request, detecta posibles condiciones de carrera en las goroutines y propón un parche arquitectónico."}
    ],
    temperature=0.2
)

# Los metadatos de respuesta incluyen el nombre del modelo realmente invocado
actual_model = response.model
print(f"[Enrutador activado] Tarea ejecutada por el modelo: {actual_model}")
print(response.choices[0].message.content)
En las cabeceras de respuesta, la pasarela devuelve el identificador exacto del modelo que atendió la petición junto con la puntuación de complejidad calculada por el clasificador. Eso permite llevar analítica completa y ajustar con precisión los umbrales de salto.
Economía y seguridad corporativa
Activar Auto Mode tiene un impacto financiero enorme. En entornos empresariales típicos, entre el 70% y el 85% de las peticiones de usuarios y agentes son relativamente simples y quedan resueltas sin problemas con el económico Gemini 4 Flash. Sacar ese tráfico de las redes pesadas recorta el gasto total en APIs entre un 60% y un 75%.
Además, integrar los modelos de Claude dentro de la infraestructura de Google Cloud resuelve las principales trabas de los equipos legales y de ciberseguridad:
- Todas las peticiones se ejecutan dentro de la nube virtual privada de la empresa (VPC Service Controls).
- Aplican políticas estrictas de permisos con Cloud IAM.
- Los datos corporativos de los clientes no se utilizan en ningún caso para reentrenar modelos de proveedores externos.
- Todas las transacciones quedan registradas en Cloud Audit Logs con IP e identidad del usuario.
El modo Auto en Google Gemini confirma el arranque de la era multimodelo pragmática: el futuro no pertenece a monopolios cerrados, sino a pasarelas inteligentes capaces de combinar lo mejor de cada familia de algoritmos.