Imagina un turno de guardia nocturno de libro: de repente, la monitorización dispara las alertas, un microservicio en Go dentro de tu clúster de Kubernetes entra en un bucle infinito de reinicios (CrashLoopBackOff) y, al ejecutar kubectl describe pod, te encuentras con esa línea tan escueta como implacable: OOMKilled con código de salida 137. Abres Grafana a toda prisa, miras la gráfica de uso del heap de la aplicación (go_memstats_heap_alloc_bytes) y todo parece una balsa de aceite. La memoria de la app no llegaba ni a la mitad del límite configurado, no se ve ningún pico extraño, pero el kernel del sistema operativo ha ejecutado el proceso sin piedad.
Si alguna vez te has topado con algo así en producción, bienvenido al club. Yo mismo he pasado unas cuantas horas analizando volcados de memoria e intentando cuadrar las cuentas entre las métricas del runtime de Go y el comportamiento real de los grupos de control del kernel de Linux. A primera vista parece cosa de brujería o un fallo de virtualización, pero bajo el capó lo que hay es un choque arquitectónico de lo más lógico entre dos mundos completamente distintos. Por un lado está el runtime de Go, diseñado históricamente bajo la premisa de tener un servidor físico entero para él solo. Por el otro, el entorno de contenedores de Kubernetes, donde el aislamiento se apoya en los subsistemas cgroups del kernel de Linux y las cuotas del planificador CFS.
Vamos a desarmar este mecanismo pieza a pieza: veremos por qué los contenedores acaban en la lona, cómo funcionan requests y limits, qué peligro esconde el throttling de CPU y cómo la combinación de GOMEMLIMIT junto al soporte nativo de contenedores en Go 1.25 permite levantar un servicio realmente sólido.
El misterio de la caída repentina: por qué el tamaño del heap no equivale al consumo del pod
La primera trampa mental en la que caemos al migrar servicios a Kubernetes es poner un signo de igual entre la memoria activa del proceso y el tamaño del heap asignado (Go heap). El razonamiento suena muy lógico: «Mi aplicación maneja estructuras de unos 200 megabytes en memoria, el límite del manifiesto del pod está en 512 megabytes, así que vamos sobrados con el doble de margen». Por desgracia, el kernel de Linux lo ve de una forma muy distinta.
Para el sistema operativo, tu servicio en Go es un proceso más cuyo consumo total de RAM se mide mediante el Working Set Size (WSS) o el Resident Set Size (RSS). Y el heap de Go es solo una parte de todo ese pastel. Además de los objetos alojados en el heap, en la memoria residente del proceso entran:
- Las pilas (stacks) de las goroutines. Cada goroutine nueva arranca con una pila compacta de 2 KB, pero si hay llamadas profundas o recursión activa, crece de forma dinámica. Si tu servicio mantiene decenas de miles de conexiones abiertas a la vez, solo las pilas pueden comerse cientos de megabytes.
- El espacio del propio binario y las librerías dinámicas cargadas.
- Estructuras internas y metadatos del runtime de Go (mapas de asignación de bloques del allocator, estructuras del planificador, cachés
mcacheymcentral). - Memoria reservada fuera de la jurisdicción de Go: búferes de red de los sockets del sistema, búferes de entrada/salida de disco y cualquier reserva hecha a través de librerías en C (
cgo) o la llamada al sistemammap. - Fragmentación de memoria. El allocator de Go no devuelve al sistema operativo las páginas liberadas al instante, sino mediante la llamada
madvisecon el flagMADV_DONTNEEDoMADV_FREE. Para el sistema operativo, esas páginas pueden seguir contando como asignadas al proceso hasta que el nodo sufra una presión real de memoria.
En una guía detallada de LearnKube se ilustra con total claridad: si el recolector de basura de Go espera a que el heap se duplique de 150 a 300 MiB, y la sobrecarga del sistema junto con los búferes ocupan otros 250 MiB, el Resident Set Size total se dispara hasta los 550 MiB. En cuanto el contador de páginas del cgroup rebasa el límite de 512 MiB, el kernel de Linux envía al instante la señal SIGKILL. La aplicación ni siquiera tiene tiempo de lanzar un panic, escribir en el log o ejecutar las funciones defer registradas: el proceso simplemente se esfuma de la memoria.
Requests frente a limits: cómo reparten el hardware físico el planificador y los cgroups
Para proteger el servicio hace falta distinguir con claridad dos conceptos de la especificación de Kubernetes: resources.requests y resources.limits. En el manifiesto del pod suelen aparecer pegados, pero detrás de cada uno operan subsistemas completamente diferentes del clúster y del kernel.
El parámetro requests (peticiones) va dirigido exclusivamente al planificador kube-scheduler. Cuando se crea un pod en el clúster, el planificador busca un nodo de trabajo (worker node) donde la suma de peticiones libres permita alojar la nueva carga. El request es la garantía de que en ese nodo quedan reservados físicamente esos megabytes de memoria y esos milicores de CPU. Si el nodo está saturado, el pod jamás caerá en él.
El parámetro limits (límites), en cambio, lo traduce el agente kubelet directamente a la configuración del kernel de Linux mediante el subsistema cgroups. El límite marca el techo absoluto: cuántos recursos tiene permitido consumir el proceso en un instante dado. Y aquí es donde aparece la diferencia fundamental entre cómo trata el kernel los recursos comprimibles (compressible) y los no comprimibles (incompressible).
El procesador (CPU) es un recurso comprimible. Si tu aplicación intenta consumir más ciclos de CPU de los que marca su límite, el kernel no mata el proceso. Simplemente pausa su ejecución de forma forzosa y pospone el cálculo a los siguientes cuantos de tiempo. El servicio irá más lento y la latencia de respuesta subirá, pero el proceso sigue vivo.
La memoria RAM (Memory) es un recurso por naturaleza no comprimible. No puedes «ralentizar» una lectura de memoria ni pedirle a un proceso que olvide temporalmente unos bytes que ya ocupan páginas físicas de RAM. Si la aplicación pide un bloque nuevo y el límite del grupo de control ya está al tope, al sistema operativo solo le quedan dos salidas: rascar memoria de emergencia de la caché de disco o liquidar al infractor al instante.
En nuestro artículo anterior sobre cómo gestionar la sobreasignación de recursos en Kubernetes para equilibrar la utilización de los nodos, ya tocamos el tema de las clases QoS. Si un pod tiene los valores de requests y limits iguales, recibe la prioridad máxima Guaranteed. Si requests es menor que limits, pasa a la clase Burstable. Y precisamente los servicios Burstable suelen ser los primeros candidatos al pelotón de fusilamiento cuando falta memoria física en el servidor.
Mecánica de OOMKilled en Linux: qué ocurre en el kernel antes del disparo SIGKILL
Echemos un vistazo bajo el capó del kernel de Linux para seguir paso a paso lo que sucede justo cuando se agota el límite de memoria del contenedor.
En las distribuciones modernas de Linux, la gestión de recursos de los contenedores se hace a través de la jerarquía unificada cgroups v2 (a diferencia de la antigua cgroups v1, donde memoria, CPU y E/S vivían en directorios separados). Dentro de cgroups v2, el límite de memoria se fija en el pseudofichero memory.max:
memory.maxestablece el techo rígido absoluto de memoria.- El fichero adicional
memory.highmarca un umbral blando: al alcanzarlo, el kernel empieza a frenar artificialmente las asignaciones del proceso y fuerza la limpieza de caché, pero mantiene vivo el proceso.
Cuando la aplicación en Go pide una nueva página de memoria al kernel mediante mmap o brk, el subsistema de paginación comprueba el contador de uso actual del cgroup. Si añadir esa página rompe el techo de memory.max, el kernel no invoca al OOM Killer en ese mismo microsegundo. Primero intenta desesperadamente liberar páginas a nivel local (page reclaim): vuelca a disco páginas sucias de ficheros, limpia la caché de lectura de disco y descarta páginas de librerías sin uso.
Si tras ese vaciado agresivo de cachés sigue sin haber hueco dentro del límite, el kernel activa el mecanismo mem_cgroup_out_of_memory. Un algoritmo específico calcula la puntuación oom_score para todos los procesos de ese grupo de control. Como en el contenedor de un microservicio normalmente corre un único binario principal en Go, es él quien se lleva la máxima penalización.
El kernel emite la llamada para enviar la señal inevitable SIGKILL (señal número 9). En el búfer circular de mensajes del kernel (dmesg) queda grabada una línea inconfundible:
Memory cgroup out of memory: Killed process 142091 (my-go-service) total-vm:845120kB, anon-rss:514100kB, file-rss:1240kB, shmem-rss:0kB, UID:1000 pgtables:1248kB oom_score_adj:998
Kubernetes detecta el fin del contenedor y registra el estado: código de salida 137 (calculado como 128 + 9). El proceso deja de existir en fracciones de microsegundo.
El parámetro GOMEMLIMIT controla únicamente la memoria gestionada por el allocator interno del runtime de Go. No puede hacer nada frente a fugas de memoria en código C/C++ mediante cgo, asignaciones directas con mmap al margen del runtime o un crecimiento desbocado de los búferes de red del kernel del sistema operativo.
La barrera GOMEMLIMIT: cómo configurar el fusible contra la degradación del GC
¿Y por qué el recolector de basura de Go no puso orden en la memoria antes de que llegara el OOM Killer? La respuesta está en cómo funciona el GC clásico de Go.
Diagrama arquitectónico despiezado del runtime de Go con el regulador GC pacer, el búfer seguro de memoria GOMEMLIMIT y el límite de cgroup del contenedor.
Históricamente, el recolector de basura de Go se apoyaba en un único tornillo de ajuste: la variable de entorno GOGC (con valor 100 por defecto). El algoritmo tricolor de recolección calcula el siguiente umbral de ejecución con una fórmula muy simple:
TargetHeap = LiveHeap + (LiveHeap * GOGC / 100)
Si tras la última pasada quedan 100 MiB de datos vivos en el heap, con GOGC=100 el siguiente ciclo no arrancará hasta que el heap crezca a 200 MiB. Si el servicio está bajo mucha carga y genera muchos objetos temporales, el heap se duplica en un parpadeo. Y si intentas bajar GOGC (por ejemplo, poniendo GOGC=20), el recolector empieza a ejecutarse sin parar. El uso de CPU se dispara por las nubes, la aplicación se pasa la mayor parte de sus cuantos marcando objetos (el fenómeno conocido como GC thrashing) y el rendimiento del servicio se desploma.
Para romper este círculo vicioso, los ingenieros de Go introdujeron el concepto de límite blando de memoria: GOMEMLIMIT. Tienes todos los detalles en la guía oficial del GC.
La idea detrás de GOMEMLIMIT es muy elegante:
- Mientras el consumo de memoria esté lejos de la frontera fijada, el recolector trabaja a su ritmo tranquilo habitual según el coeficiente
GOGC, sin cargar la CPU con ciclos innecesarios. - Cuando el volumen total de memoria se acerca al límite de
GOMEMLIMIT, el regulador interno (GC pacer) adelanta de forma dinámica y gradual el umbral de disparo del recolector, obligándole a limpiar con más frecuencia para no superar la marca. - El runtime incluye además un fusible de seguridad: el recolector nunca puede consumir más del 50 % de la potencia de cálculo de los núcleos de CPU disponibles. Si el programa tiene una fuga de memoria real y ni siquiera un GC continuo logra bajar el heap por debajo de
GOMEMLIMIT, el runtime permite que la memoria rebase el límite, prefiriendo caer por OOM antes que quedar congelado para siempre.
El error clásico de quien empieza con esto es fijar GOMEMLIMIT exactamente igual que resources.limits.memory en el manifiesto de Kubernetes. ¡Eso no se debe hacer jamás! Si tu límite en Kubernetes es de 1 GiB y pones GOMEMLIMIT=1GiB, el proceso acabará muriendo tarde o temprano. Recuerda que fuera del control de GOMEMLIMIT siguen estando el binario, las pilas de goroutines, las estructuras del kernel y la fragmentación.
Para que el servicio trabaje con holgura, ajusta GOMEMLIMIT dejando un margen del 15-20 % respecto al límite rígido del contenedor. Si el límite del pod es de 1000 MiB, el valor óptimo de GOMEMLIMIT ronda los 800-850 MiB. En pods grandes de más de 4 GiB puedes reducir ese colchón de seguridad al 10-12 %.
Fíjate en este ejemplo práctico en código de cómo consultar o ajustar este límite dinámicamente mediante el paquete estándar runtime/debug:
package main

import (
    "fmt"
    "log"
    "os"
    "runtime"
    "runtime/debug"
)

func initMemoryLimits() {
    // Leemos el límite de memoria configurado actualmente
    currentLimit := debug.SetMemoryLimit(-1)
    fmt.Printf("Текущий GOMEMLIMIT: %d байт (%.2f МиБ)\n",
        currentLimit, float64(currentLimit)/(1024*1024))

    // Si hace falta, el límite se puede ajustar desde el propio código,
    // por ejemplo, si la app ha leído el límite del fichero de cgroup v2
    memLimitEnv := os.Getenv("AUTO_CONFIGURE_GOMEMLIMIT")
    if memLimitEnv == "true" {
        // Fijamos un límite blando de 850 MiB
        const targetLimit = 850 * 1024 * 1024
        previous := debug.SetMemoryLimit(targetLimit)
        log.Printf("GOMEMLIMIT обновлен: старый=%d, новый=%d\n", previous, targetLimit)
    }

    var m runtime.MemStats
    runtime.ReadMemStats(&m)
    fmt.Printf("Выделено в куче: %.2f МиБ, получено от ОС: %.2f МиБ\n",
        float64(m.Alloc)/(1024*1024), float64(m.Sys)/(1024*1024))
}
Con debug.SetMemoryLimit(-1) lees el umbral activo sin modificarlo, mientras que pasarle un valor en bytes desde una comprobación de entorno o del propio cgroup te permite reconfigurar el techo en caliente antes de inspeccionar las estadísticas reales de runtime.MemStats.
La trampa de las cuotas de CPU en CFS: por qué 16 goroutines queman la ventana en 12 milisegundos
Una vez resuelto el frente de la memoria, toca mirar la otra cara de la moneda: los límites de procesador. Aquí acecha una trampa igual de traicionera llamada CPU Throttling.
Cuando pones en el manifiesto del pod la directiva resources.limits.cpu: "2", ¿qué significa eso a nivel físico? La mayoría de desarrolladores intuyen que el planificador del sistema operativo reserva dos núcleos dedicados para el contenedor. En realidad, Linux funciona de otra manera muy distinta. El límite de CPU se traduce en una cuota del planificador Completely Fair Scheduler (CFS).
En cgroups v2, los parámetros de CFS se escriben en el fichero cpu.max, que contiene dos cifras en microsegundos: cuota (quota) y periodo (period). El periodo estándar de cuantización en el kernel de Linux es de 100 000 microsegundos (100 milisegundos). Cuando configuras un límite de cpu: 2, el kernel calcula la cuota así:
quota = 2 * 100 000 µs = 200 000 µs (200 ms)
Esto significa lo siguiente: entre todos los hilos del sistema de tu contenedor pueden ejecutar instrucciones durante exactamente 200 milisegundos dentro de cada ventana de 100 milisegundos.
Ahora imagina un servidor clásico de alta carga con 64 núcleos físicos donde corre tu contenedor limitado a cpu: 2. Hasta hace poco, el runtime de Go miraba al arrancar el número de núcleos del sistema operativo mediante runtime.NumCPU() y fijaba tan tranquilo su variable interna GOMAXPROCS en 64.
¿Qué pasaba a continuación? El runtime inicializaba 64 procesadores lógicos (P) y levantaba decenas de hilos del sistema operativo (M). Bajo carga, 16 o 32 hilos atendían peticiones HTTP entrantes en paralelo. Mira qué aritmética tan curiosa:
- 16 hilos paralelos trabajan al mismo tiempo en distintos núcleos físicos del servidor.
- Cada hilo solo trabaja 12.5 milisegundos.
- El consumo acumulado de tiempo de CPU es:
16 hilos * 12.5 ms = 200 milisegundos.
¡La cuota del contenedor para toda la ventana de 100 ms se ha quemado en apenas 12.5 milisegundos desde que empezó el periodo! ¿Qué hace el kernel de Linux durante los 87.5 milisegundos restantes? Congela a la fuerza (throttles) todos los hilos del contenedor. Ni una sola goroutine avanza, ni un solo paquete de red se procesa. Los clientes sufren picos brutales de latencia en los percentiles p99 y p99.9, mientras la monitorización marca un 80 % de throttling con una carga media de CPU irrisoria.
Evolución de GOMAXPROCS: cómo aprendió Go 1.25+ a convivir con contenedores de serie
Durante años, la solución estándar de facto contra el throttling de CPU en el ecosistema Go fue la librería externa go.uber.org/automaxprocs. Se importaba de forma anónima (import _ "go.uber.org/automaxprocs"), al arrancar leía las rutas de /sys/fs/cgroup/cpu y llamaba automáticamente a runtime.GOMAXPROCS() redondeando la cuota a un entero.
Sin embargo, depender de un paquete de terceros para algo tan elemental generaba bastante debate. Por fin, en las versiones Go 1.25 y 1.26 el equipo del runtime integró el conocimiento nativo de contenedores. Ya analizamos esta transición a fondo en el estudio sobre cómo Go 1.25 en contenedores protege los microservicios frente al throttling de CPU en Kubernetes.
Según la documentación oficial del runtime de Go, el comportamiento del planificador se controla mediante los flags containermaxprocs y updatemaxprocs:
- Al arrancar, el runtime lee automáticamente las cuotas CFS de
cgroups v1ocgroups v2. - El valor de
GOMAXPROCSse calcula con la fórmula:min(NumCPU, AffinityCPUs, ceil(Quota / Period)). - Un detalle importante de la implementación: los desarrolladores de Go fijaron un mínimo de
GOMAXPROCS=2si la máquina tiene más de un núcleo físico. La razón es que el runtime necesita al menos un hilo adicional para tareas del sistema: escaneo en segundo plano del recolector de basura, el poller de red y llamadas al sistema. - Si los recursos del pod cambian en caliente (in-place pod resize en versiones recientes de Kubernetes), el runtime es capaz de recoger las nuevas cuotas sin necesidad de reiniciar el contenedor.
Si tu microservicio tiene asignada una cuota fraccionaria inferior a un núcleo (por ejemplo, cpu: 500m), ese mínimo automático de GOMAXPROCS=2 puede hacer que dos hilos agoten los 50 ms de cuota en solo 25 ms. Por eso, en contenedores muy pequeños sigue siendo recomendable medir latencias y, si hace falta, fijar GOMAXPROCS=1 a mano.
Receta de producción: manifiesto, variables de entorno y monitorización
Juntemos todo lo visto en una receta práctica y probada. ¿Qué aspecto debe tener el manifiesto de un Deployment de Kubernetes en producción para un microservicio en Go si queremos olvidarnos para siempre de OOMKilled y del throttling?
Aquí tienes una especificación de referencia para el pod:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: billing-service
  namespace: production
spec:
  replicas: 3
  selector:
    matchLabels:
      app: billing-service
  template:
    metadata:
      labels:
        app: billing-service
    spec:
      containers:
      - name: server
        image: billing-service:v2.4.1
        resources:
          # Los requests garantizan la reserva del planificador en el nodo
          requests:
            cpu: "1000m"
            memory: "768Mi"
          # Los limits marcan los topes rígidos del cgroup en el kernel
          limits:
            cpu: "2000m"
            memory: "1024Mi"
        env:
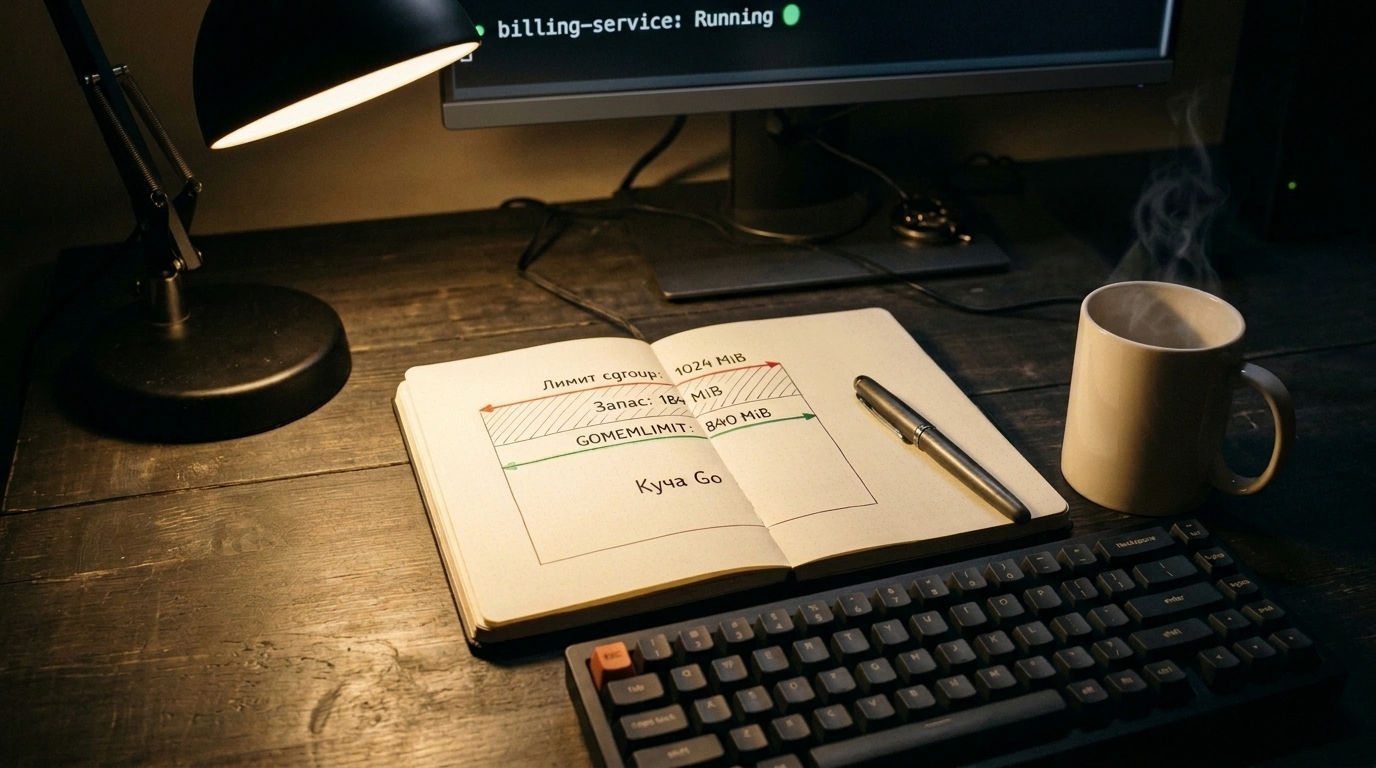
        # Fijamos GOMEMLIMIT con un margen del 15-20 % sobre limits.memory (1024Mi * 0.82 ≈ 840MiB)
        - name: GOMEMLIMIT
          value: "840MiB"
        # Mantenemos el GOGC=100 estándar para equilibrar la carga de CPU
        - name: GOGC
          value: "100"
        # Control del planificador nativo de Go 1.25+ mediante GODEBUG
        - name: GODEBUG
          value: "containermaxprocs=1,updatemaxprocs=1"
        ports:
        - containerPort: 8080
          name: http
        - containerPort: 9090
          name: metrics
Fíjate en las proporciones de este manifiesto:
- Pedimos al planificador 768 MiB de memoria y garantizamos 1 núcleo de CPU.
- Ponemos el límite rígido en 1024 MiB y 2 núcleos.
- Dejamos
GOMEMLIMITen840MiB, lo que reserva un colchón seguro de casi 184 MiB para las pilas de goroutines, estructuras del runtime, búferes de red y librerías dinámicas. - Los flags
containermaxprocs=1enGODEBUGaseguran que el runtime ajuste sus hilos al límite de 2 núcleos, evitando el throttling salvaje en servidores multinúcleo.
Además, conviene vigilar de cerca las métricas internas mediante el Prometheus Go Collector. go_memstats_heap_alloc_bytes te mostrará el tamaño real del heap, go_memstats_sys_bytes reflejará la memoria pedida al sistema operativo y el contador go_gc_pauses_seconds_total te avisará a tiempo si el recolector de basura empieza a acercarse al umbral crítico del 50 % de CPU.
En nuestro análisis a fondo sobre cómo la arquitectura del allocator de Go 1.27 ahorra memoria y acelera el runtime, vimos la siguiente etapa de esta evolución: los buckets especializados y la optimización de cachés de páginas permiten exprimir aún más rendimiento dentro de contenedores. Pero la base sigue siendo la misma: respetar los límites del kernel de Linux, entender la física de los contenedores y calcular bien los recursos.