Cuando una arquitectura de microservicios empieza a crecer de verdad, tarde o temprano te toca resolver cómo escalar el stack de observabilidad. El estándar clásico de la infraestructura cloud —la dupla de la base de series temporales Prometheus para métricas y el clúster de búsqueda OpenSearch para logs— empieza a crujir en cuanto choca con la realidad de un Kubernetes dinámico.
Los reinicios constantes de pods, las IP efímeras y la abundancia de etiquetas personalizadas disparan la cardinalidad (high cardinality). Prometheus empieza a ahogarse en la memoria de un solo nodo, mientras OpenSearch infla los volúmenes de disco con terabytes de índices invertidos.
En la serie de análisis técnicos de DevOps by REBRAIN plantearon un cara a cara muy pragmático entre los clásicos y dos alternativas ligeras: VictoriaMetrics y Grafana Loki. Veamos qué compromisos asume cada opción.
La batalla de las métricas: Prometheus frente a VictoriaMetrics
El gran talón de Aquiles del Prometheus clásico es su TSDB integrada. Se diseñó pensando en guardar datos en el disco local de un único servidor:
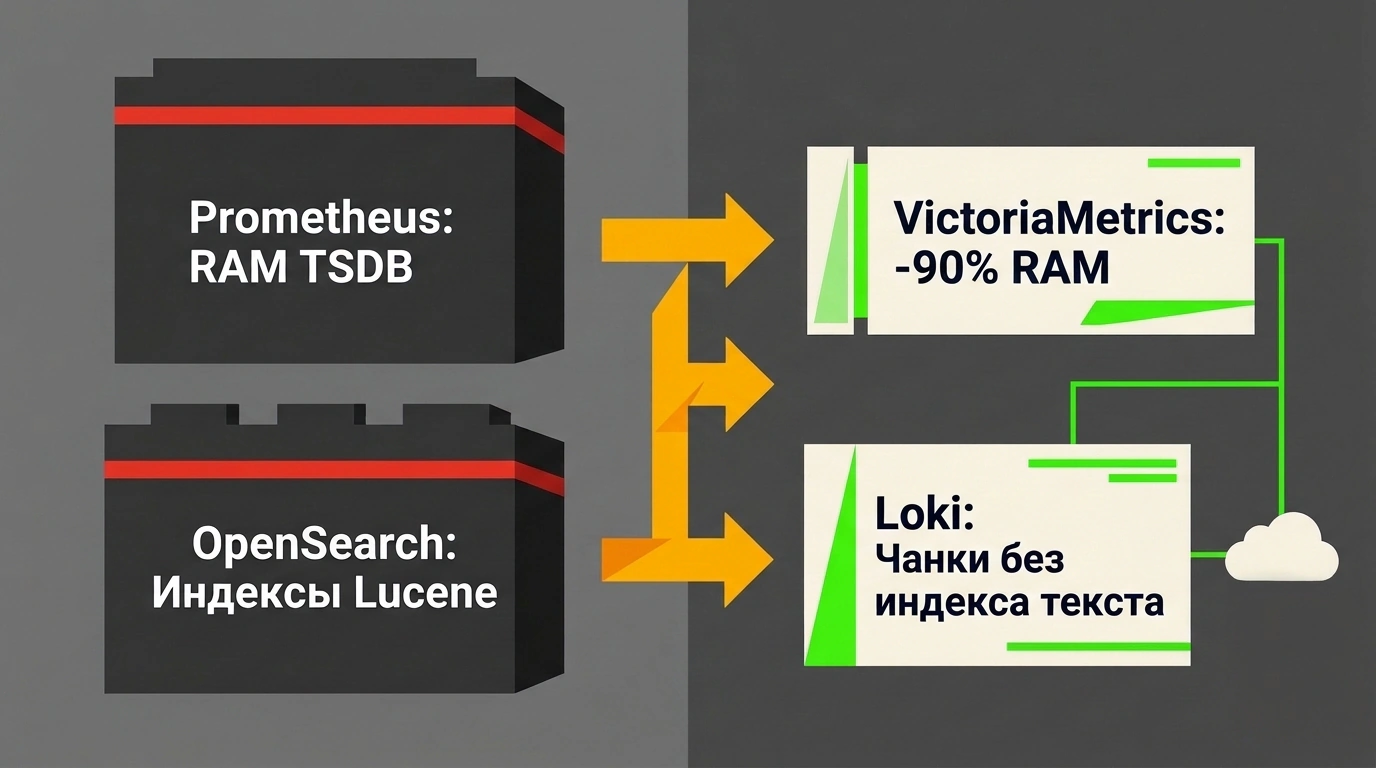
- Cuando el número de series activas sube a varios millones, Prometheus exige cientos de gigabytes de RAM solo para mantener los índices.
- Para unificar métricas de varios clústeres y guardar histórico de años, acabas montando capas complejas encima (Thanos, Cortex o Mimir).
VictoriaMetrics resuelve esto con mucha más soltura. Es 100 % compatible con PromQL y el formato remote_write, pero consume entre 10 y 15 veces menos RAM gracias a sus estructuras compactas de caché y comprime los datos en disco entre 7 y 10 veces mejor mediante su almacenamiento columnar por bloques (merge-tree).
Desviar el flujo de métricas desde un Prometheus existente hacia VictoriaMetrics se hace con un par de líneas en prometheus.yml:
# Envío de las métricas recopiladas al clúster de VictoriaMetrics
remote_write:
  - url: "http://victoriametrics:8428/api/v1/write"
    queue_config:
      max_samples_per_send: 10000
      capacity: 50000
      max_shards: 30
Con esta configuración, Prometheus sigue haciendo el scraping local habitual, pero reenvía lotes de hasta 10 000 muestras en paralelo hacia el endpoint de ingesta de VictoriaMetrics.
En nuestro análisis a fondo sobre la arquitectura interna de VictoriaLogs desde la ingesta hasta la compresión columnar, ya vimos las ventajas de prescindir de índices pesados. VictoriaMetrics y sus herramientas hermanas permiten alejar muchísimo el techo de escalado sin tocar tus dashboards habituales de Grafana.
La batalla de los logs: OpenSearch frente a Grafana Loki
Si en el terreno de las métricas la ventaja de la ligereza suele ser evidente, en el almacenamiento de logs la encrucijada arquitectónica es mucho más ajustada:
- OpenSearch construye índices invertidos completos de Apache Lucene para cada palabra de cada documento JSON. A cambio te da búsquedas instantáneas con expresiones regulares complejas y trazas sin estructurar. Pero el peaje es enorme: el consumo en disco multiplica por 3 o por 5 el volumen bruto de los logs y el clúster exige decenas de gigabytes de costosa memoria JVM Heap en cada nodo.
- Grafana Loki aplicó un giro radical: Loki directamente no indexa el texto de los logs. Solo indexa los metadatos (etiquetas como
app,namespace,pod), mientras que las líneas de log se empaquetan en chunks comprimidos y se mandan a almacenamiento de objetos barato (S3, MinIO o Ceph).
Las consultas dentro de Loki funcionan escaneando esos flujos mediante el lenguaje LogQL:
# Ejemplo de consulta LogQL: filtrado de logs de un servicio buscando panics
{namespace="production", app="billing"} |= "panic:" | json | status >= 500
Primero acotas el flujo por etiquetas (namespace y app), luego filtras por la subcadena "panic:", parseas el JSON y te quedas solo con los códigos de estado iguales o superiores a 500.
La factura de disco al pasar a Loki cae entre un 60 % y un 80 %, y hacer clic en un pico de errores en una gráfica de Grafana abre al instante los logs de ese mismo pod gracias a que comparten etiquetas.
La estrategia más equilibrada para equipos maduros consiste en dejar un Prometheus local como agente ligero de recolección que envíe por remote_write a VictoriaMetrics, y dividir los logs: manda eventos de sistema y aplicación al económico Loki, y reserva OpenSearch únicamente para auditoría de seguridad crítica y SIEM.
La elección se resume en una regla sencilla: si necesitas buscar al milisegundo erratas raras entre miles de millones de registros antiguos, paga por OpenSearch. En el resto de escenarios, el tándem VictoriaMetrics + Loki ofrece un ahorro descomunal de recursos.