Si sigues de cerca la industria del aprendizaje automático y la evolución de los grandes modelos de lenguaje (LLM), seguro que más de una vez has mirado con escepticismo los rankings clásicos y benchmarks sintéticos como MMLU, GSM8K o HumanEval. En cuanto sale un modelo nuevo, el marketing inunda las redes con gráficas triunfales presumiendo de décimas de punto por encima del líder de ayer. Pero en cuanto llevas esa novedad tan promocionada a un backend real en producción, parseas estructuras JSON anidadas complejas o lanzas agentes autónomos sobre un repositorio enorme, la carroza se vuelve calabaza al instante: el modelo alucina, rompe el formato de llamada a funciones y entra en bucles infinitos.
El problema de fondo era que los datos objetivos sobre el uso real de los modelos seguían bajo siete llaves dentro de los centros de datos de OpenAI, Google, Microsoft y Anthropic. Hasta ahora, todo lo que veíamos era la fachada retocada del marketing corporativo.
Pero esa barrera informativa acaba de saltar por los aires. La pasarela independiente OpenRouter, por la que pasan cada día miles de millones de peticiones de cientos de miles de ingenieros de todo el mundo, ha publicado junto al fondo Andreessen Horowitz (a16z) un estudio empírico monumental: «State of AI: An Empirical 100 Trillion Token Study with OpenRouter» (preprint disponible en arXiv).
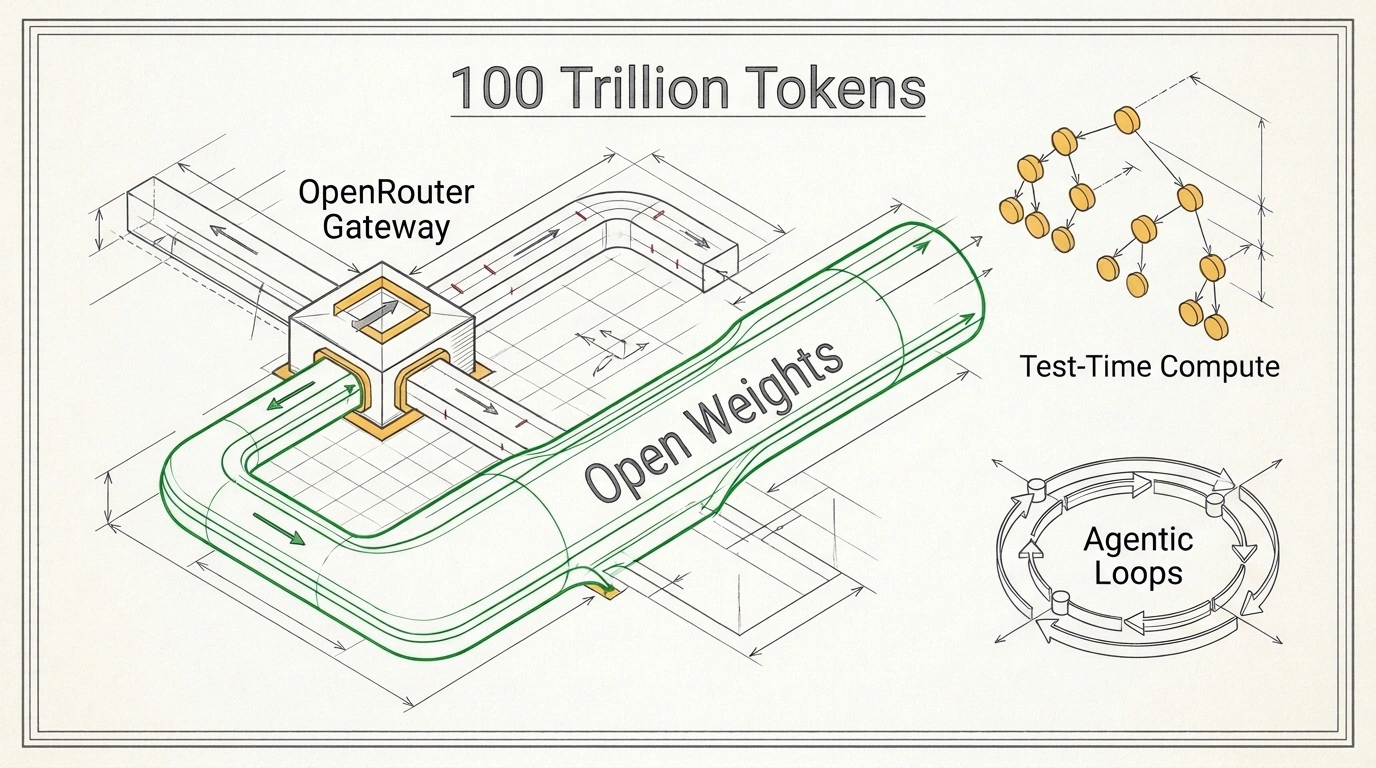
La base de este trabajo es un conjunto anonimizado de telemetría de una escala nunca vista: más de 100 billones de tokens reales de inferencia. Quitémosle el envoltorio brillante a la industria de la IA para mirar los hechos de ingeniería en frío: cómo ha cambiado de verdad el equilibrio de fuerzas entre pesos abiertos y cerrados, por qué se ha derrumbado el mito del foso infranqueable de los hiperescaladores y cómo los modelos de razonamiento han dado la vuelta a la arquitectura y a la economía del cómputo.
Más allá de los benchmarks sintéticos: la foto real de la web en producción
El mayor valor del estudio de a16z y OpenRouter está en la pureza y el carácter práctico de la muestra. Los tests sintéticos llevan tiempo sufriendo la contaminación de datos de evaluación (data contamination). Se entrena a los modelos expresamente para resolver problemas académicos concretos, ajustando los pesos a los exámenes populares como estudiantes haciendo trampas antes del examen. En producción la realidad es muy distinta: no hay condiciones ideales de laboratorio, sino logs sucios de usuarios, contexto incompleto y exigencias estrictas de latencia.
OpenRouter actúa como un mercado neutral de inferencia: no vende pesos propios, sino que ofrece una API unificada hacia cientos de modelos, desde los gigantes propietarios (OpenAI GPT-4o, Anthropic Claude 3.5 Sonnet, Google Gemini) hasta arquitecturas abiertas (DeepSeek, Meta Llama, Qwen, Mistral, Moonshot, MiniMax, Yi, GLM). Quienes generan ese tráfico no son usuarios ociosos pidiendo recetas de tarta de manzana, sino desarrolladores profesionales, startups y empresas de producto que integran modelos en sus servicios, agentes CLI, IDEs y pipelines automatizados.
Los investigadores analizaron la evolución de las peticiones durante el último año y medio. Al inicio de la muestra, el tráfico semanal de la plataforma era de unos modestos 1.8 billones de tokens, y para otoño de 2026 se disparó hasta unos asombrosos 36.8 billones de tokens semanales. Cada transacción se midió a través de decenas de parámetros de telemetría: proporción entre tokens de entrada y salida, latencia hasta el primer token (Time-To-First-Token), frecuencia de llamadas a herramientas externas, errores de validación y coste de servicio.
En nuestro análisis sobre la transformación de la infraestructura de desarrollo y consolidación de pasarelas LLM como OpenRouter, ya señalamos el peso creciente del enrutamiento inteligente. Ahora tenemos la confirmación empírica completa de ese giro tectónico.
El gran giro geográfico: el despegue de los modelos abiertos chinos
La conclusión más sonora del estudio desmonta la idea extendida de que Silicon Valley conserva un liderazgo absoluto e indiscutible en inteligencia artificial. Los datos de los 100 billones de tokens registran un vuelco geográfico histórico.
En la primavera de 2025, más de dos tercios de toda la generación en la plataforma pasaban por APIs estadounidenses cerradas. La cuota de los modelos abiertos parecía marginal, y las propuestas chinas se veían más bien como copias que iban a remolque. Sin embargo, en los doce meses siguientes se produjo un cambio descomunal: el volumen de inferencia de los modelos abiertos chinos (encabezados por la familia DeepSeek y la serie Qwen de Alibaba) no solo alcanzó a los servicios estadounidenses, sino que casi duplicó su tráfico. En otoño de 2026, los modelos chinos superaban de forma estable los 19.5 billones de tokens por semana frente a unos 14.0 billones de los gigantes estadounidenses.
Los autores refutan con especial contundencia la tesis del supuesto «ocaso de DeepSeek» que varias consultoras repitieron a finales de 2025. La llegada de DeepSeek-V3 y del modelo de razonamiento DeepSeek-R1 desencadenó una migración masiva de desarrolladores. Cuando la calidad en generación de código y cálculo matemático iguala a los mejores modelos comerciales, pero el millón de tokens cuesta $0.14–$0.28 frente a $2.50–$15.00 en la competencia cerrada, el pragmatismo de ingeniería gana a cualquier marca.
En el artículo sobre cómo Qwen 3.8 Max impulsó el giro hacia los modelos de lenguaje abiertos, ya detallamos las particularidades arquitectónicas de su atención y de su estructura Mixture-of-Experts (MoE). El informe de a16z confirma que las empresas eligen apertura y eficiencia económica.
De una respuesta directa al razonamiento oculto: la revolución del Test-Time Compute
El segundo cambio estructural documentado en el estudio afecta a la física interna de la inferencia. La industria ha entrado de lleno en la era de los modelos de razonamiento (Reasoning Models) y del paradigma de cómputo en tiempo de servicio (Test-Time Compute).
Corte arquitectónico Cutaway y esquema del árbol de cálculo Test-Time Compute de modelos de razonamiento con nodos ocultos de pensamiento.
En los modelos autorregresivos clásicos (GPT-4, Llama 3), la arquitectura operaba con una proporción rígida: el usuario enviaba el contexto y el modelo generaba la respuesta de una sola pasada, token a token. La relación entre prompt y respuesta (prompt-to-completion ratio) se movía de forma estable entre 3:1 y 5:1. Por cada cien tokens de entrada salían apenas 20-30 de salida.
Con los modelos de razonamiento, esa arquitectura se ha dado la vuelta por completo:
- El modelo ya no intenta acertar la respuesta correcta al instante desde el primer token;
- Lanza una fase de razonamiento interno oculto (thinking tokens / chain-of-thought), construyendo un árbol de hipótesis intermedias, verificando pasos y descartando ramas sin salida;
- El volumen de tokens internos invisibles ha pasado a superar entre 5 y 15 veces la respuesta final visible para el usuario.
La inferencia ha dejado de ser una simple interpolación de texto para convertirse en una búsqueda algorítmica real sobre un grafo de decisiones (tree search / Monte Carlo Tree Search). Para los ingenieros de infraestructura, esto multiplica la carga sobre las GPU durante una sola transacción de usuario. Si antes el cuello de botella era mover pesos desde memoria (memory bandwidth bound), ahora generar cientos de pasos de razonamiento vuelve a saturar los núcleos tensoriales al máximo.
Ciclos agénticos y autonomía: quién quema de verdad la capacidad de cómputo
¿Y quién es el principal consumidor de esos billones de tokens? El análisis de metadatos desmonta otro mito muy extendido: la idea de que las redes neuronales se usan sobre todo para redactar correos o resúmenes escolares.
La radiografía del uso real en producción dibuja tres grandes bloques dominantes:
- Generación, auditoría y refactorización de código (Coding Assistance). Es el motor indiscutible del consumo de cómputo. Los entornos de desarrollo y terminales agénticos actuales (Cursor, Windsurf, Claude Code, Aider) envían ventanas de contexto gigantescas (de 32k a 128k tokens), empaquetando ficheros enteros del proyecto, árboles sintácticos abstractos, logs de tests unitarios y salidas del compilador.
- Bucles agénticos de retroalimentación (Agentic Loops & Tool Calling). Cada vez se llama menos al LLM de forma aislada. Lo habitual ya es montar bucles autónomos: el modelo genera los argumentos de una llamada API, el entorno ejecuta el comando en un sandbox aislado, devuelve el resultado al modelo y este decide el siguiente paso. En una sola tarea de usuario puede completar entre 10 y 50 iteraciones, quemando decenas de miles de tokens en cuestión de segundos.
- Interacción de rol y narrativa interactiva (Roleplay & Interactive Narrative). El sorprendente segundo puesto en tráfico abierto no lo ocupan los chatbots corporativos, sino las plataformas de entretenimiento interactivo. Los modelos abiertos sin filtros corporativos pacatos ni censura rígida se han convertido en la base favorita para acompañantes virtuales y personajes de videojuegos.
El efecto Cenicienta y la paradoja de Jevons: inercia en producción frente a inferencia barata
Uno de los apartados más fascinantes del estudio aborda el análisis por cohortes de los equipos de ingeniería (Developer Cohort Retention). Los investigadores identificaron un fenómeno al que bautizaron como «efecto Cenicienta» (Cinderella Effect).
Funciona así: cuando sale un modelo rompedor, se forma a su alrededor una cohorte de desarrolladores que ajustan desde cero sus prompts, esquemas de validación JSON e instrucciones de sistema para él. Pasan los meses, la competencia lanza alternativas más rápidas, baratas e inteligentes, pero esa cohorte sigue mandando millones de peticiones a «su» modelo antiguo.
La causa de esa inercia es la fragilidad de los prompts (prompt brittleness). Cambiar el modelo base en un backend en producción es una pesadilla: varía la estructura de las respuestas, se mueven los casos límite y se rompe el parseo de argumentos de funciones. Por eso los equipos retrasan la migración hasta el último momento, hasta que aparece una solución que supera a la actual no por unos puntos porcentuales, sino por varios órdenes de magnitud. Ese punto de inflexión fue precisamente DeepSeek-V3, que rompió la inercia de cientos de miles de proyectos en cuestión de semanas.
Que el coste de inferencia caiga un orden de magnitud no reduce el gasto total de las empresas en IA. Al contrario: el abaratamiento brusco del cómputo desató un crecimiento multiplicado por cien en el consumo, porque los desarrolladores dejaron de recortar contexto, pasaron a enjambres multiagente y activaron auditorías continuas en segundo plano.
En teoría económica esto se conoce como la paradoja de Jevons: aumentar la eficiencia tecnológica en el uso de un recurso acaba disparando su consumo total en lugar de ahorrarlo. Cuando un token cuesta fracciones de céntimo, desaparece el incentivo para podar el system prompt: los ingenieros prefieren pasarle al modelo todo el historial de git y la documentación completa de la API.
Arquitectura del stack de ingeniería: enrutamiento, caché de prefijos y timeouts de nueva generación
Apoyándose en esta montaña de datos empíricos, los autores del informe proponen una serie de recomendaciones arquitectónicas estrictas para quienes diseñan servicios distribuidos sobre LLM.
Si estás construyendo un backend moderno con IA integrada, toca revisar varios patrones básicos de infraestructura:
- Enrutamiento dinámico multiproveedor. Atarse a la API directa de un único proveedor es comprar papeletas para sufrir caídas (downtime). La inferencia de modelos abiertos se sirve desde una red distribuida de centros de datos. Un buen gateway debe balancear automáticamente la carga entre varios proveedores independientes según latencia y disponibilidad de GPU.
- Caché de prefijos de contexto (Prompt Caching). Como los sistemas agénticos envían una y otra vez el mismo system prompt y una base de código estable, usar un hosting que conserve la caché KV (por ejemplo, vLLM con PagedAttention o SGLang) recorta el coste y la latencia de los tokens de entrada entre un 50 % y un 80 %.
- Revisión radical de los timeouts HTTP. Los timeouts clásicos de microservicios de 5 o 10 segundos tumbarán la conexión sin remedio al trabajar con modelos de razonamiento. La fase de pensamiento oculto puede tardar entre 30 y 60 segundos antes de que llegue el primer byte del stream (Time-To-First-Token). La arquitectura debe apoyarse en colas asíncronas (Webhooks, Server-Sent Events o streaming gRPC) en lugar de llamadas síncronas bloqueantes.
Estructura tus prompts de forma que la parte estática (instrucción de sistema, definición de herramientas, esquema fijo de BD) vaya siempre al principio de la petición, y los datos dinámicos del usuario al final. Así los motores de inferencia pueden reutilizar la caché KV compilada entre todas las sesiones paralelas.
Cambio de paradigma: por qué los pesos abiertos son ya la base de la ingeniería digital
El estudio de los 100 billones de tokens de OpenRouter cierra la primera etapa de la revolución de la IA generativa. La época del entusiasmo ingenuo ante los monopolios cerrados ha dado paso a un pragmatismo de ingeniería maduro.
El mito corporativo del «foso tecnológico inexpugnable» de los laboratorios propietarios ha quedado desmontado. Los pesos abiertos, la posibilidad de autohospedarlos (self-hosting) en tu propio perímetro seguro y la competencia de precios entre decenas de proveedores independientes han convertido la inferencia de calidad en una commodity.
Para desarrolladores y arquitectos esto supone una libertad sin precedentes: ya no estamos atados a los caprichos tarifarios, cambios de licencia o bloqueos repentinos de un único proveedor. El futuro de la ingeniería digital pertenece a los estándares abiertos, la arquitectura transparente y el control pragmático de nuestra propia capacidad de cómputo.