El mundo de la inteligencia artificial aplicada sufría desde hace tiempo una fragmentación absurda. Cada gran proveedor o framework abierto vivía en su propia isla aislada: los bots de una misma librería se entendían de maravilla entre sí, pero eran incapaces de intercambiar una sola palabra con agentes de otro ecosistema. Si tenías un agente analítico en LangGraph, un agente de QA en CrewAI y un worker local en consola, enseñarles a pasarse tareas en red de forma segura seguía siendo un quebradero de cabeza.
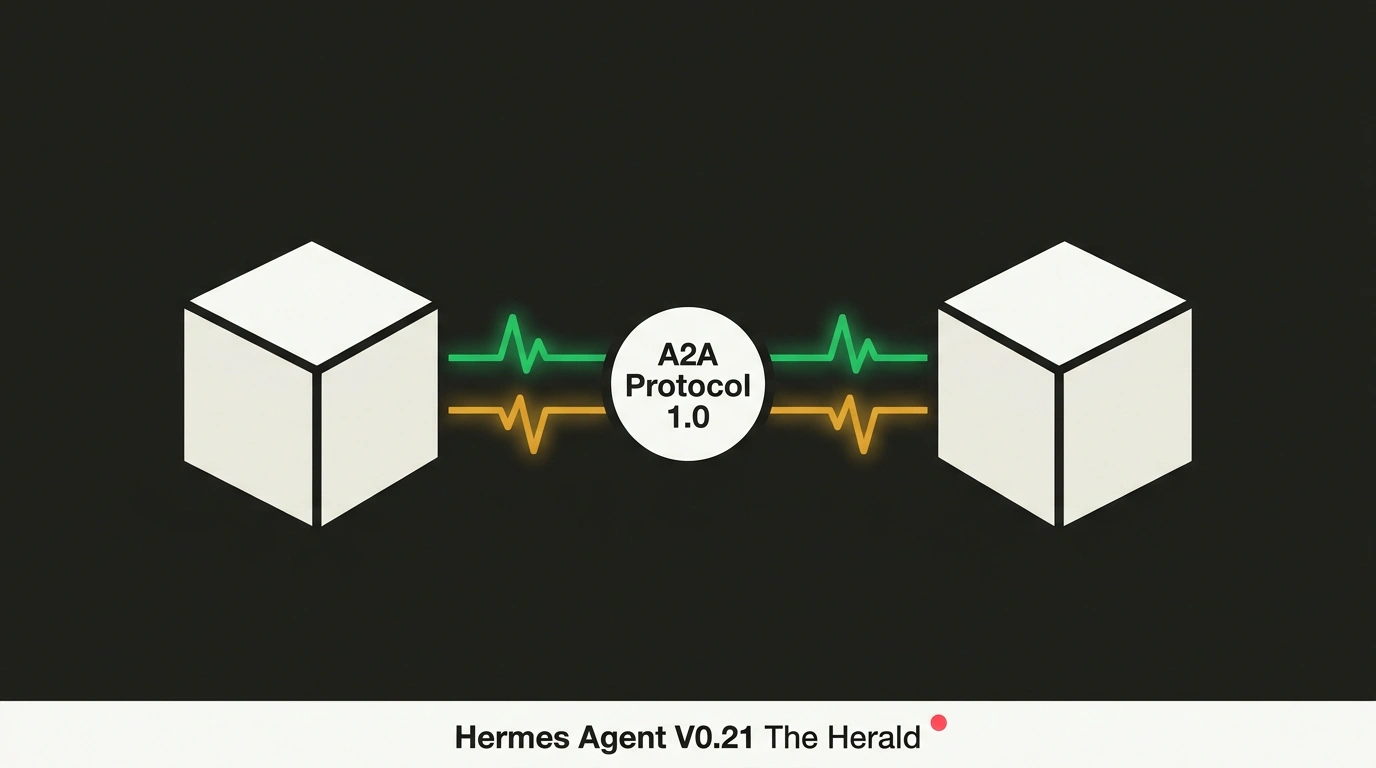
El laboratorio Nous Research ha dado un paso clave para derribar esos muros con el lanzamiento de Hermes Agent V0.21, bajo el nombre en clave «The Herald Release». La gran novedad de la versión es la especificación abierta e implementación del protocolo de comunicación entre agentes en red A2A (Agent-to-Agent Protocol v1.0), que convierte a cada agente en un servicio de red de pleno derecho.
Además, el lanzamiento incorpora un módulo local de inferencia de voz con latencia ultrabaja y un validador determinista de citas. He desplegado un nodo Hermes, he probado el protocolo A2A en red local y he comprobado la verificación de fuentes sobre casos reales. Veamos cómo funcionan estas novedades arquitectónicas.
Protocolo bidireccional A2A 1.0: el agente como cliente y servidor
El protocolo A2A v1.0 transforma cada instancia de agente en un nodo independiente de red que habla JSON-RPC sobre HTTP y WebSocket. Hermes Agent puede operar a la vez en dos modos:
- Modo servidor (Server Mode): Hermes abre un socket seguro de red, publica el manifiesto de sus capacidades en
GET /a2a/v1/capabilitiesy espera encargos entrantes enPOST /a2a/v1/tasks. Scripts externos, pipelines corporativos de CI/CD o bots remotos pueden delegarle tareas con autenticación criptográfica por tokens. - Modo cliente (Client Mode): El agente descubre otros nodos compatibles con A2A en la red local o mediante un registro corporativo de servicios. Para el modelo, el agente remoto se ve como una herramienta local más: le basta invocar
delegate_task(target="agent-lawyer", input={...}), sin preocuparse por el enrutamiento ni la serialización.
Durante el saludo inicial (handshake), los nodos intercambian firmas criptográficas y manifiestos de capacidades. Así se evita que una tarea de compilación acabe por error en un bot diseñado solo para formatear texto.
Configuración del socket de red e invocación cliente en Python
Configurar el servidor A2A en hermes.config.json resulta limpio y directo:
{
  "a2a_server": {
    "enabled": true,
    "listen_host": "0.0.0.0",
    "listen_port": 7443,
    "auth_token_hash": "sha256:d8e8fca2dc0f896f7e8a9b1c2d3e4f5a6b7c8d9e0f1a2b3c4d5e6f7a8b9c0d1e",
    "advertised_name": "Hermes-Security-Auditor",
    "capabilities": ["static_analysis", "test_generation", "vulnerability_scan"]
  }
}
Y del lado cliente, delegar una tarea a un agente remoto por A2A se implementa con este script asíncrono en Python:
import httpx
import json

async def delegate_to_remote_agent(remote_url: str, task_payload: dict, auth_token: str) -> dict:
    """Delega la ejecución de una tarea a un agente A2A remoto con verificación de citas."""
    headers = {
        "Authorization": f"Bearer {auth_token}",
        "Content-Type": "application/json"
    }
    payload = {
        "protocol": "a2a-v1.0",
        "task_id": "task_20261030_sec_01",
        "action": "execute_task",
        "input": task_payload,
        "require_citation_verification": True
    }

    async with httpx.AsyncClient(timeout=60.0) as client:
        response = await client.post(f"{remote_url}/a2a/v1/tasks", headers=headers, json=payload)
        response.raise_for_status()
        result = response.json()
        print(f"[Nodo A2A] Tarea aceptada por el agente remoto: {result.get('worker_node')}")
        return result
Inferencia de voz en tiempo real y caída de la latencia
La segunda gran aportación de V0.21 es el motor integrado de interacción vocal en local (Real-Time Voice Engine). Hasta ahora, hablar por voz con un agente exigía encadenar tres APIs en la nube: primero el audio viajaba a un servidor de transcripción Whisper, luego el texto pasaba al LLM y finalmente la respuesta iba a un sintetizador de voz. Ese triple salto acumulaba entre dos y cuatro segundos de espera, rompiendo la fluidez de la charla.
Hermes V0.21 monta un stack ligero de inferencia vocal directa apoyado en el motor optimizado llama.cpp. El modelo procesa el flujo de audio en bruto a través de una conexión WebSocket. En una estación estándar con una GPU de nivel RTX 4090, la latencia conversacional (Voice Latency) baja a 280–350 milisegundos. Hablas al micrófono y el agente responde al instante, sin esa pausa incómoda al otro lado de la línea.
Verificación determinista de citas (Citation Verification)
Uno de los fallos más traicioneros de los agentes en tareas analíticas son las alucinaciones de referencias. Un modelo puede redactar un informe impecable en estilo, pero atribuir una cita a un autor inexistente o señalar una línea de archivo donde hay un código completamente distinto.
En Hermes V0.21, Nous Research ha introducido un validador determinista estricto de cadenas llamado Citation Verification Harness:
- Cuando el agente incluye una cita o una referencia a fuente en su respuesta, el validador intercepta el mensaje saliente antes de mostrarlo al usuario.
- El sistema consulta automáticamente el documento original o archivo del repositorio, extrae el fragmento indicado y calcula la distancia de Levenshtein.
- Si la cita coincide con el original por encima del 95%, la respuesta queda verificada y recibe una insignia verde.
- Si está distorsionada o no existe en la fuente, el validador bloquea la salida y devuelve la tarea al agente con una advertencia del sistema: «Error de verificación de cita: fragmento no encontrado en el archivo. Vuelve a comprobar los datos».
Hermes Agent V0.21 sienta las bases del internet agéntico (Agentic Internet). El protocolo A2A 1.0 acaba con el aislamiento y permite que sistemas heterogéneos formen redes distribuidas capaces de resolver tareas complejas con precisión factual verificada.