16 ноября Alibaba выкатила флагманскую модель Qwen 4-Max, и в этом релизе сразу два парадокса бросаются в глаза. Сеть раздули до 2,4 триллиона параметров, но на деле она тратит примерно вдвое меньше токенов, чем вышедшая три месяца назад Qwen 3.8 Max. Второй сюрприз ещё интереснее: компания, приучившая рынок к мощным открытым весам для локального запуска, на этот раз полностью закрыла флагман за облачным API.
Как устроены 2,4 триллиона параметров и что не так с бенчмарками
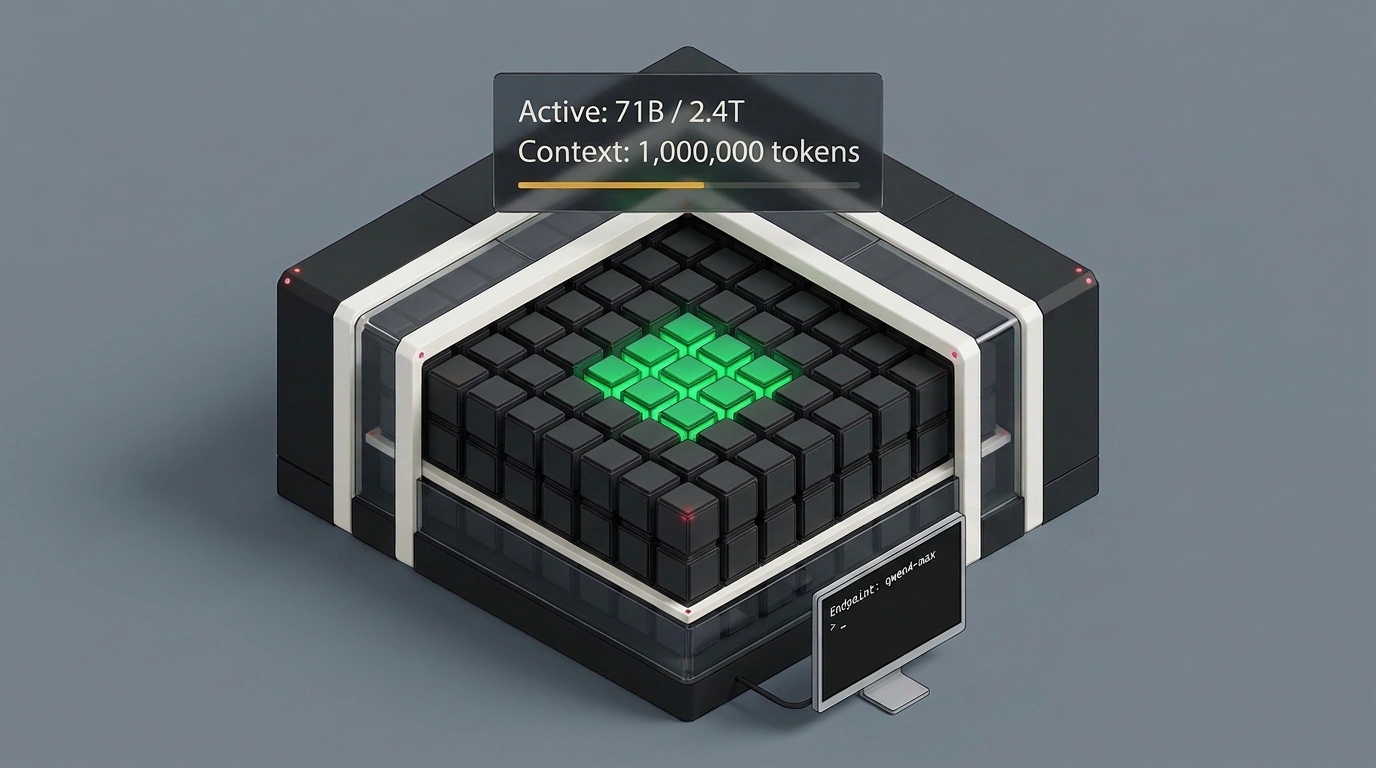
Заглянем в архитектуру, чтобы понять, откуда при таком весе взялась экономия. Под капотом работает разреженная архитектура Mixture of Experts. Механизм напоминает огромную клинику на две тысячи врачей: когда ты приходишь с больным коленом, на приём выходят два профильных специалиста, а не весь персонал разом. Точно так же на каждый токен здесь просыпается лишь 71 миллиард параметров из 2,4 триллиона, хотя у прошлого флагмана включались около 95 миллиардов. Ещё 328 миллиардов ушли в слои N-gram embeddings — это быстрая шпаргалка для частых синтаксических связок, чтобы сеть не тратила такты на рутинный код.
Контекстное окно растянули до миллиона токенов, а по спецификации модели — до 991 тысячи токенов на вход и 393 тысяч на вывод. На таком объёме обычные модели часто теряют детали в середине длинного файла. Чтобы внимание не проседало, инженеры Alibaba встроили слои Gated DeltaNet и разреженное внимание Qwen Sparse Attention. Зрение здесь нативное: модель напрямую читает скриншоты интерфейсов и видео, но отвечает строго текстом и сама картинки не рисует.
В релизных графиках цифры выглядят громко. В обзоре канала Julian Goldie SEO приводят кейс заводов SANF и Pacific Union: программирование станка для резки металлической детали сократилось с 475 минут до 24 минут. В тесте Work360 на длинные профессиональные задачи модель набрала 52,69 балла против 47,74 у Qwen 3.8 Max. На слепом фронтенд-тесте Code Arena она заняла шестое место в мире, на Design Arena стала четвёртой по презентациям и пятой по таблицам, а в Healthbench Professional выросла с 39,6 до 60,0 балла.
А теперь сравним обещания с реальностью. И заводской кейс, и замеры Work360 провела сама Alibaba, а независимых повторов этих тестов пока нет. Единичные замеры первых тестировщиков вроде ускорения задачи кодинга с 17 до 2,5 минуты или анимации с 19 до 12 минут тоже остаются лишь ориентиром. Вендорские бенчмарки часто строятся вокруг чистых задачек уровня LeetCode, тогда как в живых проектах со сторонними библиотеками модель всё ещё требует жёстких инструкций по типам.
Зато с прайсом в QwenCloud всё прозрачно. Миллион входных токенов стоит $1,50, миллион выходных обходится в $4,50, а кэшированный ввод падает до $0,075 за миллион. Для долгих рабочих сессий с одним репозиторием именно кэш даёт главную экономию.
Thinking Mode, пошаговая сдача и подводные камни
Посмотрим, что происходит внутри на сложной задаче. В Qwen 4-Max встроен режим рассуждений Thinking Mode с лимитом цепочки мыслей до 262 тысяч токенов. Перед выдачей кода или схемы нейросеть прокручивает гипотезы, проверяет граничные условия и отлавливает противоречия. Это сильно выручает в математических доказательствах, разборе контрактов и проектировании микросервисов.
Правда, с режимом по умолчанию легко промахнуться. У рассуждений три уровня глубины: low, medium и extra high, причём максимальный extra high включён по умолчанию. Как метко заметил Джулиан Голди, гонять максимальный режим на простых правках — всё равно что собирать консилиум архитекторов ради выбора шрифта кнопки. На мелких запросах модель уходит в многословие и сжигает время впустую.
Вторая заметная фишка — пошаговая сдача кода Staged Delivery, под которую Alibaba открыла исходный код плагина Live Delivery. Обычная нейросеть на большом задании надолго замолкает и вываливает в финале огромную простыню, где ошибку на втором шаге замечаешь на пятидесятом. Здесь модель отдаёт первый рабочий каркас по ходу дела, как строитель, показывающий раму дома до укладки крыши. За счёт нативного зрения она умеет сама проверить скриншот интерфейса или 3D-сцену и поправить вёрстку по твоим правкам на полпути.
На глубоких инженерных задачах остаются две шероховатости. При многофайловом рефакторинге TypeScript модель периодически теряет согласованность в именовании типов, если не закрепить их жёстко в промпте. А ещё на платформе работает строгая фильтрация по кибербезопасности: легитимный аудит сетевого кода или тесты на проникновение могут упереться в ложный отказ.
Подключаем Qwen 4-Max к Cursor и прогоняем рефакторинг монолита
От теории переходим к делу. Допустим, в репозитории висит старый монолит на Express.js и TypeScript на 50 000 строк кода. Мелкое окно контекста заставляет резать модули на куски и терять связи между файлами, а нам нужно отдать модели всю архитектуру целиком.
Подключить Qwen 4-Max можно к Cursor, Cline, Continue, Claude Code, Codex, OpenCode и QwenCode: API понимает форматы OpenAI и Anthropic, а модель также доступна в Qwen Studio, QwenWork, Coder, на OpenRouter и Vercel. И важная мелочь: ноябрьское превью от 11 ноября отключается 25 ноября, так что рабочие интеграции пора переводить на основной эндпоинт. Получи ключ в личном кабинете QwenCloud и добавь профиль модели в настройки Cursor:
{
  "cursor.models": [
    {
      "name": "qwen4-max",
      "displayName": "Qwen 4-Max (Alibaba)",
      "baseUrl": "https://dashscope.aliyuncs.com/compatible-mode/v1",
      "apiKey": "sk-your-dashscope-key",
      "contextWindow": 1000000,
      "maxOutputTokens": 16384,
      "supportsThinking": true
    }
  ]
}
Давай разберёмся, что мы здесь прописали. Параметр baseUrl направляет запросы редактора на OpenAI-совместимый шлюз DashScope, а contextWindow в миллион токенов позволяет Cursor отдавать модели крупные деревья файлов без обрезки. Флаг supportsThinking открывает доступ к цепочке рассуждений, а maxOutputTokens ограничивает ответ шестнадцатью тысячами токенов на шаг.
Теперь прогоним наш сценарий на монолите в 50 000 строк. Скармливаем модели файл с архитектурой, корневые модули и просим разнести логику по сервисам. На первом проходе Thinking Mode тратит около 25 секунд на анализ зависимостей, молча составляет внутренний чеклист несовместимых типов и выдаёт модульный рефакторинг без потери контекста. Повторные обращения к проиндексированному ядру проходят по кэшу за $0,075 за миллион токенов, а лимит в 5 миллионов токенов в минуту позволяет запускать сразу нескольких агентов: на тарифе Light работают один-два агента, на Pro от шести до восьми.
Если ты автоматизируешь рефакторинг из скриптов, то же самое поднимается через стандартный OpenAI SDK на Python. В следующем примере мы просим модель перевести монолитный сервис авторизации на распределённые токены OAuth2 с включённым режимом рассуждений:
from openai import OpenAI

client = OpenAI(
    api_key="sk-your-dashscope-key",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "system", "content": "You are a systems architect. Think step by step before generating code."},
        {"role": "user", "content": "Refactor monolithic auth service into distributed OAuth2 tokens."}
    ],
    extra_body={"enable_thinking": True}
)
print(completion.choices[0].message.content)
Посмотрим на ключевые строки этого вызова. Клиент OpenAI работает с серверами Alibaba напрямую через подмену base_url и имя модели qwen4-max. За цепочку рассуждений отвечает словарь extra_body с флагом enable_thinking, а системный промпт задаёт роль архитектора. Для быстрой правки достаточно переключить флаг в False или снизить уровень мышления, чтобы модель не тратила секунды впустую. Плюс в API уже встроены вызов функций, строгий JSON, пакетная обработка, веб-поиск, извлечение страниц и интерпретатор кода.
Где модель отрабатывает на отлично, а где ей не место
У Qwen 4-Max есть чёткая зона комфорта и жёсткие границы. Модель уверенно вытягивает разбор устаревших репозиториев, годовых логов переписок или пачек спецификаций в рамках миллиона токенов. Она хорошо держится в длинных агентских цепочках с пошаговой проверкой, в аудите интерфейсов по скриншотам и в сессиях с активным кэшированием контекста.
Тащить её в три сценария сейчас не стоит. Если политика безопасности запрещает отправлять код во внешнее облако, флагман не подойдёт: веса закрыты, локально модель не развернуть, а дат выхода открытых младших моделей Qwen 4 ещё нет. При работе из Европы до азиатских серверов DashScope задержка до первого токена держится на уровне 200–400 миллисекунд, что заметно тормозит интерактивное автодополнение на лету. Наконец, задачи по анализу уязвимостей и пентестингу лучше оставить другим инструментам — защитные фильтры платформы регулярно блокируют даже легитимный код сетевого аудита.