В ноябре разработчик Yuansong выложил на PostgreSQL News первую версию pg_fastload 1.0.0 — открытого загрузчика больших объёмов данных под лицензией BSD 3-Clause. Поводом стала знакомая картина на многоядерном сервере: запускаешь импорт гигабайтного CSV на 16 ядрах, смотришь в монитор, а там потеет ровно одно ядро, пока пятнадцать остальных простаивают.
Автор взял за основу утилиту pg_bulkload 3.1.23 и перенёс разбор строк на пул фоновых процессов PostgreSQL. Синтаксис управляющих файлов и режимы записи остались прежними, но скорость заливки гигабайтного файла выросла в 6,07 раза относительно штатного COPY и до 4,7 раза относительно быстрого режима самого pg_bulkload на CSV.
Почему стандартный COPY упирается в одно ядро
Когда нужно залить в базу миллионы строк логов или аналитики, первым делом берут встроенный COPY ... FROM. Кажется, что главный тормоз сидит в диске или журнале предзаписи WAL. На практике в однопоточном импорте процессор задыхается ещё до записи страниц на диск.
Весь конвейер внутри COPY от чтения файла до раскладки страниц крутится в одном серверном процессе. Для CSV внутри работает конечный автомат, который жуёт поток байт за байтом, ищет разделители с кавычками и на каждый столбец вызывает функцию преобразования типа. На машине с 16 vCPU пятнадцать ядер бездельничают, пока одно ядро упирается в потолок на парсинге текста.
Чтобы обойти этот затор, большой файл режут на куски и запускают десяток параллельных сессий psql. Способ рабочий, но без единой транзакции: если один поток споткнётся о битую строку и упадёт, в таблице останется каша из кусков, которые другие сессии уже успели зафиксировать.
Как устроен конвейер pg_fastload: один читает, пятнадцать парсят
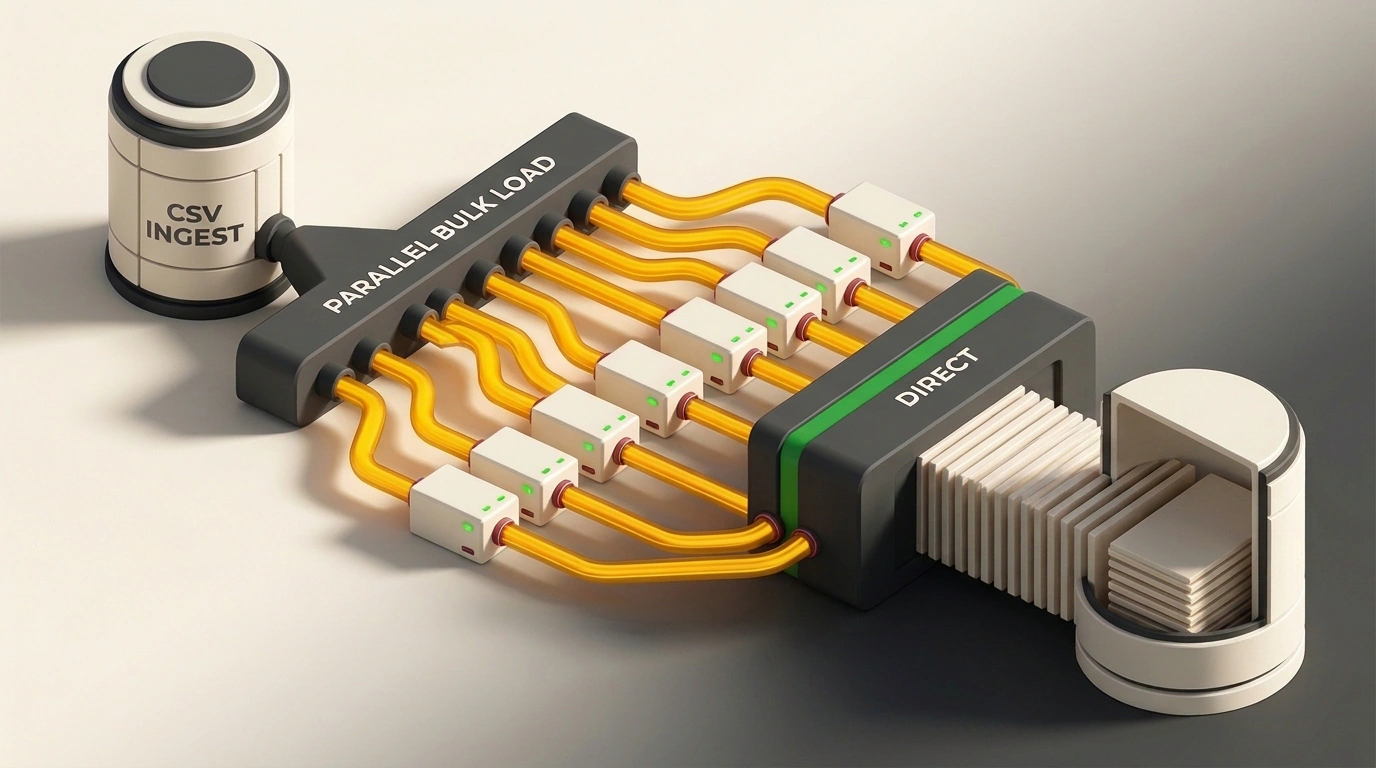
Массовая загрузка данных в обход обычного SQL-парсера называется bulk loading. Для её распараллеливания внутри одного подключения pg_fastload использует фоновые процессы ядра PostgreSQL — background workers и быстрые очереди в общей памяти shm_mq. Это кольцевые буферы в оперативке, через которые процессы обмениваются пачками данных без сети и диска.
Конвейер утилиты разделён на три шага, где чтение и вставка изолированы от парсинга:
[ Файл на диске ]
        │
        ▼  (чтение ровно 1 раз)
[ 1 reader worker ] ──(shm_mq)──▶ [ N parser workers ] ──▶ [ 1 leader backend ]
                                   (парсинг + HeapTuple)    (запись страниц в БД)
Работа в этой цепочке распределена строго по ролям, чтобы убрать лишнее чтение:
- Чтение в один проход. Выделенный
reader workerпоследовательно сканирует файл ровно один раз. Воркеры к файлу не лезут, поэтому объём чтения равен 1x размера файла и скорость не падает на дампе больше кэша ОС. - Параллельный разбор. Пачки байт по очередям
shm_mqуходят в пулparser workers. Каждый воркер на своём ядре рубит строки на поля, переводит типы и собирает бинарные кортежиHeapTuple— внутреннее представление строки таблицы. - Последовательная вставка. Готовые кортежи возвращаются в лидерный процесс, и он один раскладывает их по 8-килобайтным страницам базы.
Даже при PARALLEL = OFF расширение обгоняет прародителя pg_bulkload в 1,22 раза: для строк без кавычек и возврата каретки побайтовый перебор заменён поиском разделителей через memchr.
Сборка, управляющий файл .ctl и мониторинг
Допустим, перед тобой лежит свежий дамп событий или тестовый набор lineitem, и его нужно прогнать в базу за секунды. Проект собирается для PostgreSQL 15–19 из единой ветки кода через макросы PG_VERSION_NUM. Сборка из исходников идёт через стандартный PGXS:
git clone https://github.com/yuansong/pg_fastload.git
cd pg_fastload

make
sudo make install
После установки бинарников активируй расширение в целевой базе под суперпользователем. Зайди в psql и выполни команду:
CREATE EXTENSION pg_fastload;
Она создаст схему pgfastload со служебными функциями и представлением прогресса. Затем опиши задачу в управляющем файле lineitem_fastload.ctl — его синтаксис полностью совместим с документацией pg_bulkload:
OUTPUT = public.lineitem
INPUT = /var/data/lineitem.csv
TYPE = CSV

WRITER = DIRECT

PARALLEL = ON
PARALLEL_WORKERS = 15

SKIP_INDEX = ON
PROGRESS_NOTICE = ON
Директивы OUTPUT, INPUT и TYPE задают таблицу, файл и формат (CSV, FIXED или BINARY). Параметр PARALLEL = ON запускает пул из 15 воркеров, SKIP_INDEX = ON ускоряет работу с индексами, а PROGRESS_NOTICE = ON стримит прогресс прямо в консоль.
Запускается загрузка одной командой в терминале:
pg_fastload -d analytics_db -U postgres lineitem_fastload.ctl
Утилита поднимет воркеров и перекачает данные внутри одной транзакции. На объёмах в десятки гигабайт удобно следить за ходом задачи из соседней SQL-сессии через кластерное представление:
SELECT pid,
       read_bytes / 1024 / 1024 AS read_mb,
       written_tuples,
       load_rate,
       progress_percent,
       eta
FROM pgfastload.pg_fastload_progress;
Запрос показывает PID процесса, прочитанные мегабайты, счётчик строк, текущую скорость в МБ/с и прогноз времени до финиша. В обратную сторону работает pg_fastload_export(): выгрузка таблицы или SELECT в CSV, BINARY или FIXED идёт до 9,33 раза быстрее COPY TO — 7,4 миллиона строк объёмом 1,13 ГиБ сливаются за 0,42 секунды против 4,08 секунды в один поток. Лог экспорта фиксирует отпечаток снимка MVCC (xmin, xmax, cid) для точного аудита выгруженного среза.
Одна транзакция, обход WAL и что делать при падении сервера
За рекордную скорость приходится платить вниманием к механике записи. Весь параллельный парсинг идёт до вставки, а лидер держит одну обычную транзакцию. Если на десятимиллионной строке попадётся мусор, транзакция откатится целиком.
Почему 15 воркеров упираются в потолок 1,37 секунды на гигабайт, когда CPU на парсинге уже разгружен? Здесь срабатывает предел третьего шага: лидер в одиночку набивает 8-килобайтные страницы и сбрасывает их в хранилище. На отметке 1,37 с/ГиБ узким местом становится именно заполнение страниц и журнальная нагрузка.
Поведение хранилища задаёт параметр WRITER:
- Режим
WRITER = DIRECT. Он включён по умолчанию и пишет страницы прямо в файлы таблицы, минуяshared_buffersи запись строк в WAL. При ошибках данных транзакция лидера откатывается штатно, но при аварийном падении сервера перезапускpg_ctl startс проигрыванием WAL эти правки не увидит. Плюс такие строки не уходят на реплики и в архивы PITR. - Режим
WRITER = BUFFERED. Запись идёт черезshared_buffersс полным логированием в WAL. Скорость падает ориентировочно до 2,5–3,5 секунды на гигабайт CSV, зато репликация и автовосстановление работают штатно.
Чтобы не получить битую таблицу после ребута в режиме DIRECT, утилита хранит статусы .loadstatus в $PGDATA/pg_bulkload/. Если сервер рухнул во время заливки, до возврата трафика запусти ручной откат:
pg_fastload -r -d analytics_db -U postgres
Ключ -r прочитает файлы .loadstatus и вычистит незавершённые прямые записи из файлов таблицы. В боевых системах с репликами надёжнее сразу ставить WRITER = BUFFERED, а DIRECT приберечь для стейджинга и аналитических витрин без репликации.
Цифры замеров и границы применимости
Автор измерил скорость на 1 ГиБ данных lineitem из TPC-H — это 7 375 042 строки CSV на 16 vCPU с тёплым кэшем, пустой таблицей без индексов и WRITER = DIRECT. По медиане трёх прогонов расклад вышел такой:
| Инструмент и режим (1 GiB CSV) | Время | Ускорение к COPY FROM |
|---|---|---|
pg_fastload (15 воркеров) | 1,37 с | 6,07x |
pg_fastload (4 воркера) | 1,58 с | 5,27x |
pg_fastload (PARALLEL = OFF) | 5,81 с | 1,43x |
pg_bulkload 3.1.23 (WRITER = DIRECT) | 6,98 с | — |
COPY в UNLOGGED таблицу | 7,51 с | — |
Штатный COPY ... FROM | 8,32 с | 1,00x |
В полной матрице форматов на трёх чередующихся раундах видна ещё одна тонкость. Самый быстрый режим оригинального pg_bulkload — двухпроцессный WRITER = PARALLEL, обгоняющий DIRECT примерно на 13%. На форматах BINARY и FIXED pg_fastload быстрее него до 1,58 раза: от 0,88 секунды против 1,39 и от 0,90 против 1,42 соответственно. А на CSV разрыв достигает 4,7 раза — 1,40 секунды против 6,63 у быстрого режима pg_bulkload и 9,22 у BUFFERED.
На таблицах с индексами выручает SKIP_INDEX = ON. Обслуживание одного btree-индекса при загрузке не параллелится и отнимает около 1,9 секунды на гигабайт, поэтому утилита в той же транзакции удаляет вторичные btree-индексы, заливает строки и печатает команды CREATE INDEX для их пересоздания. Индексы под PRIMARY KEY, UNIQUE и EXCLUSION при этом защищены от удаления.
Параллельный движок включается не всегда: в коде зашиты 13 условий автоматического отката на последовательный путь с записью INFO в лог. Распараллеливание отключается при фильтрах FILTER и FORCE_NOT_NULL, явном ENCODING, допуске ошибок PARSE_ERRORS > 0, потоке STDIN, типах TUPLE или FUNCTION, ограничениях NOT NULL и CHECK, а также на сложных партициях с внешними таблицами и триггерами. В этих случаях pg_fastload переходит на оптимизированный однопоточный путь, который на строках без кавычек всё равно опережает COPY.