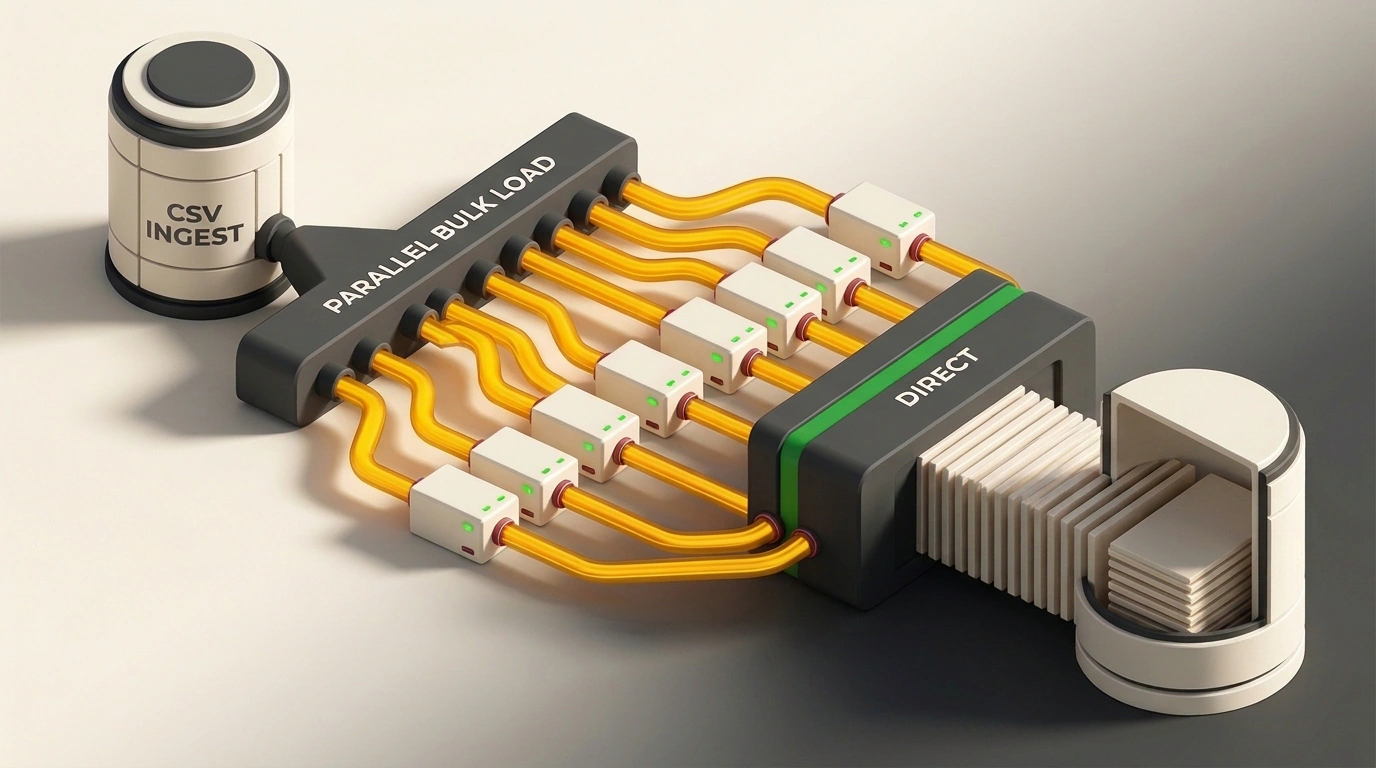
En noviembre, el desarrollador Yuansong publicó en PostgreSQL News la primera versión de pg_fastload 1.0.0, un cargador de grandes volúmenes de datos de código abierto bajo licencia BSD 3-Clause. El detonante fue una escena conocida en cualquier servidor multinúcleo: lanzas la importación de un CSV de varios gigabytes en una máquina de 16 núcleos, miras el monitor del sistema y ves sudar a un solo núcleo mientras los otros quince están sin hacer nada.
El autor tomó como base la utilidad pg_bulkload 3.1.23 y movió el análisis de filas a un grupo de procesos en segundo plano de PostgreSQL. La sintaxis de los archivos de control y los modos de escritura siguen iguales, pero la velocidad de carga de un archivo de 1 GiB subió 6.07 veces frente al COPY nativo y hasta 4.7 veces frente al modo rápido del propio pg_bulkload en CSV.
Por qué el COPY estándar choca con un solo núcleo
Cuando toca meter millones de filas de logs o analítica en la base, lo primero que uno usa es el comando integrado COPY ... FROM. Uno suele pensar que el freno está en el disco o en el registro previo WAL. En la práctica, en una importación de un solo hilo, el procesador se ahoga incluso antes de escribir páginas en disco.
Todo el flujo interno de COPY, desde leer el archivo hasta acomodar páginas, gira dentro de un único proceso del servidor. Para CSV trabaja una máquina de estados finitos que mastica el flujo byte por byte, busca delimitadores y comillas, y llama a la función de conversión de tipo en cada columna. En una máquina con 16 vCPU, quince núcleos quedan ociosos mientras uno toca techo parseando texto.
Para saltarse ese embotellamiento, muchos parten el archivo grande en pedazos y lanzan diez sesiones paralelas de psql. Funciona, pero pierdes la transacción única: si un flujo tropieza con una fila dañada y cae, en la tabla queda un revoltijo con los trozos que las demás sesiones ya confirmaron.
Cómo funciona el pipeline de pg_fastload: uno lee, quince parsean
La carga masiva de datos saltándose el parser SQL normal se llama bulk loading. Para paralelizarla dentro de una misma conexión, pg_fastload usa procesos en segundo plano del núcleo de PostgreSQL (background workers) y colas rápidas en memoria compartida shm_mq. Son búferes circulares en RAM por donde los procesos intercambian lotes de datos sin pasar por red ni disco.
El flujo de la herramienta se divide en tres pasos, aislando lectura e inserción del parseo:
[ Archivo en disco ]
        │
        ▼  (lectura 1 sola vez)
[ 1 reader worker ] ──(shm_mq)──▶ [ N parser workers ] ──▶ [ 1 leader backend ]
                                   (parseo + HeapTuple)     (escritura en BD)
El trabajo en esta cadena se reparte por roles estrictos para evitar lecturas redundantes:
- Lectura en una pasada. Un
reader workerdedicado recorre el archivo de forma secuencial una sola vez. Los demás workers no tocan el archivo, así que el volumen leído es exactamente 1x el tamaño del archivo y la velocidad no cae cuando el dump supera la caché del sistema. - Análisis en paralelo. Los bloques de bytes viajan por colas
shm_mqhacia el grupo deparser workers. Cada worker, en su propio núcleo, corta las filas en campos, convierte tipos y arma tuplas binariasHeapTuple, la representación interna de una fila en la tabla. - Inserción secuencial. Las tuplas listas regresan al proceso líder, que es el único encargado de acomodarlas en las páginas de 8 KB de la base.
Incluso con PARALLEL = OFF, la extensión supera a su antecesor pg_bulkload en 1.22 veces: para líneas sin comillas ni retornos de carro, el recorrido byte a byte se reemplazó por búsqueda de delimitadores con memchr.
Compilación, archivo de control .ctl y monitoreo
Supongamos que tienes un dump reciente de eventos o el conjunto de pruebas lineitem y necesitas cargarlo en segundos. El proyecto compila para PostgreSQL 15 a 19 desde una sola rama usando macros PG_VERSION_NUM. La compilación desde fuentes usa el PGXS estándar:
git clone https://github.com/yuansong/pg_fastload.git
cd pg_fastload

make
sudo make install
Después de instalar los binarios, activa la extensión en la base de destino como superusuario. Entra a psql y ejecuta:
CREATE EXTENSION pg_fastload;
Esto crea el esquema pgfastload con sus funciones auxiliares y la vista de progreso. Luego describe la tarea en el archivo de control lineitem_fastload.ctl, cuya sintaxis es totalmente compatible con la documentación de pg_bulkload:
OUTPUT = public.lineitem
INPUT = /var/data/lineitem.csv
TYPE = CSV

WRITER = DIRECT

PARALLEL = ON
PARALLEL_WORKERS = 15

SKIP_INDEX = ON
PROGRESS_NOTICE = ON
Las directivas OUTPUT, INPUT y TYPE fijan la tabla, el archivo y el formato (CSV, FIXED o BINARY). El parámetro PARALLEL = ON levanta un grupo de 15 workers, SKIP_INDEX = ON acelera el manejo de índices y PROGRESS_NOTICE = ON imprime el avance directo en consola.
La carga arranca con un solo comando en terminal:
pg_fastload -d analytics_db -U postgres lineitem_fastload.ctl
La herramienta levanta los workers y mueve los datos dentro de una sola transacción. Con volúmenes de decenas de gigabytes conviene vigilar el progreso desde otra sesión SQL usando la vista del clúster:
SELECT pid,
       read_bytes / 1024 / 1024 AS read_mb,
       written_tuples,
       load_rate,
       progress_percent,
       eta
FROM pgfastload.pg_fastload_progress;
La consulta muestra el PID del proceso, los megabytes leídos, el contador de filas, la velocidad actual en MB/s y el tiempo estimado para terminar. En sentido inverso funciona pg_fastload_export(): exportar una tabla o un SELECT a CSV, BINARY o FIXED corre hasta 9.33 veces más rápido que COPY TO, volcando 7.4 millones de filas (1.13 GiB) en 0.42 segundos frente a 4.08 segundos en un solo hilo. El log de exportación guarda la huella de la instantánea MVCC (xmin, xmax, cid) para auditar con exactitud el corte extraído.
Una transacción, salto del WAL y qué hacer si cae el servidor
Esa velocidad récord exige prestar atención a cómo se escribe en disco. Todo el parseo paralelo ocurre antes de insertar, mientras el líder mantiene una transacción normal. Si en la fila diez millones aparece basura, toda la transacción se revierte completa.
¿Por qué 15 workers topan en el techo de 1.37 segundos por gigabyte si la CPU del parseo ya quedó libre? Ahí aparece el límite del tercer paso: el líder arma las páginas de 8 KB y las baja al almacenamiento él solo. En la marca de 1.37 s/GiB, el cuello de botella pasa a ser el llenado de páginas y la carga de registro.
El comportamiento del almacenamiento lo define WRITER:
- Modo
WRITER = DIRECT. Viene activo por defecto y escribe páginas directo en los archivos de la tabla, saltándoseshared_buffersy el registro de filas en el WAL. Si hay errores en los datos, la transacción del líder se revierte sin problemas; pero si el servidor cae de golpe, un reinicio conpg_ctl startreproduciendo el WAL no verá esos cambios. Además, esas filas no llegan a réplicas ni a archivos PITR. - Modo
WRITER = BUFFERED. La escritura pasa porshared_bufferscon registro completo en el WAL. La velocidad baja a unos 2.5 a 3.5 segundos por gigabyte de CSV, pero la replicación y la recuperación automática funcionan con normalidad.
Para evitar tablas dañadas tras un reinicio en modo DIRECT, la utilidad guarda estados .loadstatus en $PGDATA/pg_bulkload/. Si el servidor se cae en medio de una carga, corre una reversión manual antes de devolver tráfico:
pg_fastload -r -d analytics_db -U postgres
La bandera -r lee los archivos .loadstatus y limpia de la tabla las escrituras directas inconclusas. En sistemas en producción con réplicas es más seguro usar WRITER = BUFFERED desde el inicio y reservar DIRECT para entornos de staging y tablas analíticas sin replicación.
Cifras de prueba y límites de uso
El autor midió el rendimiento sobre 1 GiB de datos lineitem de TPC-H: 7,375,042 filas CSV en 16 vCPU con caché caliente, tabla vacía sin índices y WRITER = DIRECT. La mediana de tres ejecuciones dio estos resultados:
| Herramienta y modo (1 GiB CSV) | Tiempo | Aceleración frente a COPY FROM |
|---|---|---|
pg_fastload (15 workers) | 1.37 s | 6.07x |
pg_fastload (4 workers) | 1.58 s | 5.27x |
pg_fastload (PARALLEL = OFF) | 5.81 s | 1.43x |
pg_bulkload 3.1.23 (WRITER = DIRECT) | 6.98 s | — |
COPY a tabla UNLOGGED | 7.51 s | — |
COPY ... FROM nativo | 8.32 s | 1.00x |
En la matriz completa de formatos tras tres rondas alternadas se nota otro detalle. El modo más rápido del pg_bulkload original es WRITER = PARALLEL con dos procesos, que supera a DIRECT por cerca de 13%. En formatos BINARY y FIXED, pg_fastload es hasta 1.58 veces más veloz: desde 0.88 segundos contra 1.39, y desde 0.90 contra 1.42 respectivamente. En CSV la ventaja llega a 4.7 veces: 1.40 segundos frente a 6.63 del modo rápido de pg_bulkload y 9.22 de BUFFERED.
En tablas con índices ayuda SKIP_INDEX = ON. Mantener un índice btree durante la carga no se paraleliza y consume unos 1.9 segundos por gigabyte, así que la herramienta borra los índices btree secundarios dentro de la misma transacción, carga las filas e imprime los comandos CREATE INDEX para recrearlos. Los índices de PRIMARY KEY, UNIQUE y EXCLUSION quedan protegidos y no se borran.
El motor paralelo no se activa siempre: el código incluye 13 condiciones de repliegue automático a la ruta secuencial dejando un aviso INFO en el log. El paralelismo se desactiva con filtros FILTER y FORCE_NOT_NULL, ENCODING explícito, tolerancia PARSE_ERRORS > 0, flujo STDIN, tipos TUPLE o FUNCTION, restricciones NOT NULL y CHECK, y en particiones complejas con tablas externas o triggers. En esos casos, pg_fastload pasa a la ruta optimizada de un solo hilo, que en filas sin comillas sigue superando a COPY.