El 16 de noviembre, Alibaba lanzó su modelo insignia Qwen 4-Max, y en este estreno saltan a la vista dos paradojas. La red creció hasta 2.4 billones de parámetros, pero en la práctica gasta cerca de la mitad de tokens que Qwen 3.8 Max, lanzado hace tres meses. La segunda sorpresa llama aún más la atención: la empresa que acostumbró al mercado a pesos abiertos potentes para ejecución local cerró esta vez su modelo insignia detrás de una API en la nube.
Cómo funcionan 2.4 billones de parámetros y qué falla en los benchmarks
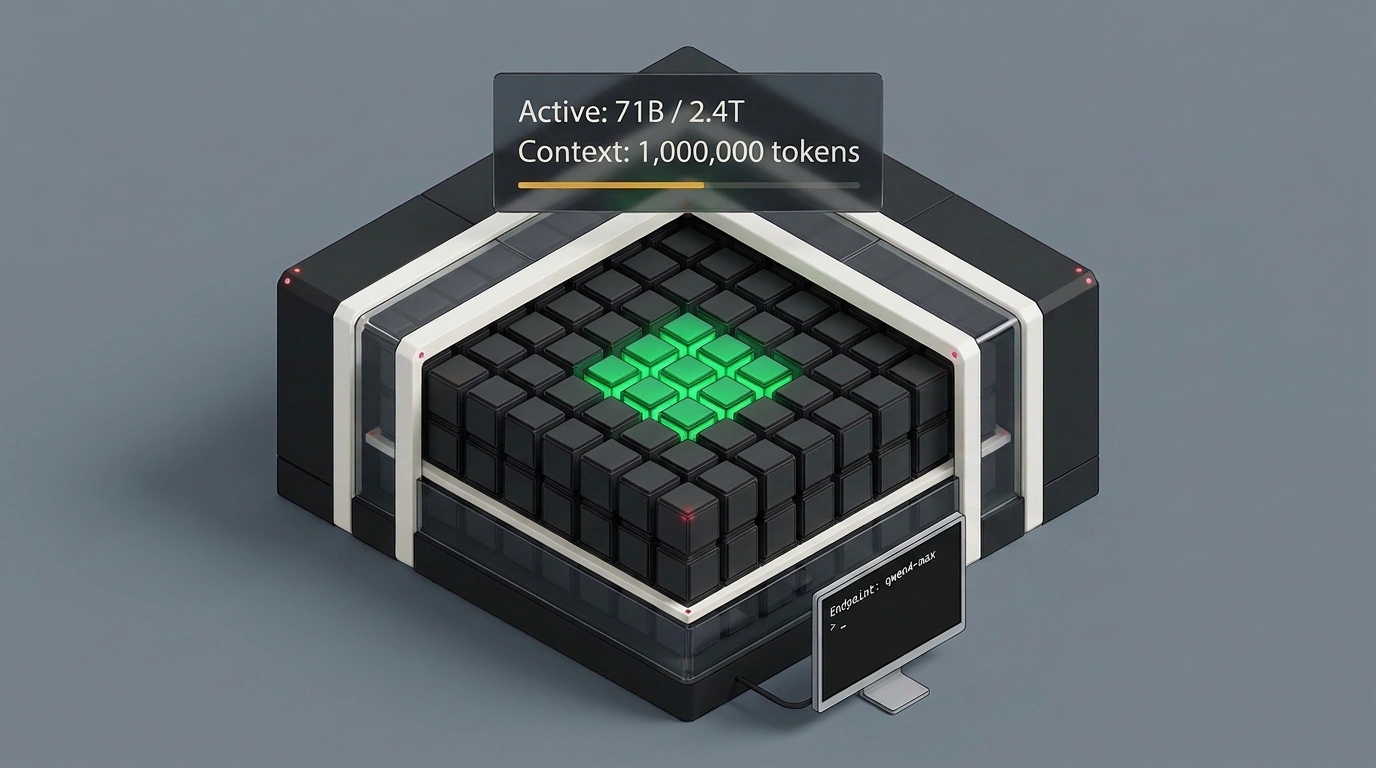
Asomémonos a la arquitectura para entender de dónde sale el ahorro con semejante tamaño. Por debajo opera una arquitectura dispersa Mixture of Experts. El mecanismo se parece a una clínica enorme con dos mil médicos: cuando llegas con dolor de rodilla, te atienden dos especialistas del área y no todo el hospital a la vez. De forma parecida, por cada token aquí se activan solo 71 mil millones de parámetros de los 2.4 billones, frente a los cerca de 95 mil millones que encendía el modelo insignia anterior. Otros 328 mil millones viven en capas de N-gram embeddings, una chuleta rápida para combinaciones sintácticas frecuentes que evita gastar ciclos en código rutinario.
La ventana de contexto se amplió al millón de tokens, y según la ficha técnica alcanza hasta 991 mil tokens de entrada y 393 mil de salida. Con ese volumen, los modelos comunes suelen perder detalles en medio de un archivo largo. Para evitar que la atención decaiga, los ingenieros de Alibaba integraron capas Gated DeltaNet y atención dispersa Qwen Sparse Attention. La visión es nativa: el modelo lee capturas de interfaces y video directamente, aunque responde solo en texto y no genera imágenes.
En los gráficos de lanzamiento los números lucen contundentes. En el análisis del canal Julian Goldie SEO muestran el caso de las fábricas SANF y Pacific Union: programar una máquina de corte metálico bajó de 475 minutos a 24 minutos. En la prueba Work360 para tareas profesionales largas, el modelo obtuvo 52.69 puntos frente a 47.74 de Qwen 3.8 Max. En la prueba a ciegas de frontend Code Arena ocupó el sexto lugar mundial, en Design Arena quedó cuarto en presentaciones y quinto en tablas, y en Healthbench Professional subió de 39.6 a 60.0 puntos.
Comparemos ahora las promesas con la realidad. Tanto el caso industrial como las mediciones de Work360 los realizó la propia Alibaba, y todavía no hay replicaciones independientes. Las mediciones aisladas de los primeros usuarios, como acelerar una tarea de programación de 17 a 2.5 minutos o una animación de 19 a 12 minutos, siguen siendo solo una referencia inicial. Los benchmarks de los fabricantes suelen centrarse en ejercicios limpios estilo LeetCode, mientras que en proyectos reales con bibliotecas externas el modelo aún exige instrucciones estrictas sobre tipos.
En cambio, las tarifas en QwenCloud son claras. El millón de tokens de entrada cuesta $1.50, el millón de salida cuesta $4.50 y la entrada en caché cae a $0.075 por millón. Para sesiones largas de trabajo sobre un mismo repositorio, el caché aporta el mayor ahorro.
Thinking Mode, entrega por etapas y trampas ocultas
Veamos qué ocurre por dentro ante una tarea compleja. Qwen 4-Max incluye el modo de razonamiento Thinking Mode con un límite de cadena de pensamiento de hasta 262 mil tokens. Antes de entregar código o un esquema, la red prueba hipótesis, valida casos límite y detecta contradicciones. Esto ayuda mucho en demostraciones matemáticas, análisis de contratos y diseño de microservicios.
Eso sí, con la configuración por defecto es fácil equivocarse. El razonamiento tiene tres niveles de profundidad (low, medium y extra high), y el máximo extra high viene activado de serie. Como señaló con acierto Julian Goldie, usar el nivel máximo para cambios menores equivale a reunir a un comité de arquitectos para elegir la fuente de un botón. En peticiones pequeñas, el modelo se vuelve prolijo y quema tiempo sin sentido.
La segunda función destacada es la entrega por etapas Staged Delivery, para la cual Alibaba liberó el código del plugin Live Delivery. Una IA tradicional guarda silencio durante mucho rato en una tarea grande y al final suelta un bloque enorme donde un fallo del segundo paso recién se nota en el cincuenta. Aquí el modelo entrega una primera estructura funcional sobre la marcha, como un constructor que muestra la estructura de la casa antes de poner el techo. Gracias a su visión nativa, puede revisar por sí mismo una captura de la interfaz o una escena 3D y ajustar la maquetación según tus comentarios a mitad de camino.
En tareas de ingeniería profunda quedan dos asperezas. En refactorizaciones de varios archivos en TypeScript, el modelo pierde por momentos la coherencia en los nombres de tipos si no los fijas de forma estricta en el prompt. Además, la plataforma aplica un filtrado estricto de ciberseguridad: una auditoría legítima de código de red o pruebas de penetración pueden chocar con rechazos falsos.
Conectamos Qwen 4-Max a Cursor y refactorizamos un monolito
Pasemos de la teoría a la práctica. Supongamos que en el repositorio hay un viejo monolito en Express.js y TypeScript con 50,000 líneas de código. Una ventana de contexto pequeña obliga a cortar módulos en trozos y perder conexiones entre archivos, pero aquí necesitamos pasarle al modelo toda la arquitectura junta.
Puedes conectar Qwen 4-Max a Cursor, Cline, Continue, Claude Code, Codex, OpenCode y QwenCode: la API entiende los formatos de OpenAI y Anthropic, y el modelo también está disponible en Qwen Studio, QwenWork, Coder, OpenRouter y Vercel. Un detalle importante: la vista previa de noviembre del 11 de noviembre se apaga el 25 de noviembre, así que conviene migrar las integraciones activas al endpoint principal. Consigue una clave en tu cuenta de QwenCloud y agrega el perfil del modelo en la configuración de Cursor:
{
  "cursor.models": [
    {
      "name": "qwen4-max",
      "displayName": "Qwen 4-Max (Alibaba)",
      "baseUrl": "https://dashscope.aliyuncs.com/compatible-mode/v1",
      "apiKey": "sk-your-dashscope-key",
      "contextWindow": 1000000,
      "maxOutputTokens": 16384,
      "supportsThinking": true
    }
  ]
}
Veamos qué configuramos aquí. El parámetro baseUrl envía las peticiones del editor a la pasarela DashScope compatible con OpenAI, y contextWindow de un millón de tokens permite que Cursor envíe árboles grandes de archivos sin recortes. La bandera supportsThinking habilita la cadena de razonamiento y maxOutputTokens limita la respuesta a dieciséis mil tokens por paso.
Ahora ejecutemos nuestro escenario sobre el monolito de 50,000 líneas. Le damos al modelo el archivo de arquitectura junto con los módulos raíz y le pedimos separar la lógica en servicios. En la primera pasada, Thinking Mode tarda unos 25 segundos en analizar dependencias, arma en silencio una lista interna de tipos incompatibles y devuelve una refactorización modular sin perder el contexto. Las consultas siguientes al núcleo indexado pasan por caché a $0.075 por millón de tokens, y el límite de 5 millones de tokens por minuto permite lanzar varios agentes a la vez: en el plan Light corren uno o dos agentes y en Pro entre seis y ocho.
Si automatizas refactorizaciones desde scripts, puedes montar lo mismo con el SDK estándar de OpenAI en Python. En el siguiente ejemplo le pedimos al modelo migrar un servicio monolítico de autenticación a tokens distribuidos OAuth2 con el modo de razonamiento activo:
from openai import OpenAI

client = OpenAI(
    api_key="sk-your-dashscope-key",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

completion = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "system", "content": "You are a systems architect. Think step by step before generating code."},
        {"role": "user", "content": "Refactor monolithic auth service into distributed OAuth2 tokens."}
    ],
    extra_body={"enable_thinking": True}
)
print(completion.choices[0].message.content)
Fijémonos en las líneas clave de esta llamada. El cliente de OpenAI habla directo con los servidores de Alibaba cambiando base_url y el nombre del modelo qwen4-max. El diccionario extra_body con la bandera enable_thinking controla la cadena de razonamiento, y el prompt del sistema asigna el rol de arquitecto. Para un cambio rápido basta pasar esa bandera a False o bajar el nivel de razonamiento para que el modelo no pierda segundos de más. Además, la API ya integra llamada a funciones, JSON estricto, procesamiento por lotes, búsqueda web, extracción de páginas e intérprete de código.
Dónde brilla el modelo y dónde conviene evitarlo
Qwen 4-Max tiene una zona de confort clara y límites estrictos. El modelo resuelve con soltura el análisis de repositorios heredados, historiales anuales de conversaciones o paquetes completos de especificaciones dentro de su millón de tokens. Rinde bien en cadenas largas de agentes con revisión por pasos, en auditorías visuales de interfaces mediante capturas y en sesiones con uso intensivo de caché de contexto.
En cambio, hay tres escenarios donde por ahora no conviene llevarlo. Si tu política de seguridad prohíbe enviar código a una nube externa, este modelo insignia no sirve: los pesos son cerrados, no puede desplegarse en local y aún no hay fechas para versiones abiertas menores de Qwen 4. Al trabajar desde Europa hacia los servidores asiáticos de DashScope, la latencia hasta el primer token se mantiene entre 200 y 400 milisegundos, lo que frena bastante el autocompletado interactivo en tiempo real. Por último, es mejor dejar el análisis de vulnerabilidades y el pentesting a otras herramientas, ya que los filtros de la plataforma bloquean con frecuencia incluso código legítimo de auditoría de red.