Cuando conectas un agente de IA a tu código, pronto chocas con dos extremos. El primer camino es sentarte con el modelo sobre cada ticket del gestor y revisar línea por línea. Es seguro, pero mientras cuidas una sola tarea, todo el backlog queda detenido. El segundo camino parece más tentador: darle al agente las llaves del repositorio para que tome tickets por su cuenta y despliegue código directo a producción.
En proyectos reales, ese piloto automático se vuelve rápido una lotería. El desarrollador Cole Medin analizó este problema en un video reciente y publicó el framework abierto ai-software-factory. Según su esquema, la fábrica de código quita al humano el trabajo manual repetitivo entre tareas y le deja la planificación al inicio y la aceptación al final, distribuidos en cinco modelos de trabajo.
La ilusión de la «fábrica oscura» y el costo de especificaciones difusas
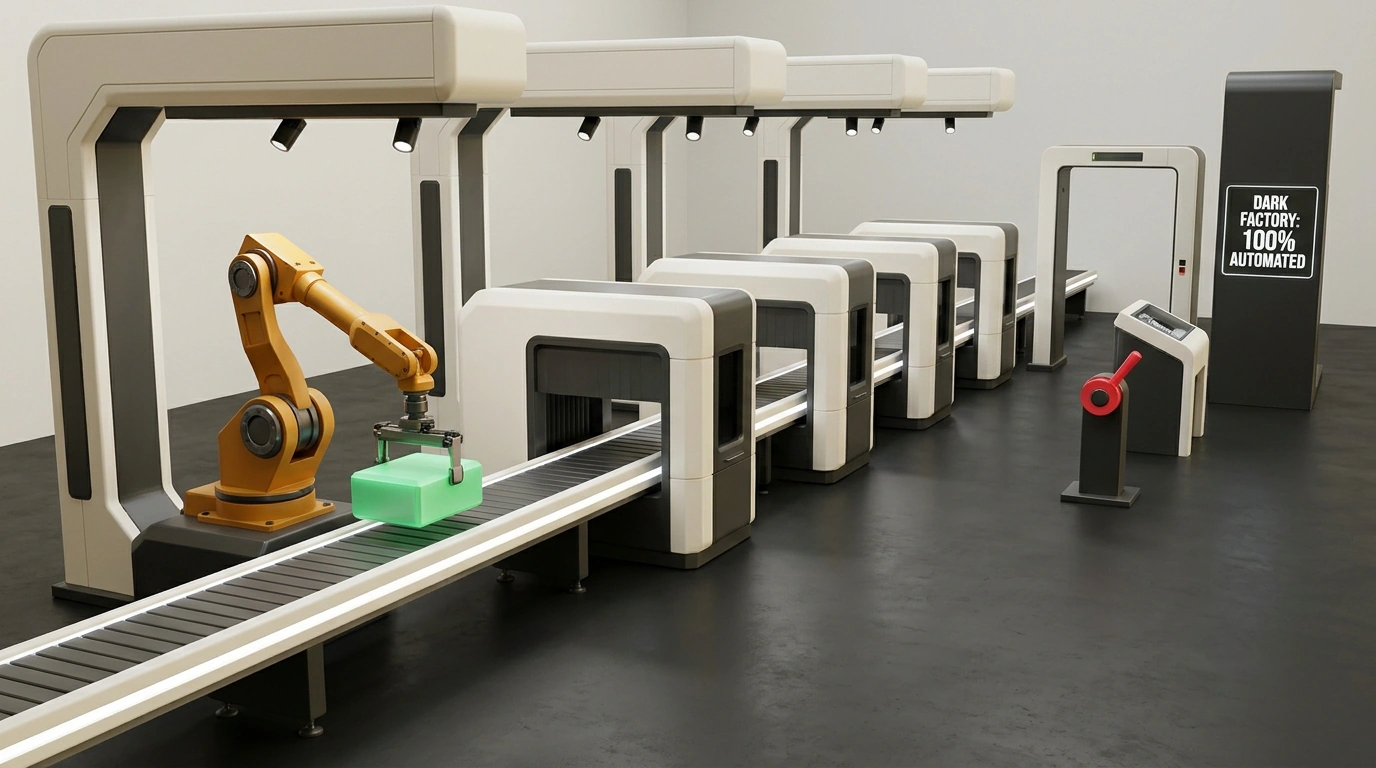
El grado máximo de autonomía es la Dark Factory, o «fábrica oscura». Lanzas una idea en borrador de un par de párrafos y los agentes la dividen en subtareas, escriben el código, se revisan entre ellos y despliegan directo a los usuarios.
Medin probó ese flujo en transmisiones en vivo: los modelos ejecutaban compilaciones sin problema y los revisores de IA filtraban fallos evidentes, pero en la aplicación igual aparecían errores sutiles. La causa está del lado humano: redactar requisitos cien por ciento inequívocos es casi imposible, y cualquier cabo suelto llega a producción como lógica defectuosa. El único lugar donde la «fábrica oscura» justifica el riesgo de quemar cientos de dólares en depuración infinita son prototipos rápidos en borrador que no duele descartar mañana.
De ahí sale la regla para elegir según dos ejes: cuánto control conservas y si las pruebas automáticas demuestran que el agente tiene razón. Cuanto más delicada sea la lógica de producto, más peligroso resulta quitar al humano.
Fleet Factory y PR Factory: dos puentes pragmáticos
Cuando la tarea tiene un resultado claro y medible, el piloto automático funciona sin tropiezos. Esa es la Fleet Factory, llamada así por la flota interna de agentes Honk en Spotify. Un flujo sin revisión manual recibe tareas rutinarias con pruebas estrictas: migraciones, tipado y limpieza de código. A través de Honk, en Spotify ya fusionaron más de 2.5 millones de cambios de mantenimiento, Airbnb migró 3,500 archivos de prueba en seis semanas y el motor Bun se reescribió de Zig a Rust.
Pero en tareas con margen de interpretación la magia desaparece. Los autores de un estudio reciente revisaron repositorios abiertos: los mantenedores rechazaban cerca de la mitad de los PR hechos por agentes incluso con pruebas en verde, porque el código no encajaba en la arquitectura del proyecto.
Para sistemas comerciales conviene más empezar con PR Factory, como en Stripe Minions. Los agentes avanzan tareas en segundo plano y abren para cada una un pull request separado con su lista de verificación, mientras un desarrollador revisa el código a ojo. El cuello de botella termina siendo el propio revisor: cuando al mediodía llegan veinte pull requests, el líder técnico pasa todo el día revisando diffs.
Release Factory y el circuito de autoaprendizaje desde producción
Para salir de la parálisis de revisiones ayuda Release Factory, la base del framework ai-software-factory. Junto con el agente armas un paquete de 10–20 tareas, una orden de trabajo para un lanzamiento. La fábrica vive en una carpeta aparte fuera del repositorio destino y dirige la construcción desde afuera mediante Archon y reglas estrictas.
El flujo arma un mapa de dependencias y lanza compilaciones en paralelo. Planificación, código, revisión y pruebas de usuario corren en sesiones nuevas con contexto limpio para que el modelo no se confunda con logs viejos ni se elogie a sí mismo. Arriba, un agente despachador vigila que las ramas no choquen en archivos compartidos.
Las ramas listas se fusionan en un lanzamiento común, pasan pruebas e2e completas y suben al entorno de pruebas staging. Al líder técnico le basta entrar allí una vez al día durante 15 minutos, probar el sistema y aprobar un único pull request consolidado. Eso sí: si las pruebas se escribieron solo por cumplir, a staging subirá código que parece vivo pero tiene defectos.
El quinto nivel, Self-Improving Factory, cierra el ciclo con los usuarios. A producción se conecta monitoreo como Sentry, PostHog o Langfuse, y un clasificador de alertas convierte fallos reales en nuevos tickets bajo la idea de que el uso real genera la siguiente tarea. Sin un filtro de ruido en Sentry, sin embargo, los agentes empezarán a corregir en masa fallos aleatorios de navegadores de clientes.
Además, el nivel de control se ajusta fácil por módulo: revisar los pagos línea por línea con PR Factory, aprobar funciones normales en staging con Release Factory y entregar las migraciones aburridas a la flota sin dudarlo.