El 13 de noviembre de 2026 salió la versión Google Antigravity 2.32.0. Sus principales novedades son el comando /run-workflow para flujos dinámicos, el enjambre actualizado /swarm con tablero de tareas y el soporte para modelos locales Gemma 4 en el SDK de Python. Los autores de la plataforma sacaron la gestión de cadenas de agentes del chat largo y la pasaron a un script común de Python.
Por qué un chat largo rompe a los agentes y qué tiene que ver Python
Seguro te ha pasado más de una vez en una conversación larga con una IA. Le das al agente una tarea de varios pasos: leer archivos, revisar código, corregir errores y armar un resumen. Los dos primeros pasos avanzan con energía, pero en el tercero el modelo olvida el formato, se salta una revisión o empieza a tocar archivos que no debía.
En los reportes de desarrolladores a esto se le llama deriva del prompt, o prompt drift. Mientras el agente abre archivos, lanza búsquedas y recopila logs de pruebas, todo ese material en bruto se acumula en una sola ventana. Los usuarios ya comprobaron en la práctica que los diálogos largos empiezan a fallar cuando el contexto se llena cerca de un 40%.
El comando /run-workflow saca el guion del chat y lo lleva a código. Escribes la tarea con palabras normales en la aplicación o en la terminal, y el planificador abre la habilidad integrada Run Workflow y genera un script corto de Python. No hace falta instalar Python aparte: Antigravity ya trae integrado un entorno de ejecución 3.8 o superior, aunque con la variable ANTIGRAVITY_PYTHON puedes conectar tu propio intérprete fácilmente.
Antes de arrancar, el entorno muestra el código generado y espera confirmación. En la aplicación te da cuatro opciones: permitir una vez, permitir en el chat actual, permitir siempre o cancelar. El permiso queda atado de forma estricta a esa versión exacta del script: si cambias un par de líneas, el sistema vuelve a preguntar.
Al iniciar, cada asistente trabaja en su propio chat. Los archivos leídos y los logs se quedan dentro de su sesión, y hacia arriba solo sube un JSON compacto validado con JSON Schema, un formulario estricto de campos obligatorios sin charla innecesaria. Un script que funcione bien se guarda fácil en un archivo como scripts/review_changes.py o scripts/roundup.py para repetirlo en cada lanzamiento.
Bajo el capó del flujo: fases, paralelo, pipeline y auditoría de clientes
Veamos cómo funciona un flujo en una auditoría real de cliente tomada de la demo de Julian Goldie. Como entrada hay un resumen de la llamada con el dueño del negocio y cinco carpetas por departamento: ventas, onboarding, prestación de servicios, contenido y soporte.
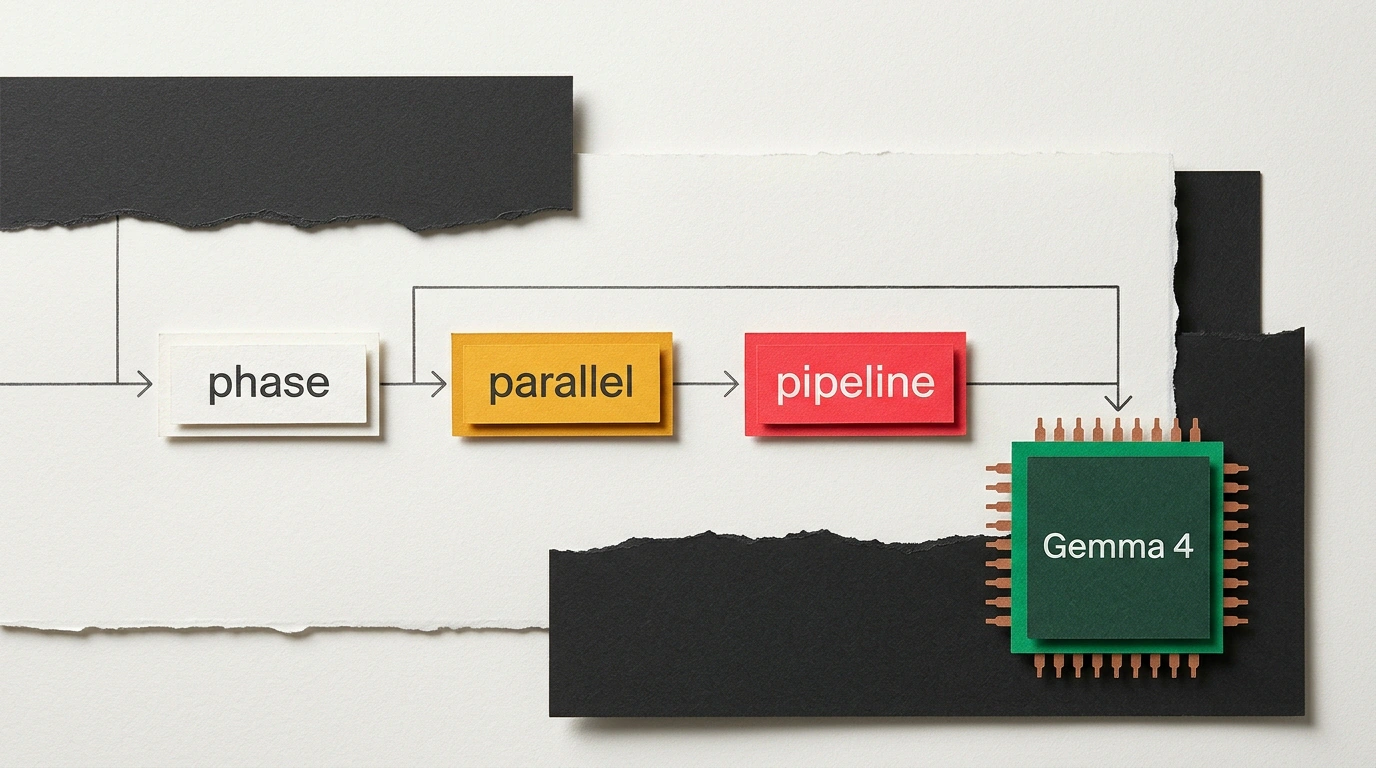
Dentro del SDK de Python, el escenario se arma con cuatro primitivas. La llamada agent lanza un subagente independiente con su propio prompt y el modelo elegido. El bloque phase divide el trabajo en capítulos para agrupar los logs y tarjetas de agentes por etapas. La llamada parallel ejecuta la misma tarea sobre toda la lista al mismo tiempo y devuelve los resultados en el orden original, aunque si falla una rama cancela las demás. El flujo pipeline encadena pasos en orden estricto cuando el siguiente agente necesita la salida del anterior: por ejemplo, primero un resumen semanal y después una lista de tres pendientes.
En la auditoría del cliente también ayuda un agente revisor permanente. Primero lee las notas de la llamada con el dueño, luego cinco agentes por departamento en parallel proponen tres automatizaciones cada uno y, al final, ese mismo revisor evalúa las quince ideas teniendo en cuenta la conversación original.
Veamos cómo luce un escenario parecido en código. Supongamos que antes de un lanzamiento hay que revisar un pull request con 40 archivos modificados:
# dynamic_workflow.py: orquestación de la revisión del repositorio
from antigravity_sdk import workflow, agent, parallel, phase

@workflow.run
async def audit_repository(files: list[str]):
    # Fase 1: Auditoría estática en paralelo de los archivos
    with phase("Security & Quality Audit"):
        audit_results = await parallel(
            files,
            lambda f: agent(
                model="gemini-4-flash",
                prompt=f"Perform static security analysis of file {f}. Return findings.",
                workspace="share",
            )
        )

    # Fase 2: Consolidación del informe único por el revisor principal
    with phase("Report Aggregation"):
        summary = await agent(
            model="gemini-4-pro",
            prompt=f"Aggregate findings into markdown summary: {audit_results}",
            workspace="inherit",
        )
    return summary
Analicemos este código línea por línea. El decorador @workflow.run marca el punto de entrada y la primera phase lanza mediante parallel el modelo rápido gemini-4-flash para cada archivo; en revisiones masivas de decenas de archivos suele usarse flash o flash_lite, dejando el modelo mayor gemini-4-pro para la síntesis final de la segunda fase.
Ten en cuenta dos reglas prácticas. Los subagentes dentro del script no ven el archivo Python ni se ven entre sí, así que pasa todo el contexto necesario directamente en prompt. Además, el parámetro workspace controla el acceso a archivos: inherit trabaja en la carpeta actual, share comparte el árbol de archivos sin duplicarlo en disco y branch crea un Git worktree aislado para que los agentes que escriben código no pisen los cambios del vecino.
Cuándo un script lineal no alcanza: enjambre Swarm y tablero de tareas
La regla para elegir es simple: si los pasos de la tarea caben en una nota adhesiva, usa /run-workflow en los planes Google AI Pro o Google AI Ultra. En cambio, cuando el resultado final es abierto y los agentes necesitan debatir, probar y reaccionar a errores sobre la marcha, entra /swarm en los planes de pago.
En el enjambre los roles se reparten como en un equipo real: el planificador divide el objetivo en piezas, dos constructores editan código en paralelo, el tester corre verificaciones y un subagente de navegador abre el sitio, hace clic en formularios y detecta errores de consola. La coordinación ocurre en el tablero compartido Swarm Board: se abre con /swarm board o con el atajo Alt+S y dibuja un grafo vivo de dependencias. Además, los agentes dormidos en estado waiting no consumen tokens. En pruebas con Gemini 4, el enjambre ya armó una escena de la Torre Eiffel en Three.js y reconstruyó una oficina con unos 906,000 triángulos.
Agentes locales con Gemma 4 sin nube y sus límites reales
Cuando en tu trabajo aparecen correos de clientes o tablas financieras, enviar datos a la nube no es una opción. El SDK ahora incluye soporte integrado para los modelos abiertos Gemma 4 sin internet ni claves de API.
En equipos con 24 GB de memoria o más se puede ejecutar la versión de 26 mil millones de parámetros de Gemma 4 mediante el motor LiteRT. En una laptop común de 16 GB de RAM, la versión compacta de Gemma 4 corre con Ollama, LM Studio o vLLM. En el ejemplo con agentes sin conexión, una laptop así ordenaba el correo cada 10 minutos sin permiso para borrar archivos, preparaba borradores de respuesta, organizaba notas y generaba un panel HTML a partir de una exportación de Search Console de 30 filas. En modo híbrido, la nube solo arma el plan usando los nombres de archivo mientras el 97.2% de los tokens se procesa en local.
Puedes conectar el modelo local a un script en cuatro líneas mediante Ollama:
# Ejecución del modelo local Gemma 4 mediante el SDK sin acceder a la nube
from antigravity_sdk import LocalModelClient

client = LocalModelClient(provider="ollama", model="gemma-4:9b")
result = client.generate("Analyze internal financial spreadsheet without leaking data.")
print(result.text)
Aquí LocalModelClient conecta el script con el servidor local ollama y los pesos gemma-4:9b, mientras generate procesa la solicitud directamente en tu hardware y devuelve el texto en result.text. A un agente así se le pueden conectar funciones propias en Python y servidores MCP manteniendo los archivos privados en el disco.
La autonomía local también tiene su contracara. Con 16 GB de RAM, la ventana de contexto útil se reduce a 16–32 mil tokens, aunque Google recomienda subir el límite en Ollama a 64,000 tokens si hay memoria suficiente para evitar que una ejecución larga se corte a la mitad. Los modelos locales pequeños son más lentos que los insignia en la nube y más sensibles a prompts imprecisos, por lo que conviene darles una carpeta acotada y un objetivo claro. Por último, las ramas aisladas branch en el enjambre consumen gigabytes de SSD en copias del repositorio, y una instrucción ambigua puede generar ramificaciones innecesarias en el script, así que igual tendrás que revisar el código en la etapa de aprobación.