Métrica MTSS en Kubernetes: por qué el autoescalador reacciona tarde y cómo medir el fallo real para los usuarios
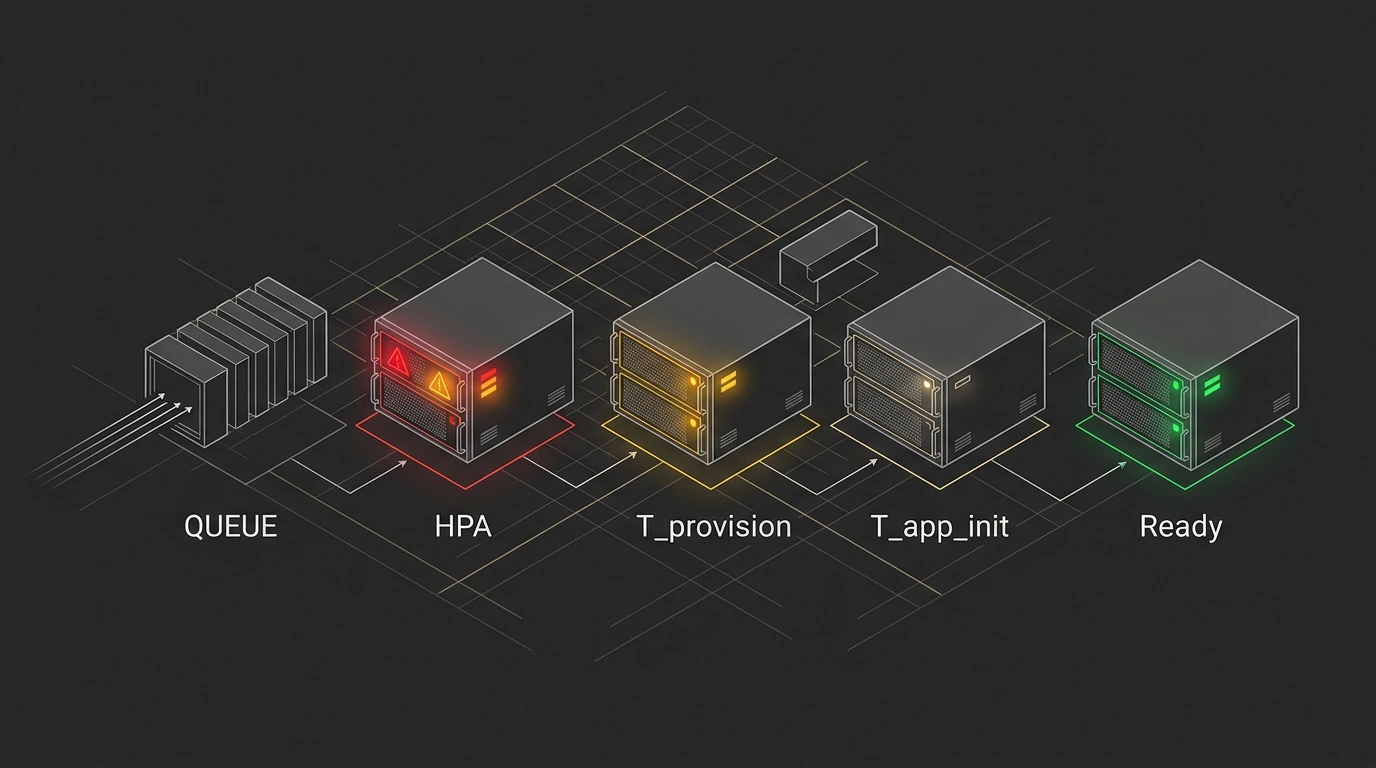
Ves en el reporte de Kubernetes que los nuevos pods ya están asignados a un nodo y piensas que el pico de carga quedó atrás. Pero el contador karpenter_pods_unbound_time_seconds solo registra la entrega de hardware en la nube, mientras tus clientes chocan contra errores 503 y 504 durante el arranque en frío.
David Morrison, de Applied Computing, propuso la métrica MTSS: el tiempo de extremo a extremo desde la caída del SLO hasta que pasa el readiness probe. Mientras el nodo tarda 5 minutos en aplicar parches del SO y el servicio Java calienta la caché, ni siquiera los disparadores de KEDA bastan por sí solos: ante un pico de tráfico, de poco sirve levantar la puerta de entrada si detrás espera una cadena de servicios dependientes.