Tarde o temprano, todo ingeniero de backend choca contra el mismo muro fundamental: la velocidad de confirmación (commit) de transacciones en la base de datos. Tu aplicación puede estar escrita en un lenguaje compilado ultrarrápido, tu código puede no hacer ni una asignación de memoria innecesaria y tu pila de red puede volar con eBPF. Pero en cuanto el cliente envía el comando COMMIT, el programa tiene que frenar en seco y esperar a que los bytes queden físicamente grabados en el almacenamiento no volátil.
De esa garantía de durabilidad (la letra D de las siglas ACID) responde el clásico registro de escritura anticipada: el Write-Ahead Log, o WAL. Y casi siempre, por debajo se invoca la vieja conocida llamada al sistema fsync(2).
Sin embargo, en la era de los servidores en la nube, esa llamada se convierte en una tortura. Si en un disco NVMe local vaciar la caché lleva microsegundos, en un volumen de bloques en red como AWS EBS gp3 la latencia de cada viaje al disco sube hasta 1 milisegundo. Imagina ahora que tu base procesa un flujo secuencial de transacciones pequeñas: mil commits por segundo se vuelven un techo infranqueable simplemente por la latencia de red de la controladora de disco.
Justo con este dilema se toparon los ingenieros del SGBD relacional versionado Dolt, liderados por Aaron Son. Decidieron optimizar el registro, pero la primera solución evidente acabó siendo una lección magistral sobre cómo funcionan los sistemas de archivos en Linux.
La trampa de la optimización ingenua: fsync frente a fdatasync
Si abres la documentación del kernel de Linux sobre llamadas al sistema, la diferencia entre fsync(2) y fdatasync(2) parece cristalina:
fsyncvuelca al disco tanto las páginas de datos modificadas como todos los metadatos del archivo: fecha de modificación (mtime), permisos, tamaño y mapa de bloques en disco (extents).fdatasyncpromete volcar únicamente las páginas de datos, ignorando los atributos auxiliares del archivo siempre que no hagan falta para poder leerlo después correctamente.
Parece la receta mágica para acelerar al instante. Al fin y al cabo, a la base de datos le dan igual los metadatos del log (como la última fecha de modificación mtime) durante un commit: si el servidor se reinicia por un fallo, el parser del WAL se guía por las cabeceras internas de los registros y las sumas de control CRC, no por las marcas de tiempo del sistema de archivos.
Los ingenieros de Dolt fueron y cambiaron fsync por fdatasync en la ruta de escritura de cada commit. Lanzaron los benchmarks y... no vieron absolutamente ninguna diferencia. La latencia de las transacciones secuenciales seguía igual de alta.
¿Qué estaba pasando? Para entender el fallo, hay que bajar al nivel del estándar POSIX y de los drivers de sistemas de archivos. Según la especificación POSIX, fdatasync debe garantizar que los datos puedan leerse tras un corte de luz. Y ahora recuerda cómo se escribe normalmente un log: la base de datos abre el archivo en modo de adición y hace append, añadiendo los nuevos bytes justo al final.
¡En cada append, el tamaño del archivo (st_size) crece! Y el tamaño del archivo es un atributo crítico de metadatos. Si el sistema de archivos no fija el nuevo tamaño en la estructura inode, tras un reinicio el sistema operativo pensará que el fragmento añadido está más allá del final del archivo y devolverá EOF. Como resultado, el kernel de Linux se ve obligado a lanzar exactamente el mismo procedimiento pesado de volcado de metadatos que con un fsync normal.
Anatomía de los viajes al disco en Ext4
Echemos un vistazo bajo el capó de Ext4, el sistema de archivos más extendido en servidores Linux.
Cuando un proceso escribe al final de un archivo y pide un volcado a disco, el driver de Ext4 junto con su subsistema de registro JBD2 (Journaling Block Device) ejecuta tres operaciones secuenciales contra el dispositivo de bloques:
- Escritura de datos: las páginas modificadas en RAM se envían al disco.
- Escritura de metadatos en el journal: el driver bloquea las estructuras del archivo y graba el tamaño actualizado y los nuevos extents en el búfer circular del journal de Ext4.
- Commit de la transacción del journal: se envía al disco una barrera de vaciado por hardware (flush barrier) para garantizar que los metadatos han quedado fijados.
En un disco en red EBS, cada uno de estos pasos es un viaje de ida y vuelta por red de 1 milisegundo. En total, ¡un simple commit de transacción le cuesta a la aplicación un mínimo de 3 milisegundos de latencia!
En XFS la situación es algo más benévola: XFS sabe combinar la escritura de metadatos y el commit, haciendo dos viajes en lugar de tres. Pero dos viajes siguen siendo el doble de lentos que enviar únicamente los datos útiles.
Por qué fallaron fallocate y ftruncate
Cabría pensar: si el problema es que cambia el tamaño del archivo, ¡reservemos espacio por adelantado! Por ejemplo, llamamos a fallocate(2) o ftruncate(2) reservando 100 megabytes de golpe. Así el archivo ya será grande y las escrituras siguientes no cambiarán su tamaño, ¿no?
El equipo de Dolt probó también esa hipótesis. El resultado volvió a ser decepcionante: no hubo mejora alguna.
El motivo está en un mecanismo de seguridad del kernel de Linux. Cuando llamas a fallocate, el sistema de archivos asigna bloques en disco, pero los marca como extents no inicializados (unwritten extents). Esto se hace a propósito para evitar que un programa pueda leer por accidente datos residuales de otro usuario en el disco antes de haber escrito algo propio allí.
Cuando la aplicación escribe por primera vez bytes reales en un bloque no inicializado, el kernel de Linux intercepta la operación y actualiza el árbol de extents en el inode, pasando el bloque del estado «no inicializado» a «válido». Y eso vuelve a ser una modificación de metadatos que exige bloquear el journal de Ext4 y mandar otra barrera al disco.
La solución contraintuitiva: rellenar con ceros por adelantado
La única forma de lograr que el sistema de archivos considere los bloques completamente inicializados es escribir datos físicamente en ellos.
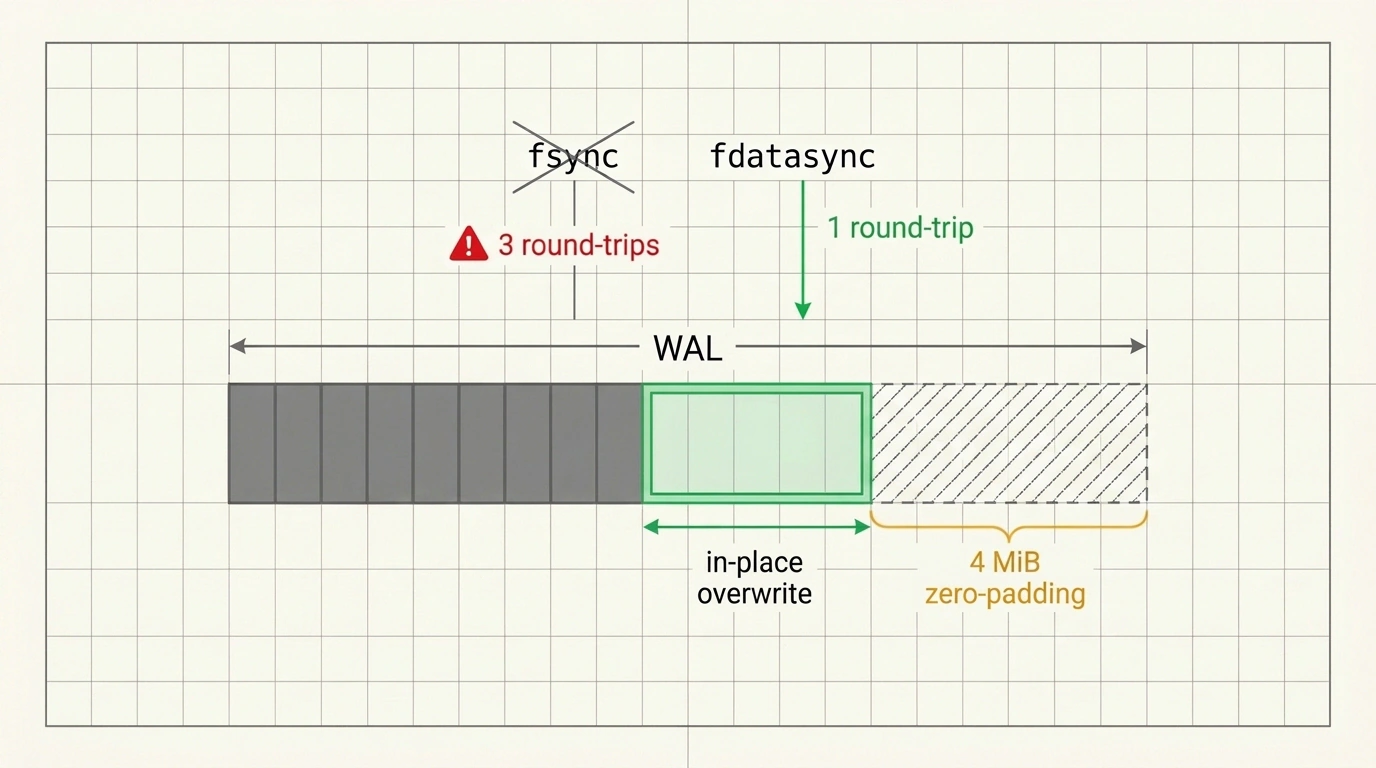
Esquema isométrico del prellenado con ceros del búfer WAL y volcado instantáneo mediante fdatasync.
El equipo de Dolt aplicó un diseño de ingeniería muy elegante:
- La base de datos mantiene un búfer de 4 MiB relleno de ceros (
zero-padding). - Cuando el puntero de escritura se acerca al límite del espacio ya preparado, el proceso realiza una llamada normal
write(2)añadiendo 4 MiB de ceros al final del archivo. - Como los ceros se graban físicamente en el almacenamiento, el sistema de archivos crea extents completos e inicializados.
- Todas las miles de transacciones pequeñas que llegan dentro de esa ventana de 4 megabytes dejan de ser una ampliación del archivo (
append) y pasan a ser sobrescritura de sectores ya existentes (in-place overwrite).
Al sobrescribir un bloque ya asignado, el tamaño del archivo no cambia, la estructura de extents permanece intacta y la llamada fdatasync empieza por fin a funcionar como prometía: vuelca solo los datos modificados en exactamente un viaje de red.
Implementación en Go
Así es como queda esta lógica en Go puro usando la llamada directa al sistema syscall.Fdatasync:
package wal

import (
    "os"
    "syscall"
)

// Reservamos un búfer de 4 MiB de ceros para preasignar el archivo
const zeroBlockSize = 4 * 1024 * 1024
var zeroBytes = make([]byte, zeroBlockSize)

type WALWriter struct {
    file          *os.File
    currentOffset int64
    allocatedEnd  int64
}

// WriteCommit fija atómicamente una transacción en el registro de escritura anticipada
func (w *WALWriter) WriteCommit(record []byte) error {
    recordLen := int64(len(record))

    // Si la siguiente transacción alcanza el límite de los bloques inicializados
    if w.currentOffset+recordLen > w.allocatedEnd {
        // Ampliamos el archivo escribiendo físicamente 4 MiB de ceros
        if _, err := w.file.WriteAt(zeroBytes, w.currentOffset); err != nil {
            return err
        }
        w.allocatedEnd = w.currentOffset + zeroBlockSize
    }

    // Sobrescribimos la zona de ceros con los datos reales del commit (in-place overwrite)
    if _, err := w.file.WriteAt(record, w.currentOffset); err != nil {
        return err
    }
    w.currentOffset += recordLen

    // La llamada fdatasync vuelca solo la caché de datos sin bloquear metadatos
    return syscall.Fdatasync(int(w.file.Fd()))
}
Para comprobar el comportamiento del subsistema de entrada/salida resulta muy útil trazar las llamadas al sistema con strace en la terminal:
# Monitoreo en tiempo real de la latencia de las llamadas fdatasync
strace -f -T -e trace=fdatasync,write -p $(pgrep dolt) 2>&1 | grep fdatasync
En la salida de la terminal se aprecia con claridad cómo la latencia de fdatasync cae de 3.2 ms a unos estables 0.9–1.1 ms por commit. En pruebas sintéticas Sysbench OLTP con transacciones cortas secuenciales, el tiempo total de confirmación se redujo entre un 10% y un 40%.
Esta optimización no es magia gratuita. Escribir por adelantado 4 MiB de ceros duplica el volumen físico de datos enviados al disco (la amplificación de escritura o Write Amplification crece aproximadamente al doble). Si tu subsistema de disco ya está saturado al 100% de ancho de banda (MB/s) en un SSD local, el truco de los ceros solo frenará el sistema. Donde realmente brilla es en almacenamientos en red con alta latencia (RTT) y margen sobrado de ancho de banda.
Además, este truco de sobrescribir sectores pierde sentido en sistemas de archivos Copy-on-Write (como Btrfs u OpenZFS): allí cualquier sobrescritura de bloque se traduce físicamente en escribir un bloque nuevo y actualizar el árbol de metadatos. Pero para despliegues clásicos de servidor en Ext4 y XFS, es una de las formas más ingeniosas y poco obvias de esquivar los cuellos de botella del disco.