Tarde o temprano, todo proyecto con éxito atraviesa una crisis de crecimiento de datos. Tu startup o servicio arrancó en un único servidor sencillo de PostgreSQL o MySQL, la tabla de pedidos o logs de auditoría alojaba sin problemas los primeros cientos de miles de registros y las consultas respondían en un par de milisegundos.
Pero pasan los meses de actividad intensa: la tabla crece hasta los cien millones de filas, el tamaño en disco supera los cientos de gigabytes y los usuarios empiezan a quejarse de que los informes analíticos se quedan colgados. En el comité de arquitectura resuenan inevitablemente dos términos de moda: «¡Hagamos particionamiento!» o «¡Necesitamos sharding ya!».
En los debates técnicos suele meterse ambos conceptos en el mismo saco, como si fueran casi sinónimos. Pero entre ellos existe una frontera fundamental: la frontera del hierro físico. Tomar la decisión equivocada en este punto puede o bien enterrar el rendimiento de la base de datos, o bien condenar al equipo a meses de una reestructuración tan compleja como innecesaria.
Desmontemos esta encrucijada desde la base y tracemos con claridad dónde pasa la línea divisoria entre el particionamiento y el sharding.
La frontera física: un servidor frente a un clúster
La diferencia principal no está en la sintaxis SQL, sino en cómo se reparten los recursos físicos de hardware: procesador (CPU), memoria RAM y subsistema de disco:
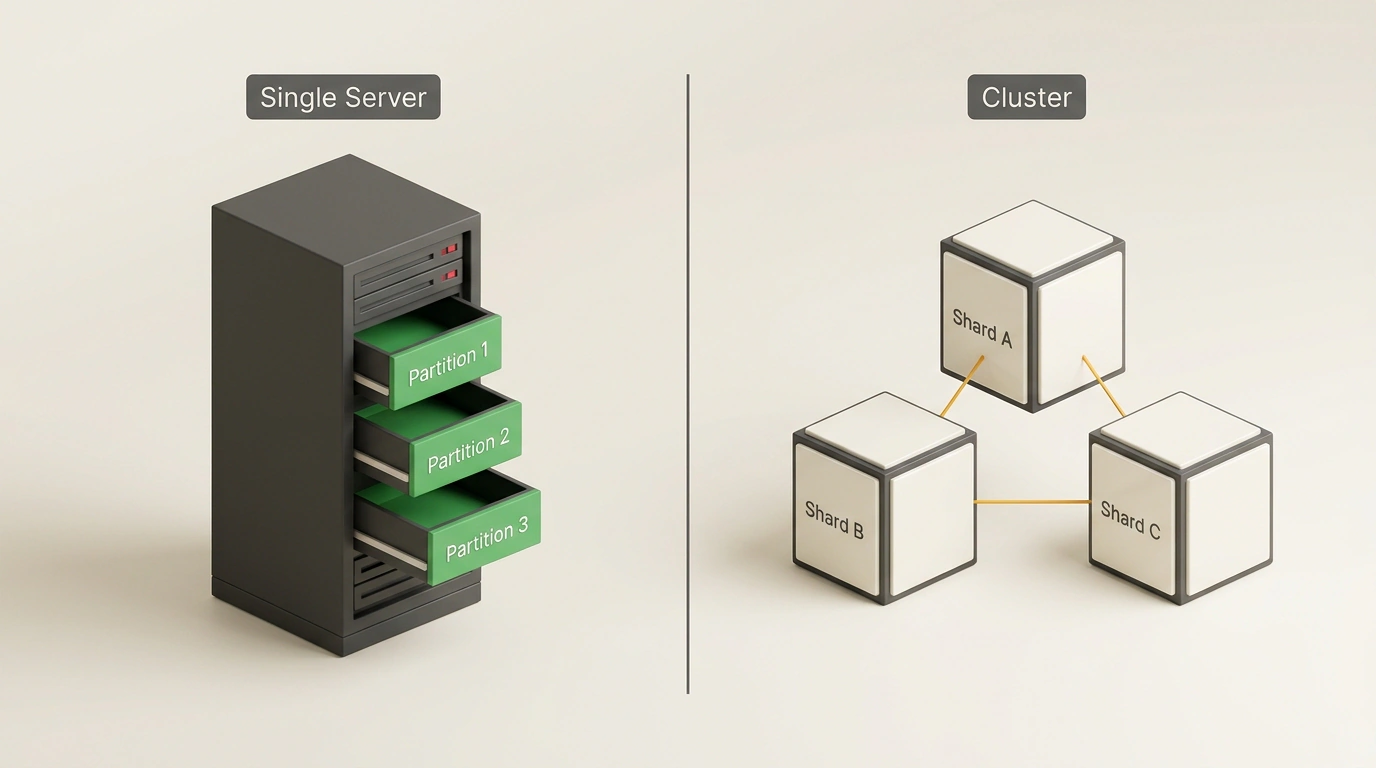
Comparativa arquitectónica de secciones de una tabla en un solo servidor con particionamiento frente a servidores independientes con sharding.
- El particionamiento (Partitioning o seccionamiento) consiste en dividir una tabla lógica en varias subtablas físicas (particiones) dentro de una única instancia de SGBD en un solo servidor. Todas las particiones comparten el mismo espacio de memoria y compiten por los mismos núcleos de CPU y los mismos discos.
- El sharding consiste en distribuir un conjunto de datos entre varios servidores físicos independientes (nodos de un clúster). Cada shard es una base de datos autónoma con su propia memoria, sus discos y su sistema operativo (arquitectura Shared-Nothing).
Nota la diferencia: el particionamiento ayuda al sistema operativo y al planificador del SGBD a trabajar con más soltura sobre archivos locales en un único host, mientras que el sharding escala el sistema más allá de los límites físicos de una sola máquina.
Particionamiento: los tres grandes problemas que resuelve
¿Por qué es tan popular el particionamiento si todos los datos siguen viviendo en el mismo servidor? Porque ataca de lleno los tres dolores principales de las bases de datos monolíticas en crecimiento:
1. Salvar la memoria RAM del desbordamiento de índices
Mientras la tabla cabe en RAM, buscar por un índice B-Tree lleva nanosegundos. Pero cuando el tamaño del índice supera la memoria disponible del servidor, empieza la degradación: para encontrar cada registro, el SGBD tiene que expulsar páginas calientes de la caché y acudir al disco lento. Si partes la tabla en particiones mensuales, el conjunto activo de trabajo (el mes en curso) se reduce drásticamente. El índice del mes actual vive cómodamente en RAM y la entrada/salida de disco cae casi a cero.
2. El mecanismo de Partition Pruning (poda de particiones)
Cuando ejecutas una consulta filtrando por la clave de particionamiento (por ejemplo, un rango de fechas), el planificador del SGBD descarta en la fase de planificación todas las particiones irrelevantes. ¡La base ni siquiera abre físicamente los archivos de los demás meses!
3. Limpieza instantánea de datos antiguos sin VACUUM
Este es el gran secreto de operación en bases de datos de alta carga. Imagina que necesitas borrar de la tabla de pedidos los datos de hace dos años. Si lanzas DELETE FROM orders WHERE order_date < '2024-01-01';, la base quedará bloqueada durante horas: irá marcando fila a fila millones de registros como muertos, generará gigabytes de logs WAL, bloqueará tablas y provocará una fragmentación brutal (bloat), tras lo cual VACUUM tardará un día entero en intentar devolver ese espacio al sistema operativo.
Con particionamiento, borrar un mes entero se hace con un comando DDL instantáneo: DROP TABLE orders_2024_01;. La base simplemente elimina el archivo del disco a nivel de sistema de archivos en un par de milisegundos, sin generar ni una línea de WAL y sin pasar por el recolector de basura.
Práctica: configurando particionamiento en PostgreSQL
Veamos cómo luce el particionamiento declarativo en el PostgreSQL moderno:
-- Creamos la tabla maestra con particionamiento declarativo por rango de fechas
CREATE TABLE orders (
    order_id bigint NOT NULL,
    customer_id bigint NOT NULL,
    order_date date NOT NULL,
    total_amount numeric(12, 2) NOT NULL,
    status text NOT NULL,
    -- Requisito importante: la columna clave de particionamiento debe formar parte de la clave primaria
    PRIMARY KEY (order_id, order_date)
) PARTITION BY RANGE (order_date);

-- Creamos las particiones físicas para meses concretos
CREATE TABLE orders_2026_10 PARTITION OF orders
    FOR VALUES FROM ('2026-10-01') TO ('2026-11-01');

CREATE TABLE orders_2026_11 PARTITION OF orders
    FOR VALUES FROM ('2026-11-01') TO ('2026-12-01');

-- Los índices locales se crean en cada partición automáticamente o de forma individual
CREATE INDEX idx_orders_2026_10_customer ON orders_2026_10 (customer_id);
Comprobemos ahora cómo actúa la poda de particiones mediante EXPLAIN:
EXPLAIN SELECT * FROM orders
WHERE order_date >= '2026-10-15' AND order_date <= '2026-10-20';

-- Resultado en la salida de EXPLAIN:
-- Seq Scan on orders_2026_10 orders (cost=0.00..25.40 rows=12 width=48)
--   Filter: ((order_date >= '2026-10-15'::date) AND (order_date <= '2026-10-20'::date))
-- Fíjate: ¡el planificador ni siquiera mencionó la partición orders_2026_11!
Cuando el particionamiento se queda corto: llega el sharding
El particionamiento hace maravillas, pero tiene un techo físico infranqueable. Tarde o temprano llega el momento en que la potencia de un solo servidor se agota:
- Cuello de botella en escritura (Write Bottleneck): la replicación con réplicas de lectura (Read Replicas) escala fácilmente las consultas de lectura, pero todas las operaciones de escritura (
INSERT,UPDATE) deben pasar por un único servidor maestro. Si el flujo entrante de transacciones agota los IOPS máximos del array de discos o el ancho de banda del bus del procesador, una sola máquina ya no da abasto. - Volumen físico de discos: el volumen de datos supera decenas de terabytes y ya no cabe de forma razonable en las bahías de disco de un solo servidor.
Ahí es cuando entra en escena el sharding. Troceas los datos según una clave (por ejemplo, el hash de user_id) y los repartes entre diez servidores independientes. Cada nodo escribe únicamente su décima parte.
El sharding resuelve el escalado de escritura, pero cobra un peaje altísimo en complejidad:
- Pérdida de integridad: ya no puedes declarar un
FOREIGN KEYnativo entre tablas alojadas en shards distintos. - Transacciones distribuidas: transferir dinero de forma atómica entre usuarios de shards diferentes exige un commit en dos fases (2PC), que resulta desesperadamente lento y suele fallar ante microcortes de red.
- Necesidad de un coordinador: la aplicación requiere una capa intermedia (como Citus o Vitess) que sepa exactamente a qué servidor enrutar cada consulta entrante.
La regla de oro para elegir: de lo simple a lo complejo
Antes de lanzarte a implementar sharding y pasar meses reescribiendo la lógica de negocio:
- Exprime al máximo los índices, la optimización de consultas y el escalado vertical (un servidor moderno con 128 núcleos y un terabyte de RAM cuesta mucho menos que el salario del equipo necesario para mantener un clúster shardeado).
- Configura particionamiento en tus tablas más grandes por fecha o estado. Eso resolverá el 90% de los problemas de entrada/salida en disco y mantenimiento de caché.
- Y solo cuando el flujo de escrituras choque contra el techo físico de un único servidor potente, da el salto al sharding.
Además, en los sistemas maduros de alta carga ambos enfoques conviven de forma natural: las tablas dentro de cada shard individual también se particionan por meses.