Si alguna vez has intentado resolver bugs reales de producción con redes neuronales abiertas, conoces de sobra la cruda realidad: los modelos locales escribían scripts sencillos en Python con mucha soltura, pero en cuanto los enfrentabas a un repositorio con decenas de archivos y una arquitectura enrevesada, levantaban la bandera blanca al instante. El prestigioso benchmark de programación real SWE-bench Verified fue durante mucho tiempo un coto cerrado para los grandes: superar el listón del 80% estaba reservado exclusivamente a redes propietarias (Claude 3.5 Sonnet, OpenAI o1, GPT-4o), lo que obligaba a las empresas a enviar su código fuente a nubes ajenas.
El lanzamiento de Ornith 1.5-122B bajo licencia libre MIT ha cambiado las reglas del juego. Su arquitectura de mezcla dispersa de expertos (Sparse MoE) no solo ha igualado a los líderes con un récord del 84.5% en SWE-bench Verified, sino que lo ha hecho pensada para ejecutarse en un único acelerador gráfico.
Por dentro: arquitectura MoE y bucle de autoaprendizaje
Los creadores de Ornith aplicaron una receta que sortea los límites de las redes «densas» (dense) tradicionales:
- Mezcla de expertos (Mixture of Experts): el volumen nominal del modelo es de 122 mil millones de parámetros (~125B). Sin embargo, gracias a la activación dispersa, para procesar cada token individual solo se activa un subconjunto especializado de pesos. Así se conserva la enorme erudición del modelo sin exigir una potencia de cálculo monstruosa en cada paso de generación.
- Contexto gigante: la ventana de contexto se amplía hasta los 262,000 tokens (262K). En esa memoria cabe sin problema el núcleo de un servicio web mediano con todos sus módulos auxiliares y tests.
- Bucle autónomo de autoaprendizaje (Self-Training Loop): el modelo no aprendió a programar leyendo manuales. En un ciclo cerrado, la propia red generaba problemas de código de distinta complejidad, montaba la estructura de pruebas automáticas (test scaffolding), producía decenas de intentos de solución (rollouts), los ejecutaba y actualizaba sus pesos mediante aprendizaje por refuerzo (RL) según el resultado de los tests.
Las cifras en mediciones independientes confirman su madurez:
- SWE-bench Verified: 84.5%;
- SWE-bench Pro (no-hack): 76.9% (para comparar: la media de los modelos abiertos de la generación anterior rondaba el 44%);
- TerminalBench 2.1: 81.2% en escenarios complejos de consola.
Despliegue práctico: levantando el servidor en una sola GPU
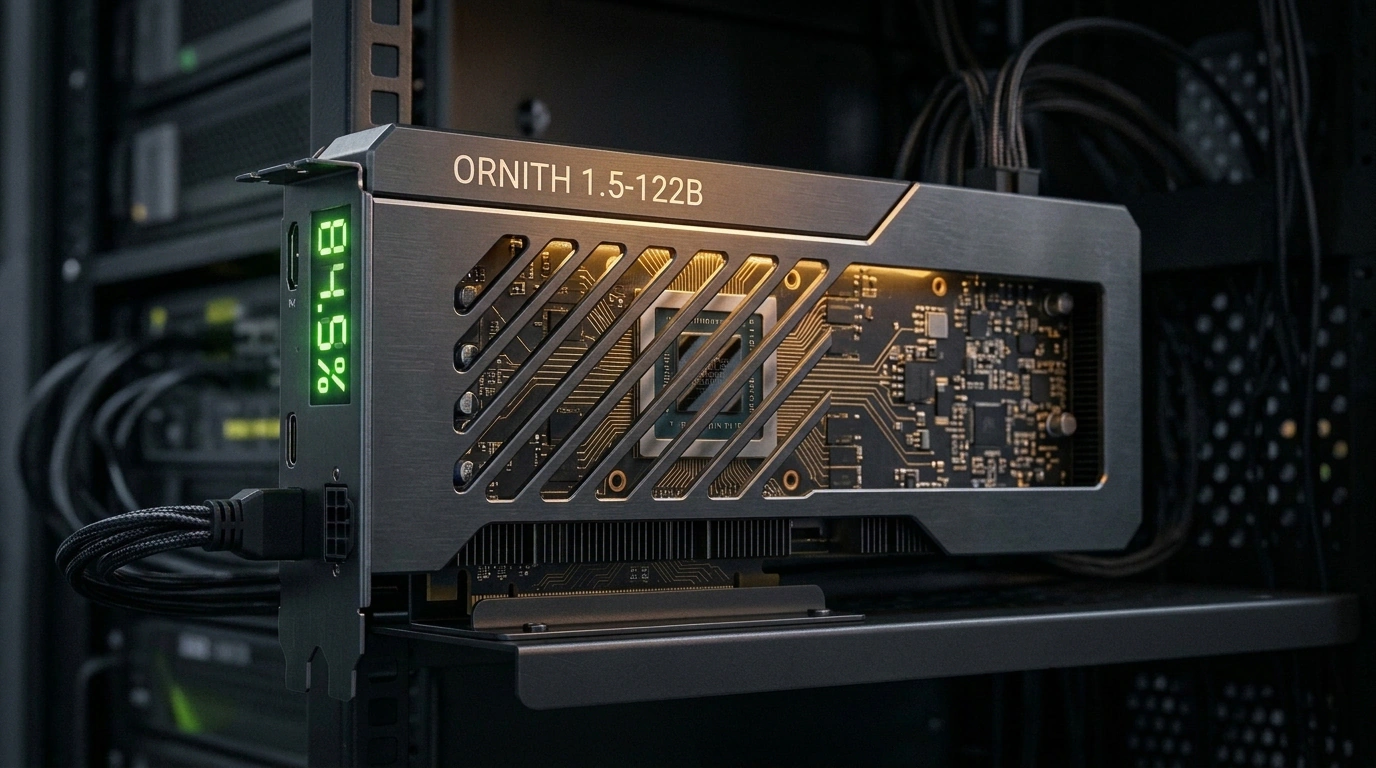
En precisión original (FP16/BF16), mover 122B parámetros sigue requiriendo un nodo de servidor con 4 tarjetas tipo A100. Pero la gran baza de ingeniería de Ornith 1.5 aparece con la cuantización de 4 bits (AWQ): el modelo cabe cómodamente en la memoria de una única GPU profesional con 48 GB de VRAM (por ejemplo, una NVIDIA RTX 6000 Ada) o una H100 (80 GB).
Infografía de ingeniería sobre la compresión del modelo abierto de 122B: transformación de pesos desde un clúster de servidores a una sola GPU de 48 GB mediante cuantización AWQ.
Así se arranca un servidor compatible con OpenAI usando el motor vLLM:
# Arranque del servidor de inferencia Ornith 1.5 con cuantización AWQ en una sola GPU
python3 -m vllm.entrypoints.openai.api_server \
    --model ornith/ornith-1.5-122b-awq \
    --tensor-parallel-size 1 \
    --gpu-memory-utilization 0.95 \
    --max-model-len 131072 \
    --trust-remote-code \
    --port 8000
Una vez levantado el servidor, puedes conectarlo a cualquier cliente agéntico (Cursor, OpenCode o un script en Python) como un endpoint estándar:
from openai import OpenAI

# Conexión al servidor local de inferencia
client = OpenAI(base_url="http://localhost:8000/v1", api_key="local-token")

prompt = """Fix the regression in django/db/models/sql/query.py:
The clone() method incorrectly shares internal join aliases when subqueries are chained.
Return minimal unified diff format only."""

response = client.chat.completions.create(
    model="ornith-1.5-122b-awq",
    messages=[
        {"role": "system", "content": "You are Ornith 1.5, an expert software engineering model. Produce production-ready diff patches."},
        {"role": "user", "content": prompt}
    ],
    temperature=0.0,
    max_tokens=4096
)

print(response.choices[0].message.content)
Con cuantización de 4 bits puede apreciarse una ligera pérdida de precisión en dialectos SQL poco comunes o lenguajes minoritarios como Haskell. En stacks mayoritarios (Python, TypeScript, Go, Rust), la calidad al generar diffs se mantiene a la altura de las grandes redes en la nube.
En la línea de la evolución de los entornos de terminal que comentábamos en el repaso al ecosistema OpenCode 2.0, la llegada de Ornith 1.5 supone un auténtico cambio tectónico. Las empresas ya no están obligadas a pagar por cada token a nubes propietarias: un agente de programación de nivel industrial ya cabe sin problemas dentro de un perímetro de servidores cerrado.