Cuando en primavera y verano los principales proveedores de redes neuronales empezaron a anunciar uno tras otro recortes drásticos en el precio de procesar prompts largos, cundió cierto desconcierto en la industria. Quienes más llamaron la atención fueron los desarrolladores chinos de DeepSeek: el coste de los tokens de entrada en llamadas repetidas cayó hasta unas simbólicas tres a seis milésimas de dólar por millón ($0.003–0.006 por 1M de tokens).
En los corrillos del sector nació enseguida la teoría de la conspiración: que si estábamos ante un dumping agresivo clásico financiado con subsidios estatales para desplazar a los monopolios cloud occidentales. Sin embargo, cualquier ingeniero de sistemas o especialista en arquitecturas de alta carga esboza una sonrisa al mirar los números. Aquí no hay magia ni subvenciones políticas: es pura física implacable de la computación en chips de silicio y el triunfo de la optimización algorítmica del Key-Value cache.
Asomémonos al interior de la tarjeta gráfica y desmontemos pieza a pieza por qué el tamaño del contexto ahogaba durante años a los servidores de IA y cómo la compresión de la caché dio la vuelta a la economía del sector.
Las dos fases de la inferencia y el cuello de botella de la memoria
Para entender dónde se quema el dinero al invocar un gran modelo de lenguaje, hay que dividir la generación de respuesta de un transformer en dos fases radicalmente distintas:
1. Fase de prellenado (Prefill Phase)
El usuario envía una petición: por ejemplo, un prompt de sistema, documentación de 50,000 palabras y una pregunta. El modelo lee todo ese texto de entrada a la vez y en paralelo. En esta etapa, los núcleos tensoriales de cálculo de la GPU trabajan al 100%: multiplican sin parar matrices de embeddings. Este estado se conoce como Compute-bound: la velocidad de proceso está limitada únicamente por la potencia de cálculo bruto del chip (TFLOPS).
2. Fase de decodificación (Decoding Phase)
Pero después empieza la mecánica autorregresiva. El modelo no puede escupir la respuesta entera de golpe: genera el texto estrictamente token a token en cada paso.
Para calcular las probabilidades de la siguiente palabra, el mecanismo de atención (Self-Attention) debe cruzar el vector de consulta actual (Query) con los vectores de clave (Key) y valor (Value) de absolutamente todos los tokens anteriores que ya están en el contexto.
Si la tarjeta gráfica tuviera que recalcular los vectores Key y Value de todo el texto desde cero en cada paso, responder a un diálogo largo llevaría minutos. Por eso, los ingenieros guardan en caché las proyecciones ya calculadas dentro de la memoria de la GPU. A ese bloque se le llama KV-cache (Key-Value Cache).
Y es justo aquí donde el modelo choca contra un muro físico: el Memory Bandwidth Bottleneck (cuello de botella del ancho de banda de memoria).
Imagina la escena: los núcleos de cálculo de la GPU solo necesitan hacer unas pocas operaciones aritméticas para sacar una letra o una palabra. Pero para ejecutar esa operación, la tarjeta tiene que mover por su bus interno HBM (High Bandwidth Memory) todo el gigantesco bloque acumulado del KV-cache. Los núcleos de cálculo se quedan parados esperando a que el controlador de memoria traiga gigabytes de datos desde la VRAM. La velocidad de generación (tokens por segundo) deja de depender de los teraflops y pasa a depender exclusivamente del ancho del bus de memoria.
El salto de DeepSeek Flash: compresión hasta 890 bytes
Hasta hace poco, el tamaño del KV-cache crecía a un ritmo alarmante. En la arquitectura clásica Multi-Head Attention (MHA), cada token exigía guardar cientos de parámetros por cada cabeza de atención en cada capa de la red neuronal.
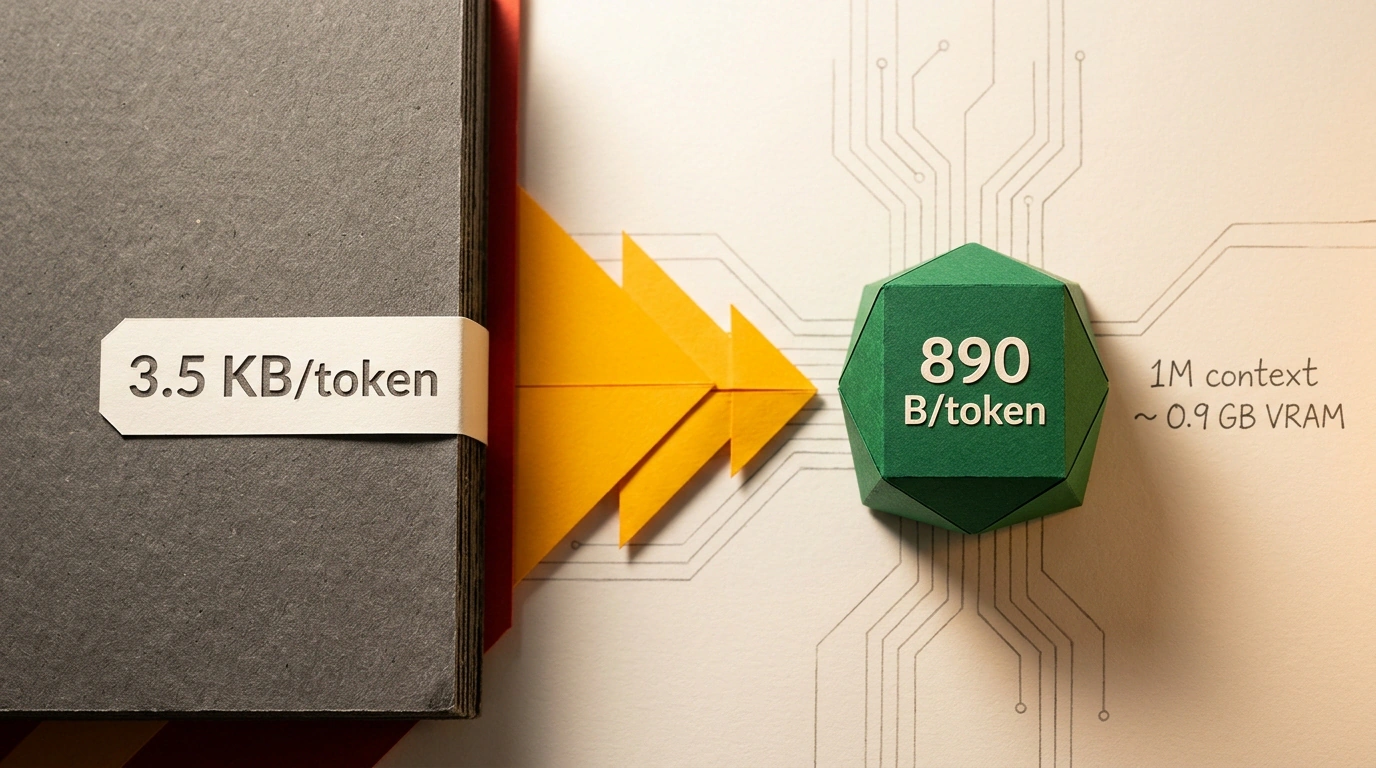
Esquema infográfico de la compresión cuádruple del KV-cache hasta 890 bytes por token con el algoritmo Multi-Head Latent Attention.
En versiones tempranas como DeepSeek-V1, un solo token de contexto «pesaba» una barbaridad en la memoria del acelerador. En la versión V4-Flash lograron compactarlo hasta ~3.5 kilobytes por token. Pero incluso así, un diálogo de un millón de tokens (ventana de 1M) exigía 3.5 gigabytes de VRAM solo para sostener la caché de una única sesión de usuario. ¿Y si tienes cien usuarios conectados a la vez en el servidor? No hay Nvidia H100 ni H200 que aguante.
En la arquitectura DeepSeek Flash V4.1, los ingenieros aplicaron el método de atención latente multicabeza —Multi-Head Latent Attention (MLA)— combinado con una cuantización agresiva en FP8. En lugar de almacenar los vectores completos de claves y valores, el algoritmo los comprime en un espacio latente de bajo rango (Low-rank Compression) y los proyecta de nuevo a tamaño completo justo antes de calcular el producto escalar.
El resultado fue espectacular: lograron comprimir el tamaño del KV-cache hasta unos históricos 890 bytes por token. Eso es 4 veces menos que en V4-Flash, y cientos de veces más compacto que en las arquitecturas clásicas.
Con semejante compresión, ¡un contexto completo de 1,000,000 de tokens ocupa apenas unos 0.9 GB de memoria de vídeo! Ya analizamos en detalle las optimizaciones hermanas del stack abierto de inferencia cuando desmenuzamos el modelo DeepSeek V4.1 Flash y el motor DeepInfer, y ahora este giro arquitectónico se ha convertido en el estándar industrial de servicio.
La economía de los agentes: por qué el token bajó 50 veces de precio
Crucemos ahora la física del silicio con el modelo de negocio de los proveedores cloud.
En un chatbot tradicional, el usuario hace una pregunta y recibe una respuesta. Pero en la era actual de los agentes autónomos de IA (como Claude Code, Devin o pipelines internos), el patrón de carga es completamente distinto:
- El agente recibe un enorme prompt de sistema con la descripción de decenas de herramientas y la documentación del proyecto (50,000–100,000 tokens).
- El agente da un paso: invoca una herramienta (por ejemplo, lee un archivo).
- En el siguiente paso, el agente envía a la API todo el historial otra vez: el prompt de sistema inicial + el primer paso + la salida de terminal + la nueva pregunta.
Si el proveedor tuviera que recomputar la fase Prefill para esos 100,000 tokens inmutables en cada iteración, operar un agente costaría cientos de dólares por hora.
La tecnología Prompt Caching permite retener el KV-cache ya calculado de ese prefijo invariable directamente en la memoria caliente de las GPUs del clúster. Cuando llega la siguiente petición con el mismo arranque de prompt, la GPU ni siquiera ejecuta la fase Prefill: salta directa a generar la respuesta tirando de esa caché compacta ya lista.
Y como a razón de 890 bytes por token una sola aceleradora Nvidia puede mantener en memoria las cachés de cientos de sesiones agénticas en paralelo sin expulsarlas a disco, el coste real de servir esas peticiones cae prácticamente a cero. El proveedor vende el acierto en caché (cache-hit) a precio de ganga no a pérdidas, sino con un margen comercial excelente.
Límites y reglas arquitectónicas del juego
Para sacar partido real al cacheo de KV en tus propias aplicaciones, conviene respetar las reglas estrictas bajo las que operan los motores modernos de inferencia (vLLM, TensorRT-LLM, SGLang):
- Continuidad del prefijo: el cacheo funciona estrictamente desde el principio del prompt (Prefix Caching). Si metes una variable dinámica (como el milisegundo actual o un ID aleatorio de sesión) en la primera línea del mensaje de sistema, invalidas al instante toda la caché posterior del diálogo. Las instrucciones estáticas de sistema deben ir siempre primero.
- Tiempo de vida de la caché (TTL): los proveedores cloud mantienen las ramas inactivas en VRAM rápida normalmente entre 5 y 10 minutos tras la última petición. Si tu agente hace una pausa mayor, la caché es desalojada por clientes más activos y la siguiente llamada se factura al precio completo de cache-miss.
Comprimir el KV-cache por debajo del kilobyte es una demostración cristalina de cómo entender a fondo la arquitectura del silicio y el álgebra lineal puede dar la vuelta a la economía de toda una industria, poniendo la tecnología punta al alcance de cualquier desarrollador.