Todo ingeniero de backend que haya intentado meter un modelo de lenguaje en un flujo de software estricto conoce de primera mano el gran suplicio de la IA generativa: su imprevisibilidad probabilística. Fijas temperature=0, bloqueas el seed, defines un esquema de respuesta cerrado... y al cabo de cien peticiones el servidor peta con un error de parseo JSON porque el modelo se comió la llave de cierre o soltó texto antes del objeto válido. Peor aún: con el batching dinámico en GPU, exactamente la misma petición devuelve tokens distintos según cuántas peticiones ajenas se estuvieran procesando en la tarjeta en ese mismo milisegundo.
El laboratorio de investigación DeepSeek ha publicado una actualización de calado para su motor de inferencia abierto DeepInfer, pensada para cerrar de una vez por todas estos compromisos fundamentales al alojar modelos por cuenta propia (en especial el veloz DeepSeek V4.1 Flash).
Determinismo sin depender del tamaño del lote
La principal novedad arquitectónica es el modo de independencia matemática respecto al tamaño del lote (Batch-Invariant Inference), que se activa mediante la variable de entorno DEEPINFER_BATCH_INVARIANT=1.
En los motores de inferencia clásicos, las peticiones paralelas se agrupan en lotes dinámicos para aprovechar los núcleos de la GPU. Pero las operaciones en coma flotante (FP16/BF16) no son asociativas: el orden de suma de los vectores en el núcleo de atención cambia según qué peticiones vecinas haya en el lote. DeepInfer ha reescrito sus núcleos CUDA de bajo nivel para que, con un seed fijo, la respuesta del modelo a un prompt dado coincida bit a bit, tanto si el servidor atiende una sola petición como si está al límite bajo cien llamadas simultáneas.
Decodificación gramatical: el modelo es físicamente incapaz de devolver un JSON roto
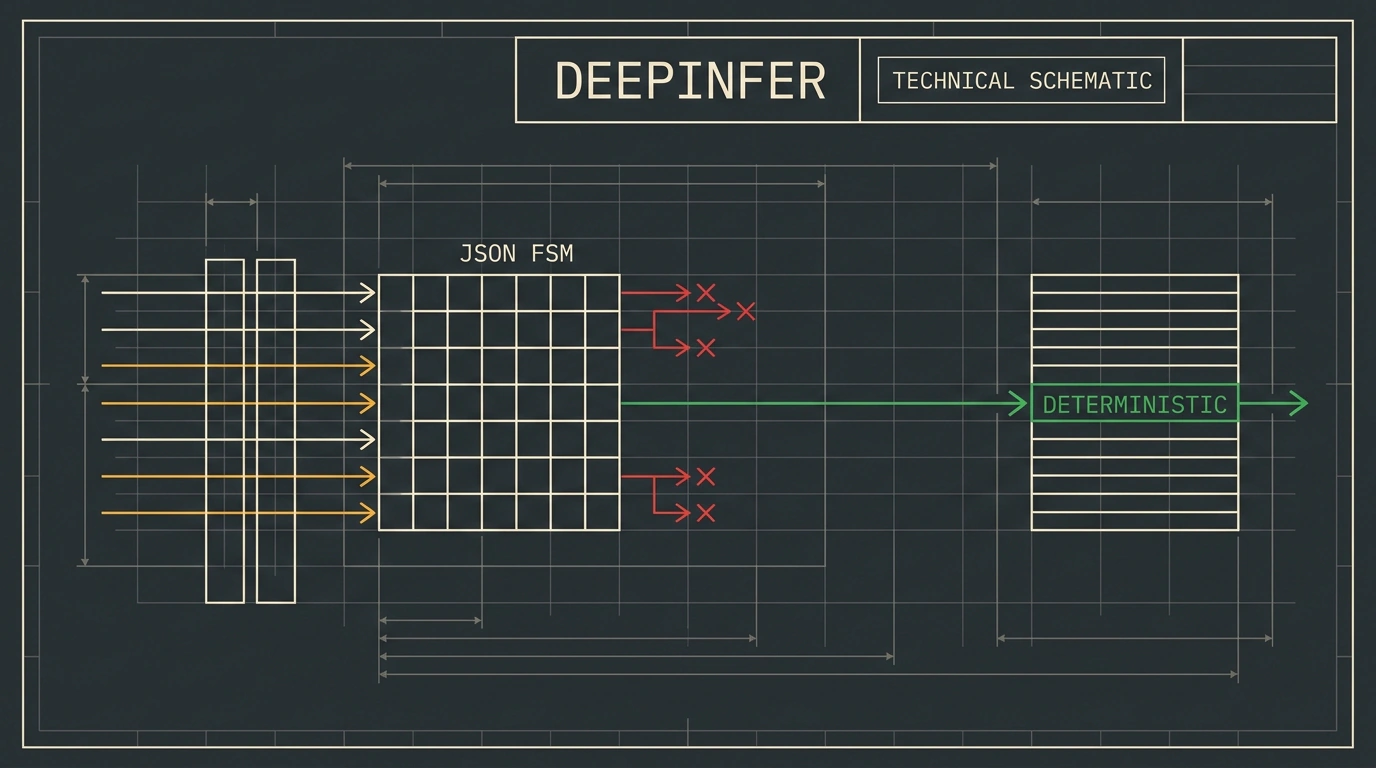
La segunda gran mejora es la decodificación gramatical por hardware (Grammar-Guided Decoding). En lugar de confiar en la buena voluntad del modelo y validar texto en crudo con librerías externas de Python en la CPU, el esquema se compila en una máquina de estados finitos (FSM) directamente en la memoria de la GPU.
Esquema de funcionamiento de la decodificación gramatical FSM: la ruta verde de los tokens JSON válidos frente a la barrera roja de los errores de sintaxis.
En cada paso de predicción del siguiente token, el motor aplica una máscara sobre los logits: los tokens que violen la sintaxis del esquema JSON reciben probabilidad cero. Si el esquema espera un número, al modelo le resulta técnicamente imposible generar una letra o unas comillas.
Así se levanta el servidor DeepInfer con aceleración de gramáticas por hardware y garantía de determinismo:
# Arranque del servidor de inferencia DeepInfer con control de esquemas por hardware
export DEEPINFER_BATCH_INVARIANT=1
export CUDA_VISIBLE_DEVICES=0

python3 -m deepinfer.server \
    --model deepseek-ai/DeepSeek-V4.1-Flash \
    --max-batch-size 64 \
    --grammar-acceleration cuda \
    --port 8080
Y este es un ejemplo de petición cliente en Python donde se envía a la API un esquema JSON estricto para clasificar un ticket entrante de soporte técnico:
import requests

# Definición del esquema esperado para la respuesta estructurada
support_schema = {
    "type": "object",
    "properties": {
        "intent": {"type": "string", "enum": ["billing", "technical", "feature_request"]},
        "priority": {"type": "integer", "minimum": 1, "maximum": 5},
        "order_id": {"type": ["string", "null"]}
    },
    "required": ["intent", "priority", "order_id"]
}

payload = {
    "prompt": "Ticket: No se procesa el pago de renovación del servidor #ORD-7711, ¡ayuda urgente!",
    "temperature": 0.0,
    "seed": 1337,
    "structured_output": {
        "schema_type": "json",
        "schema": support_schema
    }
}

response = requests.post("http://localhost:8080/v1/generate", json=payload)
print(response.json()["text"])
# La salida cumple estrictamente con el esquema:
# {"intent": "billing", "priority": 5, "order_id": "ORD-7711"}
Activar el flag DEEPINFER_BATCH_INVARIANT=1 deshabilita el modo de predicción especulativa de múltiples tokens (Multi-Token Prediction), lo que reduce la velocidad pico de generación entre un 10% y un 15%. Para cadenas agénticas y tests automáticos de integración, la estabilidad de la salida compensa con creces esa ligera pérdida de ritmo.
Además de las gramáticas, el motor incorpora bibliotecas de recetas listas para usar (Recipe Libraries) en tareas habituales: extracción de entidades nombradas (NER), validación de SQL y transformación de documentos. Como ya apuntábamos al analizar la arquitectura de inferencia ultrarrápida de DeepInfer, los motores abiertos están dejando de ser simples envoltorios sobre los pesos para convertirse en infraestructura industrial tolerante a fallos.