Imagina una tarea habitual de cualquier ingeniero de infraestructura o especialista en seguridad cloud. La empresa tiene decenas de microservicios repartidos en tres regiones de AWS, un par de clústeres auxiliares en Google Cloud y un clúster de Kubernetes en producción.
De pronto llega la petición: «Comprobad si por casualidad tenemos algún bucket S3 abierto a todo el mundo, discos EBS sin cifrar o namespaces de Kubernetes donde se olvidaron de activar el aislamiento de red NetworkPolicy».
¿Qué suele hacer un ingeniero en esa situación?
Se sienta a escribir una sábana de código en Python con la librería boto3. Ahí empieza la rutina: recorrer la lista de todas las cuentas, entrar en cada región, lidiar con la paginación de tokens (NextToken), parsear estructuras JSON gigantescas y anidadas, capturar timeouts de red y cruzar a mano esos identificadores con los pods de kubectl get pods -o json. Tras dos días de trabajo tienes un script de 500 líneas que explota en cuanto cambia el formato de respuesta de una API.
El proyecto de código abierto Steampipe, de la empresa Turbot, propone mirar este problema desde un ángulo completamente distinto. Sus autores se hicieron una pregunta sencilla: si las bases de datos relacionales llevan medio siglo resolviendo a la perfección el filtrado, la ordenación y la unión de entidades heterogéneas, ¿por qué no aplicar ese potente aparato matemático a la infraestructura en la nube?
Cómo funciona Steampipe por dentro
Steampipe no es un simple envoltorio sobre comandos CLI. Es un auténtico motor distribuido de consultas SQL contra el mundo real de las APIs.
Su arquitectura se apoya en tres piezas clave:
- Instancia integrada de PostgreSQL: al instalar la herramienta, crea un proceso ligero y aislado de PostgreSQL en tu carpeta personal (
~/.steampipe). No necesitas levantar un servidor de base de datos aparte; todo corre en local de forma autónoma. - Plugins Foreign Data Wrapper (FDW): Steampipe se apoya en el mecanismo oficial de tablas externas de PostgreSQL. Los desarrolladores de plugins en Go definen esquemas de tablas (como
aws_s3_bucket,aws_ec2_instanceokubernetes_pod). - Traducción de predicados al vuelo (Predicate Pushdown): cuando escribes una consulta SQL con una cláusula
WHERE, el planificador de Steampipe no descarga terabytes de datos completos. Traduce las condiciones de filtrado directamente a parámetros de llamada de las APIs remotas. Por ejemplo, si ponesWHERE region = 'eu-central-1', el plugin solo consultará la región de Fráncfort.
Las respuestas JSON que llegan de la nube se mapean al vuelo a filas y columnas de tablas relacionales. Para ti, como desarrollador, la nube empieza a comportarse como una gigantesca base de datos perfectamente estructurada.
La magia de los JOIN entre nubes
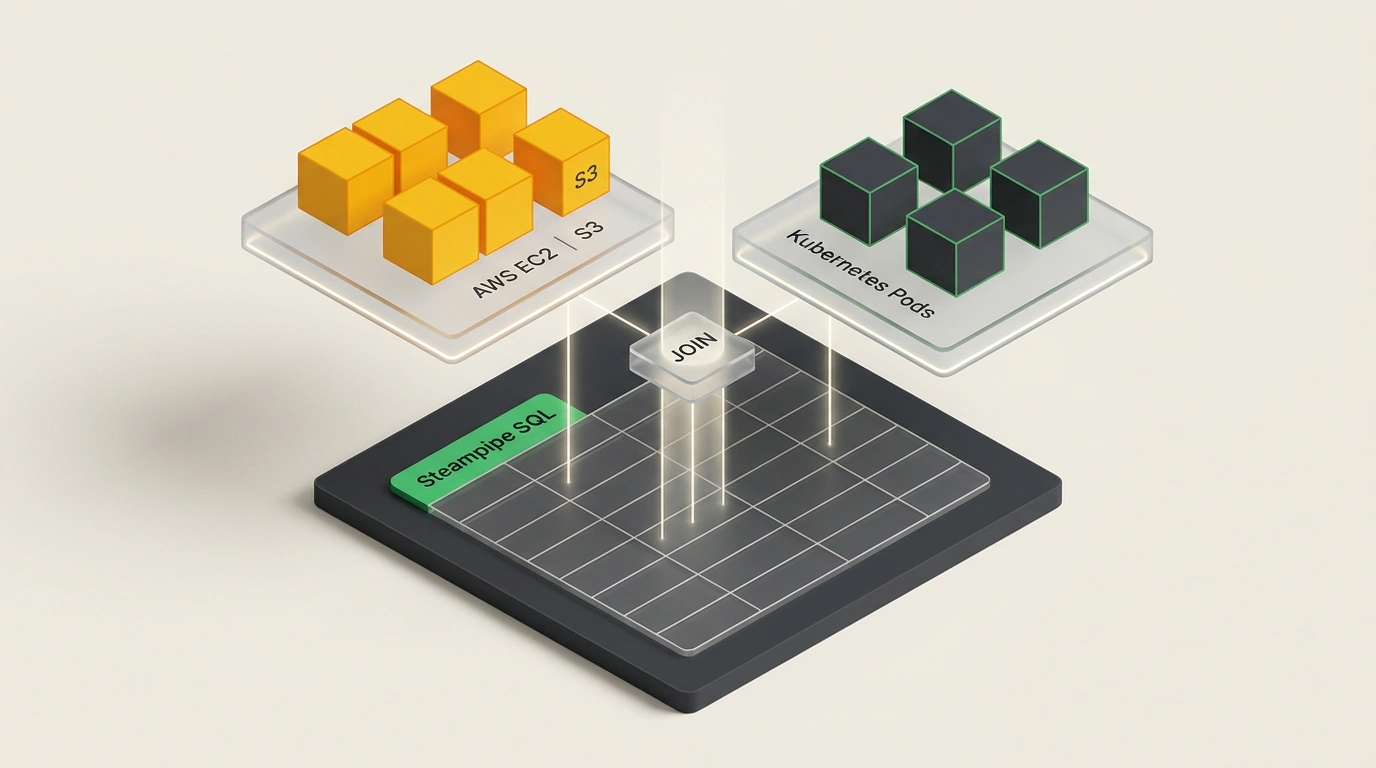
La gran superpotencia del modelo relacional es la operación JOIN. En scripts convencionales, cruzar entidades de plataformas distintas es un engorro tremendo. En Steampipe puedes unir la tabla de pods de Kubernetes con la tabla de instancias AWS EC2 en una sola consulta para ver al instante en qué máquinas virtuales físicas están corriendo los pods con errores críticos:
Esquema infográfico de una consulta SQL JOIN entre tablas de pods de Kubernetes y máquinas virtuales AWS EC2 en Steampipe.
SELECT
  k8s.name AS pod_name,
  k8s.namespace,
  k8s.node_name,
  ec2.instance_id,
  ec2.instance_type,
  ec2.public_ip_address
FROM
  kubernetes_pod AS k8s
JOIN
  aws_ec2_instance AS ec2 ON k8s.node_name = ec2.private_dns_name
WHERE
  k8s.status_phase = 'Pending';
El motor lanza por su cuenta consultas paralelas a la API de Kubernetes y a la API de AWS, cruza los nombres DNS de los nodos y te escupe una tabla resumen impecable en la terminal en cuestión de segundos.
Instalación y primeras consultas prácticas
Desplegar Steampipe lleva menos de dos minutos. Se instala con el script estándar en Linux o mediante Homebrew en macOS:
# Instalación para entornos Linux
sudo /bin/sh -c "$(curl -fsSL https://steampipe.io/install/steampipe.sh)"

# Instalación mediante Homebrew para macOS
brew install turbot/tap/steampipe

# Verificamos que la instalación sea correcta
steampipe -v
Tras instalarlo, añadimos los plugins necesarios desde el catálogo oficial Steampipe Hub. Los plugins reutilizan automáticamente tus credenciales locales habituales (~/.aws/credentials, ~/.kube/config):
steampipe plugin install aws
steampipe plugin install kubernetes
Ahora arrancamos la consola SQL interactiva con steampipe query y resolvemos nuestras tareas de seguridad.
1. Búsqueda de buckets S3 accesibles públicamente
Revisamos todos los buckets de la cuenta que tengan desactivado el bloqueo público:
SELECT
  name,
  region,
  block_public_acls,
  block_public_policy,
  restrict_public_buckets
FROM
  aws_s3_bucket
WHERE
  block_public_policy = false
  OR block_public_acls = false;
Una consulta breve señala al instante los buckets por donde podría producirse una fuga de datos confidenciales de la empresa.
2. Auditoría de aislamiento de namespaces en Kubernetes
Buscamos en el clúster los namespaces donde no exista ninguna regla de filtrado de red NetworkPolicy (lo que deja el tráfico entre pods abierto de par en par):
SELECT
  n.name AS namespace_name
FROM
  kubernetes_namespace AS n
LEFT JOIN
  kubernetes_network_policy AS np ON n.name = np.namespace
WHERE
  np.name IS NULL
  AND n.name NOT IN ('kube-system', 'kube-public', 'kube-node-lease');
Un clásico LEFT JOIN comprobando NULL devuelve al momento la lista de entornos de trabajo desprotegidos.
Escollos: Rate Limiting y throttling de APIs
Al trabajar con Steampipe conviene tener muy presentes los límites de las APIs de los proveedores cloud.
Si lanzas una consulta ingenua como SELECT * FROM aws_ec2_instance en una organización con cientos de cuentas AWS conectadas, la herramienta bombardeará la API del proveedor con cientos de llamadas en paralelo. Tarde o temprano saltará el límite de la nube y recibirás errores RateExceeded / RequestLimitExceeded.
Para evitar el throttling:
- Acota siempre el alcance con condiciones
WHERE region = '...'oWHERE account_id = '...'; - Aprovecha la caché de consultas integrada en Steampipe (parámetro
cache = onen el archivo de configuración del plugin); - Para escaneos periódicos en CI/CD, ajusta el retardo y la concurrencia entre llamadas a la API (
max_concurrency).
Steampipe demuestra que una buena abstracción arquitectónica ahorra cientos de horas de trabajo tedioso. Convertir la infraestructura en tablas devuelve a los ingenieros el placer de las soluciones simples y elegantes.