November 22 · LongreadGemini 4 Neon vs. Claude Fable 5.2 and GPT-6.2 Astra: A Field Guide to Google's Lead and Its Catch👍 12+6
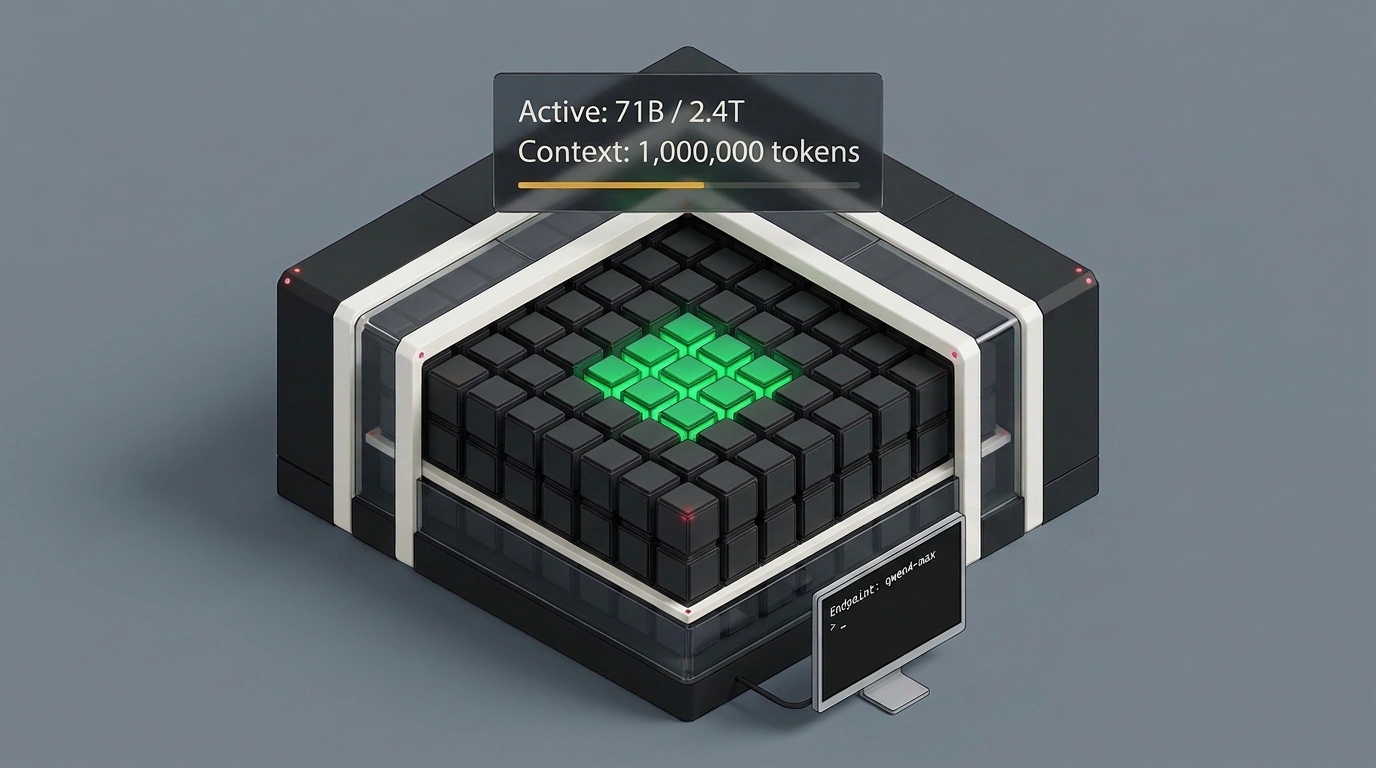
November 22 · NoteAlibaba Qwen 4 Max: 2.4T-Parameter MoE Flagship with 1M Context and Honest Benchmark Limits👍 6
November 21 · NoteIndependent Benchmarks for Gemini 4 Neon: 110 Tokens/s, 65% on Cursor Bench, and Real Codebase Tests👍 10+1
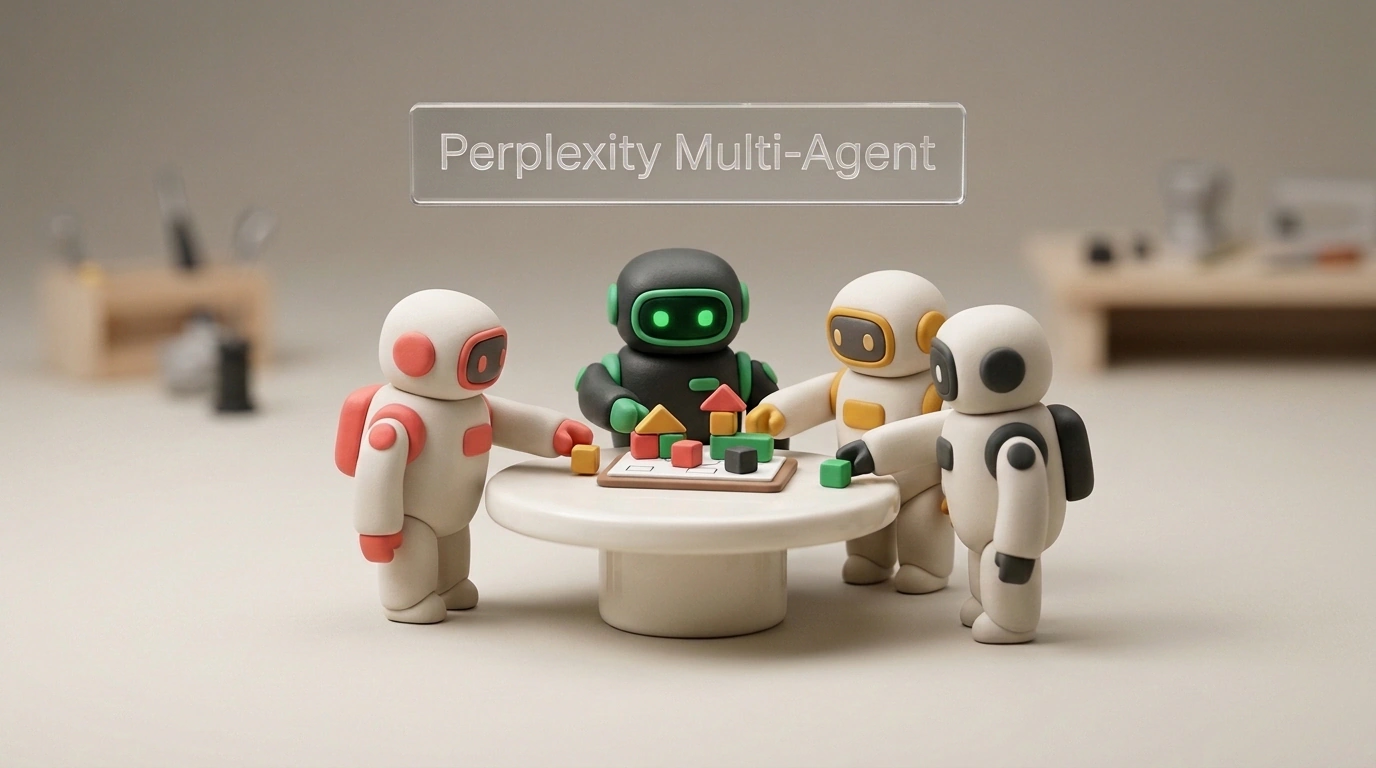
November 20 · NotePerplexity Multi-Agent: How Four Rival AI Models Cross-Check Each Other on One Task👍 17
November 20 · NoteShanghai AI Lab's Sage-S2.1-Flash: An Open-Source Scientific MoE Model That Runs 3D Slicer Itself👍 14
November 20 · BriefA Local 9B Model with DeepSeek Distillation and Heretic v2 Goes Viral on Hugging Face👍 0
November 19 · ArticleGPT-6.2 Astra vs. Claude Fable 5.2 Across 12 Tasks: 7.2x Cheaper, So Why Are Testers Arguing?👍 23+5
November 19 · NoteGPT-6.2 Astra Hits "High" Rating for AI Self-Improvement: What the Model Can Actually Do👍 10+1
November 19 · NoteGemini 4 Hydrogen: How Google's Fast Agent Executor Works and Why It Teams Up With Carbon👍 4
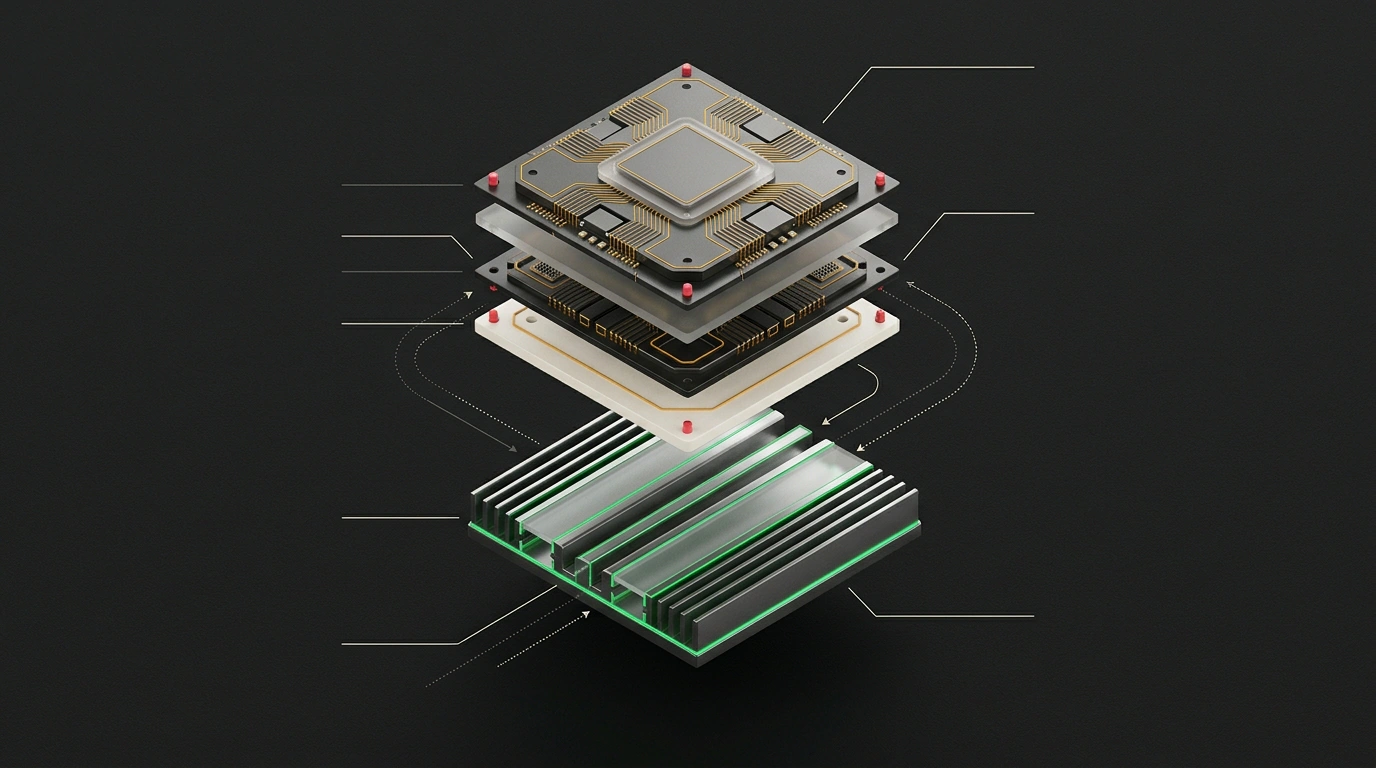
November 19 · NoteTencent HY4 Flash: 224B Parameters, 150+ Tokens/Sec, and Two Free Weeks in Hermes👍 6+1
November 19 · NoteLiquid AI d1.2 and d1.2-ultra: Why Automation Needs Decision Models Instead of Chatbots👍 9
November 19 · NoteWhy AI Models "Get Dumber" After Launch: Anthropic Postmortems and Hidden Effort Settings👍 10
November 18 · ArticleGPT-6.2 Astra and GPT-6.2 Sol Release: Agent Token Economics, Benchmarks vs. Claude Fable 5.2, and Subagent Coordination👍 37
November 18 · ArticleAlibaba's Qwen 4-Max Flagship: 2.4 Trillion Parameters, 1M Token Window, and Cursor and Claude Code Integration👍 27
November 12 · NoteOffline AI Stack on Mac: Running Google Gemma 4 Locally with No Internet and Zero Data Leaks👍 12
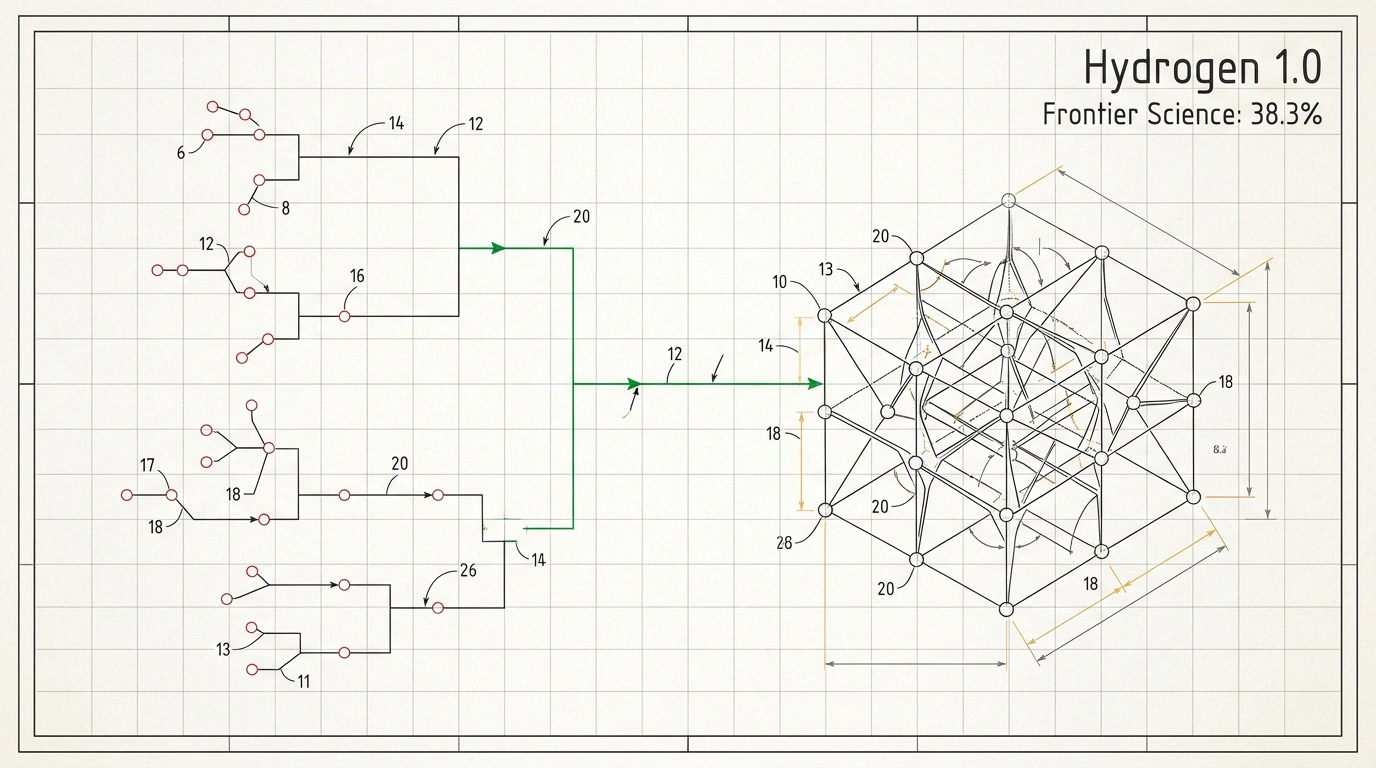
November 9 · NoteDeep Principle's Hydrogen 1.0: Why Training on Scientific Failures Beat Top Closed Models👍 7
November 9 · ArticleLongCat 2.5 Multimodal Model with 1.6 Trillion Parameters: Vision Capabilities and Running in the Hermes Ecosystem👍 18
 +6



 +5
 +1